로봇 학습의 데이터 규모가 빠르게 커지고 있다. Dyna Robotics는 2026년 8월 공개한 Dyna-2를 100만 시간 이상의 사람 시점 영상으로 사전학습했다고 밝혔다. Meta의 V-JEPA 2도 100만 시간이 넘는 인터넷 영상으로 세계의 움직임을 학습한 뒤, 62시간 미만의 로봇 영상으로 실제 로봇 계획까지 연결했다.[^1][^2]
숫자만 보면 로봇도 언어모델처럼 결국 더 많은 데이터를 먹이면 해결될 것처럼 보인다. 하지만 실제 배포 경험은 다른 문제를 드러낸다. Dyna는 앞선 모델이 냅킨 접기 같은 작업에서 99%가 넘는 성공률을 기록했음에도, 고객 현장에서 사람이 거의 개입하지 않는 상태까지 가는 데 수주에서 수개월의 현장 엔지니어링이 필요했다고 회고했다.[^3]
두 사실은 모순되지 않는다. 대규모 영상은 로봇이 세계를 이해하는 기본기를 넓혀주지만, 상업적 신뢰성은 어떤 데이터가 부족한지 현장에서 찾아 다시 학습시키는 별도의 루프에서 만들어진다.
그래서 피지컬 AI의 데이터 경쟁을 단순히 학습시간이나 비디오 개수로 비교하면 중요한 구조를 놓치게 된다. 로봇에게 필요한 데이터는 하나의 덩어리가 아니라 역할이 다른 여러 층으로 나뉜다. 사람의 영상은 물체와 행동에 대한 넓은 사전지식을 만들고, 로봇 데이터는 몸체와 행동 사이의 차이를 메우며, 실제 배포에서 발생한 실패와 회복 데이터는 마지막 몇 퍼센트의 신뢰성을 만든다. 시뮬레이션은 이 사이에서 위험하고 드문 상황을 반복해 검증할 수 있게 한다.
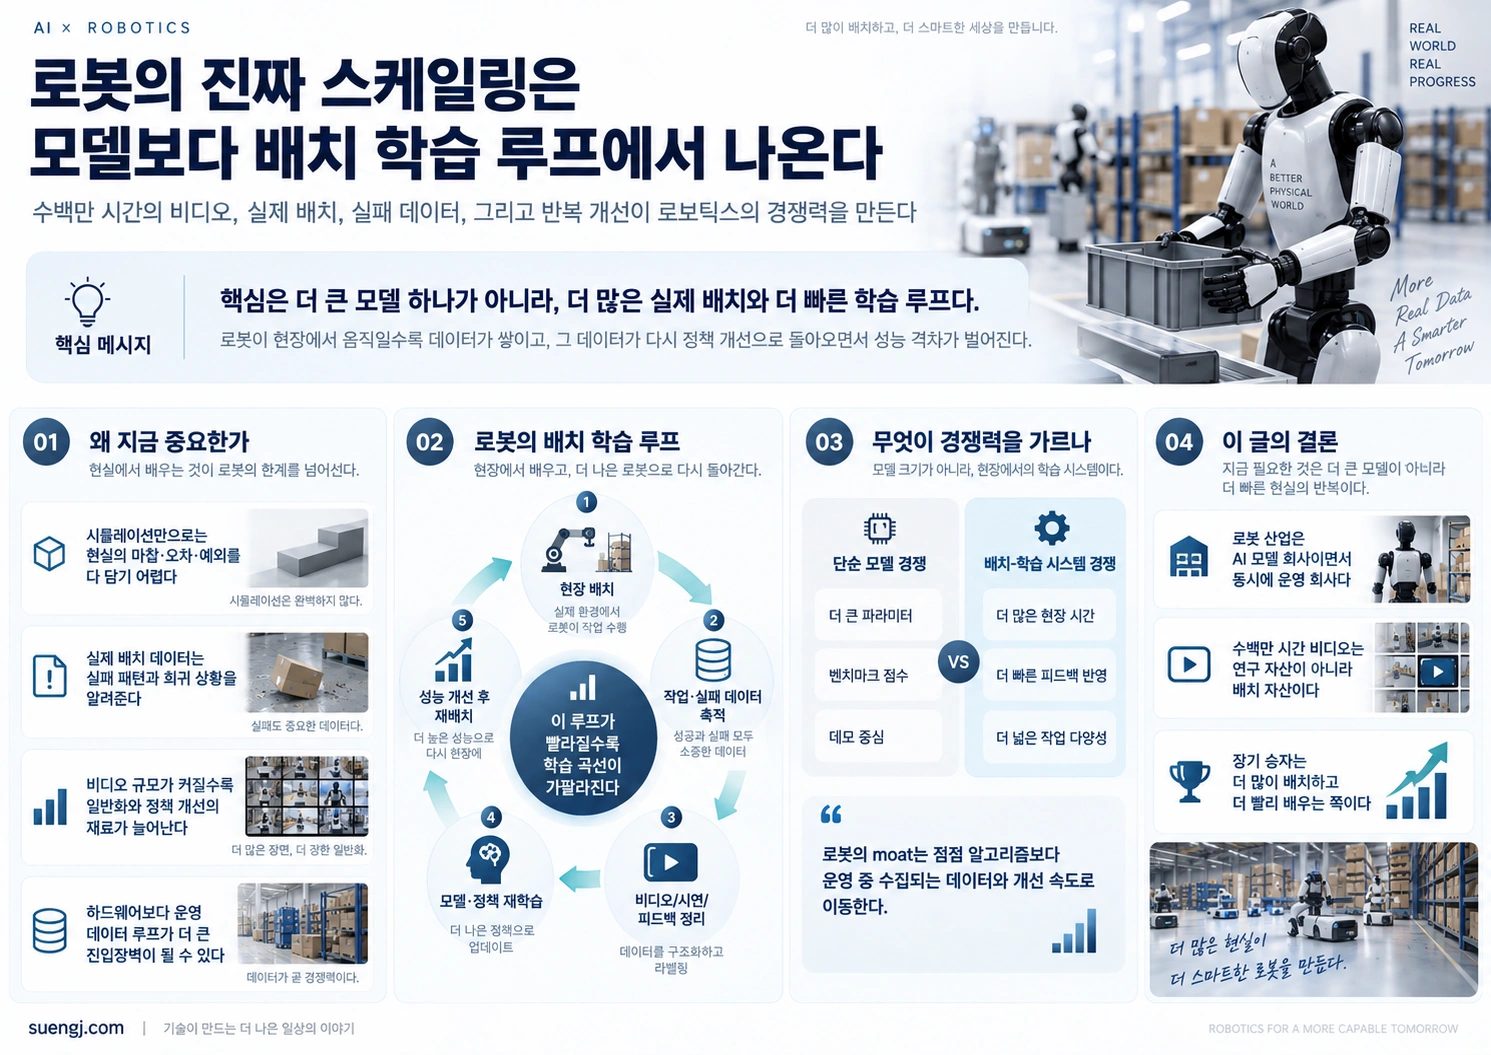
사람의 영상은 로봇에게 더 적은 비용으로 ‘세계의 상식’을 가르칠 수 있다
로봇 데이터는 만들기 어렵다. 카메라 영상만 저장하면 끝나는 것이 아니라 관절 상태, 힘, 위치, 행동 명령처럼 여러 센서와 제어 신호가 시간축에서 맞아야 한다. 로봇을 실제로 움직여 데이터를 만들려면 장비와 공간, 운영 인력도 필요하다.
반면 사람이 무언가를 집고, 접고, 옮기고, 여는 영상은 이미 엄청난 규모로 존재한다. 이 영상에는 정확한 로봇 액션 값은 없지만 물체가 어떻게 움직이고, 접촉 뒤 상태가 어떻게 변하며, 작업이 어떤 순서로 진행되는지에 대한 정보가 담겨 있다.
Dyna-2가 이 방향을 극단적으로 밀어붙인 사례다. 회사는 1천 시간에서 100만 시간까지 사람의 egocentric video를 늘려가며 모델을 학습했고, 사람 영상에서의 성능 향상이 로봇 데이터에 대한 전이 성능과도 함께 개선되는 scaling trend를 보고했다.[^1] 영상 데이터가 단순한 시각 인식용 보조재가 아니라 로봇 행동 모델의 사전학습 자원이 될 수 있다는 주장이다.
Meta의 V-JEPA 2도 비슷한 가능성을 보여준다. 이 모델은 100만 시간 이상의 인터넷 비디오와 이미지로 먼저 학습한 뒤 62시간 미만의 로봇 영상으로 action-conditioned world model을 만들었다. 연구진은 별도의 작업별 훈련 없이 두 연구실의 Franka 로봇팔에서 이미지 목표를 이용한 집기·놓기 계획을 수행했다고 보고했다.[^2]
이 결과에서 중요한 숫자는 100만 시간 자체가 아니다. 비싼 로봇 상호작용 데이터를 만들기 전에, 훨씬 풍부한 인간의 행동 영상으로 물리세계의 prior를 학습할 수 있다는 것이 핵심이다.
하지만 영상에는 로봇이 실제로 무엇을 해야 하는지가 빠져 있다
사람이 컵을 집는 영상은 컵이 어떻게 움직이는지는 보여준다. 그러나 로봇 팔의 어느 관절에 어느 순간 얼마만큼의 힘을 줘야 하는지는 알려주지 않는다.
이 차이가 인간 영상과 로봇 제어 사이의 embodiment gap이다. 카메라 위치도 다르고, 손의 구조도 다르며, 사람에게 자연스러운 동작이 로봇의 관절 구조에서는 비효율적일 수 있다. 영상에는 힘과 마찰, 접촉 실패가 충분히 보이지 않을 수도 있다.
2026년 발표된 video-to-control 연구 정리에서도 이 문제가 핵심 난제로 남아 있다. 인간 영상은 물리적 변화를 대규모로 관찰할 수 있는 자원이지만 action supervision이 없고, 시점·몸체·물리 제약이 로봇 경험과 다르기 때문에 영상에서 얻은 예측을 신뢰할 수 있는 제어로 연결하는 integration layer가 가장 어려운 부분 가운데 하나로 지적된다.[^4]
이 때문에 “인터넷에 영상이 많으니 로봇 데이터 문제도 끝났다”는 결론은 성급하다. 대규모 영상은 학습해야 할 세계를 넓혀주지만, 실제 로봇이 그 세계에서 행동하려면 다시 자신의 몸과 센서에 맞는 데이터가 필요하다.
여기서 데이터의 가치는 양보다 어떤 불확실성을 줄이는가로 달라진다. 모델이 이미 수천 번 본 정상적인 집기 동작을 한 번 더 추가하는 것보다, 특정 재질에서 그립이 미끄러지는 순간이나 물체가 예상과 다르게 변형되는 사례 하나가 더 유용할 수 있다.
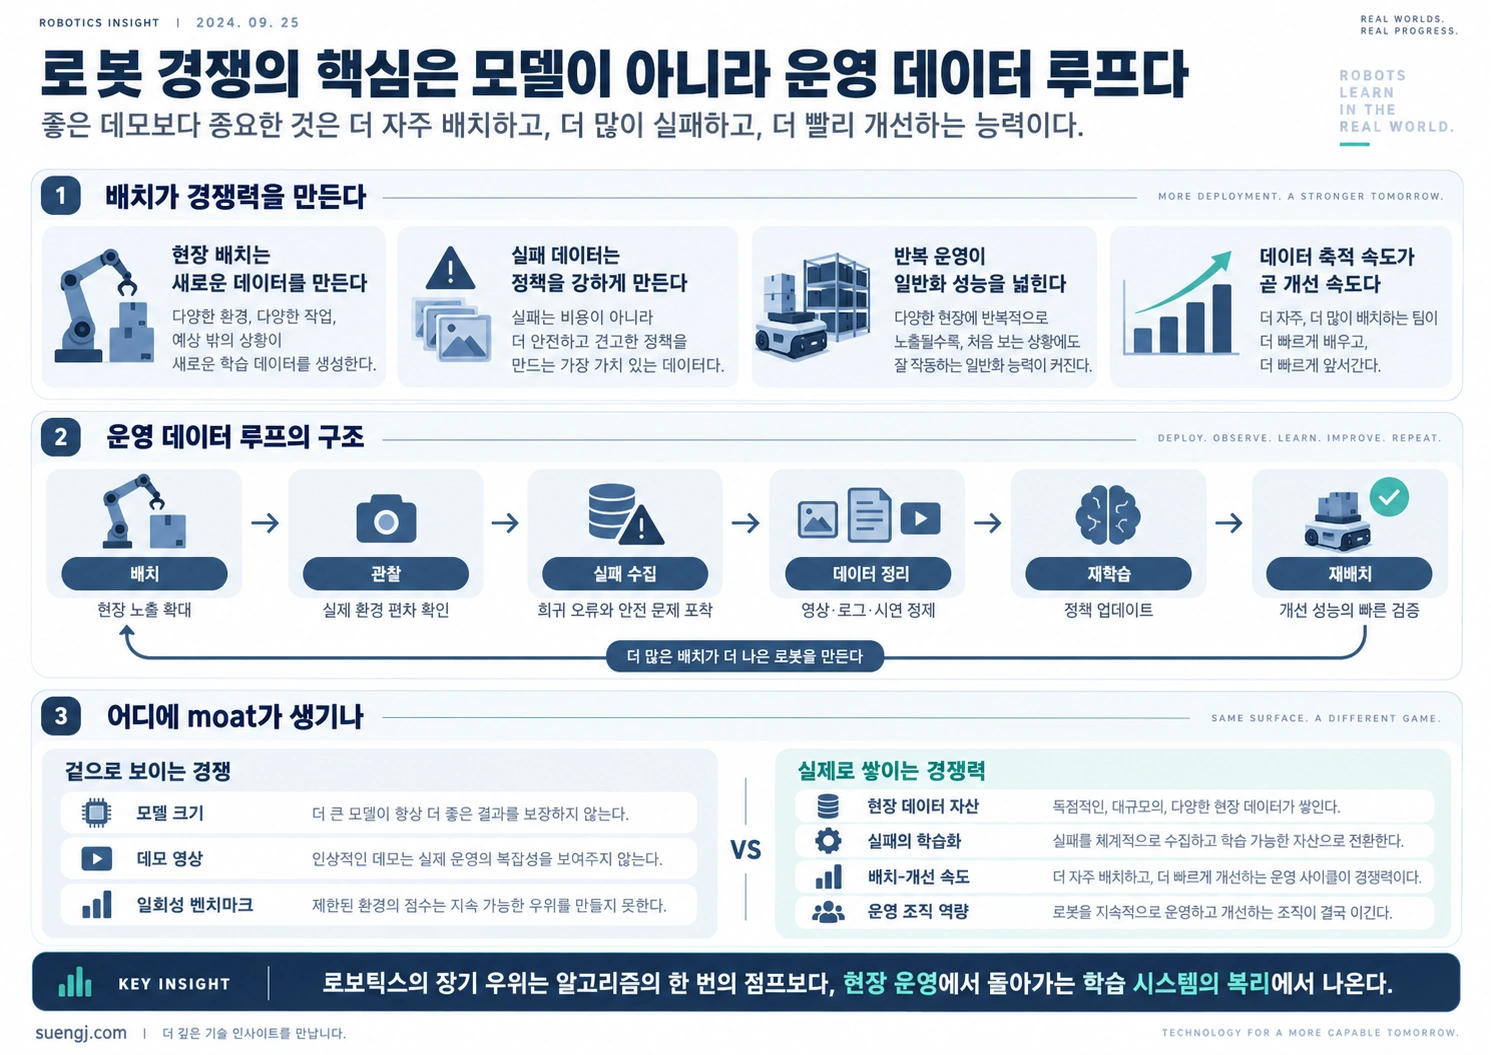
상용화 단계에서는 성공 데이터보다 실패 데이터의 가치가 커진다
연구 데모에서는 한 번 성공하는 장면이 중요하다. 실제 사업에서는 같은 일을 하루 종일 반복했을 때 실패가 얼마나 적고, 실패 뒤 스스로 얼마나 잘 복구하는지가 중요하다.
Dyna가 공개한 생산환경 경험은 이 차이를 잘 보여준다. 회사는 초기 DYNA-1이 실제 작업에서 99% 이상의 성공률을 보여 이미 강한 모델이라고 판단했지만, 배포 이후에는 설치·하드웨어·모델·운영 문제가 서로 얽히면서 고객마다 수주에서 수개월의 엔지니어링이 필요했다고 설명한다.[^3]
99%라는 숫자도 반복 작업에서는 다르게 보인다. 한 작업을 하루에 수천 번 수행하면 1%의 실패는 계속 사람을 호출하는 운영비가 된다. 게다가 실패는 균등하게 생기지 않는다. 특정 조명, 물체 위치, 재질, 장비 편차처럼 모델이 약한 조건에 몰릴 수 있다.
그래서 현장 배포는 단순한 최종 시험이 아니라 새로운 데이터 수집 단계가 된다. 어떤 실패가 반복되는지 찾고, 그 실패 전후의 영상을 모으고, 회복 동작을 추가한 뒤 다시 모델을 업데이트한다. 이미 잘하는 정상 사례를 무작정 더 모으는 것보다 모델의 약점이 드러난 순간을 선택적으로 학습하는 편이 마지막 신뢰성을 높이는 데 더 직접적이다.
Dyna가 최근 공개한 Dyna-2도 데이터 규모를 100만 시간까지 늘렸지만, 회사 홈페이지는 여전히 실제 배포가 전체 fleet를 강화하는 피드백 원천이라고 설명한다.[^5] 대규모 사전학습과 현장 학습은 서로 대체하는 선택지가 아니라 다른 역할을 맡는 셈이다.
시뮬레이션의 역할도 ‘현실을 대신하는 것’보다 검증에 가깝다
실세계 데이터만으로 모든 실패를 수집하는 데에는 한계가 있다. 충돌이나 장비 파손처럼 위험한 상황은 일부러 반복하기 어렵고, 드물게 발생하는 예외상황은 충분한 표본을 얻는 데 시간이 오래 걸린다.
그래서 world model과 simulation이 중요해진다. NVIDIA는 Cosmos 3를 물리적 장면을 이해하고 미래 상태를 생성하며 action trajectory까지 다룰 수 있는 physical AI foundation model로 설계했다. 회사는 Cosmos를 로봇·자율주행 시스템의 합성 데이터 생성과 정책 평가에 활용할 수 있다고 설명한다.[^6]
여기서 시뮬레이션의 가장 실용적인 가치는 현실을 완벽하게 복제하는 데 있지 않다. 실제로는 만들기 비싸거나 위험한 조건을 반복하고, 한 정책이 어떤 상황에서 무너지는지 비교하며, 모델 업데이트 전후의 차이를 같은 조건에서 측정할 수 있다는 점이 더 중요하다.
다시 말해 시뮬레이션은 데이터 생산기이면서 동시에 검증 가능한 실패 실험실이다. 현실에서 발견한 약점을 시뮬레이션에서 변형해 수백 번 시험하고, 충분히 안정된 정책만 다시 현장으로 보내는 식의 루프를 만들 수 있다.
물론 시뮬레이션이 현실을 전부 대신할 수는 없다. 마찰, 변형 물체, 센서 노이즈, 사람의 예상 밖 행동처럼 실제 세계의 분포를 완벽히 재현하기 어렵기 때문이다. 그래서 synthetic data가 커질수록 오히려 real-world deployment가 제공하는 calibration 역할이 중요해진다.
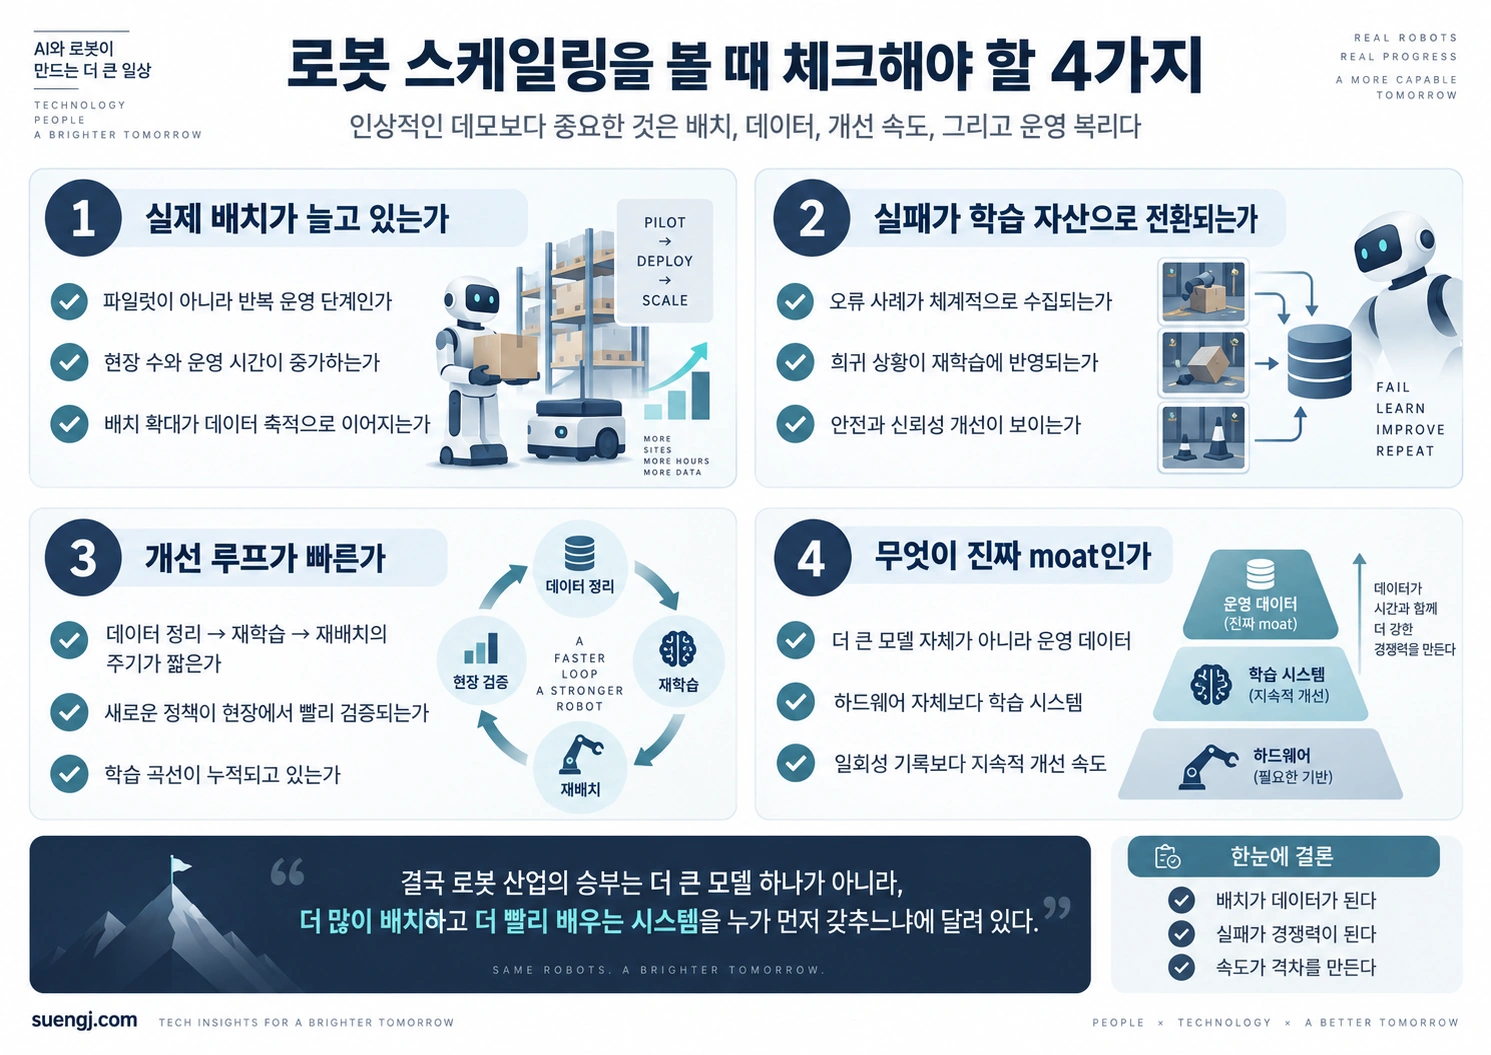
결국 경쟁력은 ‘데이터를 얼마나 갖고 있나’보다 루프가 얼마나 빨리 닫히나에서 나온다
피지컬 AI 기업을 볼 때 총 데이터 시간은 여전히 의미가 있다. 큰 데이터셋은 범용 표현을 만들고 새로운 작업에 필요한 추가 학습량을 줄일 수 있다. 그러나 그 숫자만으로 실제 배포 능력을 추정하기는 어렵다.
더 중요한 질문은 데이터가 어떤 순환구조 안에서 쓰이는가다.
사람의 대규모 영상으로 물리적 prior를 만든다. 소량의 로봇 상호작용 데이터로 그 지식을 실제 몸체의 action space에 맞춘다. 현장에서 실패와 회복 사례를 수집해 약한 부분을 찾는다. 시뮬레이션과 평가환경에서 그 약점을 반복 검증한다. 개선된 모델을 다시 배포하고 새로운 failure distribution을 관찰한다.
이 루프가 짧을수록 같은 로봇 수와 같은 현장 수에서도 더 빨리 신뢰성을 높일 수 있다. 반대로 데이터는 많지만 실패를 분류하지 못하고, 모델 업데이트가 실제 현장의 개선으로 이어졌는지 확인하지 못한다면 저장된 영상의 규모는 경쟁우위가 되기 어렵다.
이 관점은 기존의 “로봇 한 대가 얼마나 싸고 많은 작업을 처리하는가”라는 경제성 질문과도 구분된다. 경제성이 최종 결과라면, 여기서 보는 것은 그 결과를 개선하는 학습 시스템의 구조다.
앞으로 확인해야 할 지표도 조금 달라진다. 총 학습시간 외에 새로운 현장에서 추가 데이터가 얼마나 필요한지, 실패 하나를 감지해 재학습 데이터로 전환하는 데 얼마나 걸리는지, 모델 업데이트 뒤 같은 실패가 얼마나 줄었는지, 다른 현장에서 배운 회복 전략이 얼마나 이전되는지를 봐야 한다.
이 판단이 틀렸다고 볼 조건도 명확하다. 범용 world-action model이 새로운 현장에 거의 별도 적응 없이 들어가 장기간 높은 성공률을 유지하고, 하드웨어가 달라도 추가 로봇 데이터나 현장 피드백 없이 안정적으로 일반화한다면 targeted deployment loop의 중요성은 빠르게 줄 수 있다.
지금까지의 증거는 반대 방향이다. 백만 시간의 영상은 로봇의 시작점을 크게 높이고 있지만, 실제 신뢰성은 여전히 현장에서 무엇이 틀렸는지 발견하고 그 실패를 다시 학습하는 능력에서 완성되고 있다.
Sources
[^1]: Dyna Robotics, Dyna-2: A 1-Million-Hour Scaling Law for World-Action Models, August 2026 [^2]: Meta AI, V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning, 2025-06-11 [^3]: Dyna Robotics, What 10 Months in Production Taught Us About the Robotics “Bubble”, 2026 [^4]: Zheng et al., From Video to Control: A Survey of Learning Manipulation Interfaces from Temporal Visual Data, 2026 [^5]: Dyna Robotics, Commercial-Grade Robots for the Real World [^6]: NVIDIA, NVIDIA Launches Cosmos 3, the Open Frontier Foundation Model for Physical AI, 2026-05-31