9월 말 공개된 Marathoner는 90억 파라미터 모델이 어려운 소프트웨어 작업에서 10시간 넘게 실행되고 1,000회가 넘는 도구 호출을 이어갈 수 있다고 보고했다. 연구진이 더 흥미롭게 본 지점은 실행시간 자체가 아니다. 긴 작업의 후반부까지 실제 문제를 풀어가는 행동을 계속 하도록 별도의 보상을 넣었다는 점이다.[^1]
최근 프런티어 모델도 비슷한 방향으로 움직인다. OpenAI가 공개한 GPT-6 Astra는 OSWorld 2.0에서 72.6%, AutomationBench에서 41.4%를 기록했고, 게임 개발 사례에서는 Unity·Godot 안에서 장면을 수정한 뒤 직접 플레이하고 테스트하며 이전 모델보다 수동 수정 횟수를 절반가량 줄였다고 회사가 밝혔다.[^2][^3]
이런 결과를 보면 AI의 다음 경쟁을 “얼마나 오래 혼자 일할 수 있는가”로 읽기 쉽다. 하지만 오래 켜져 있는 것과 긴 업무를 끝까지 진전시키는 것은 다른 능력이다. 장기 에이전트의 핵심 병목은 컨텍스트 창의 크기나 단순한 실행시간보다, 수백 번의 판단과 도구 호출을 거친 뒤에도 목표를 잃지 않고 유효한 진전을 계속 만드는 데 있다.
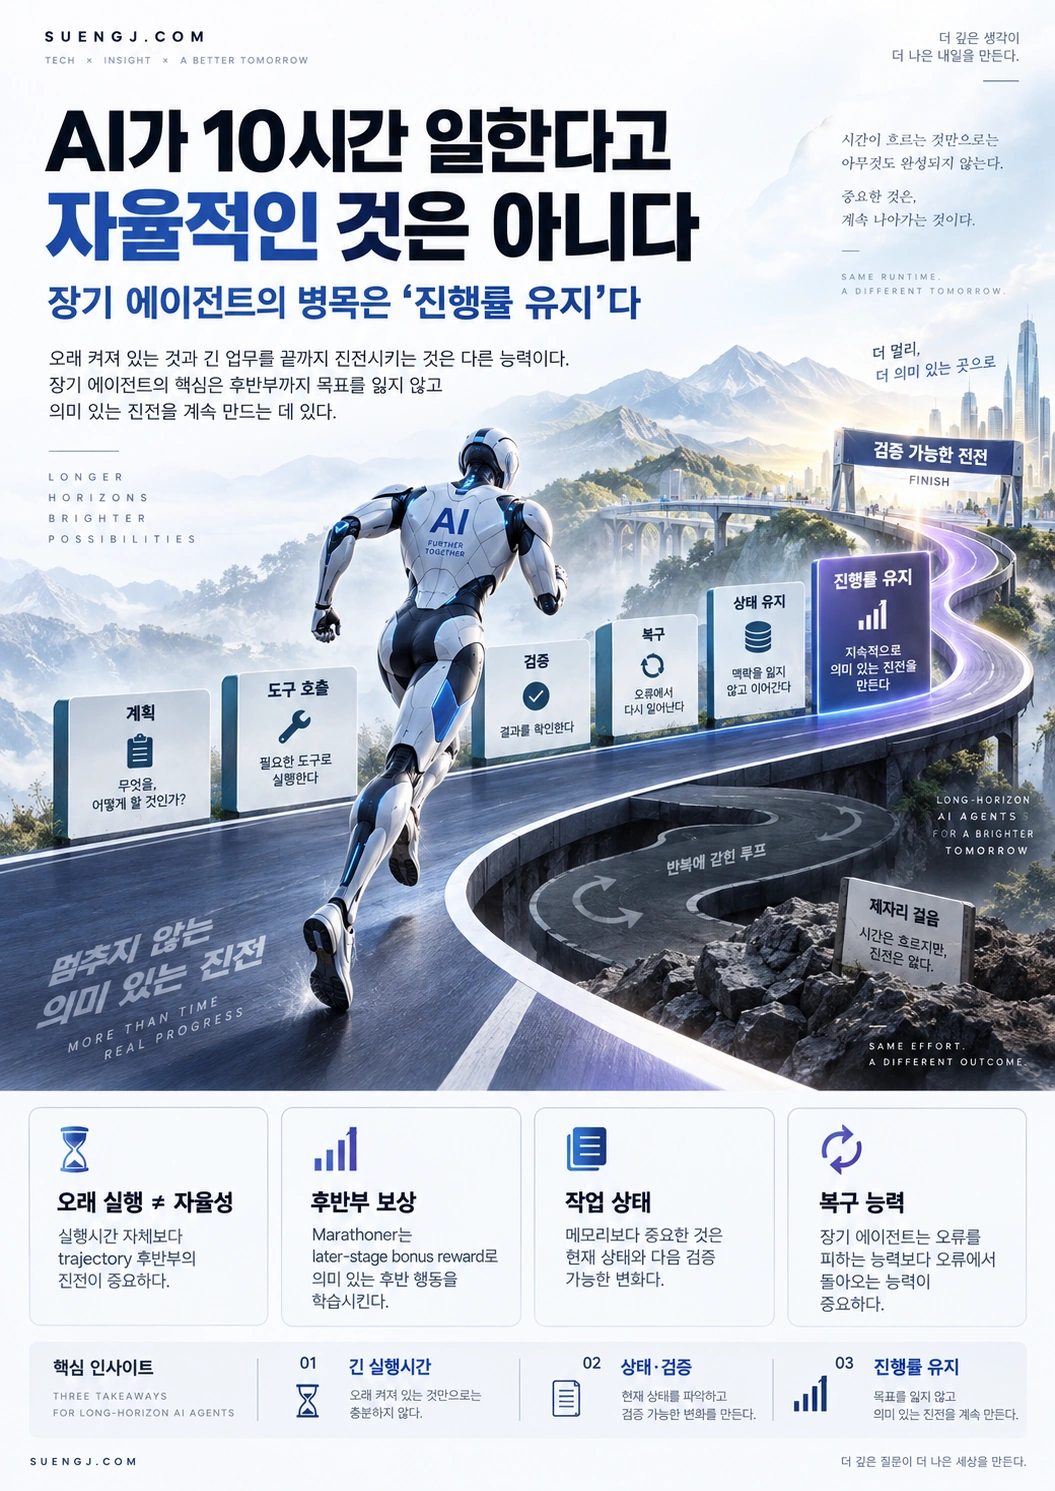
긴 작업에서는 작은 오류보다 ‘진전이 멈추는 방식’이 더 중요해진다
짧은 작업은 실패가 비교적 명확하다. 코드를 한 번 잘못 수정하거나 도구를 잘못 호출하면 즉시 오류가 나고 다시 시도하면 된다.
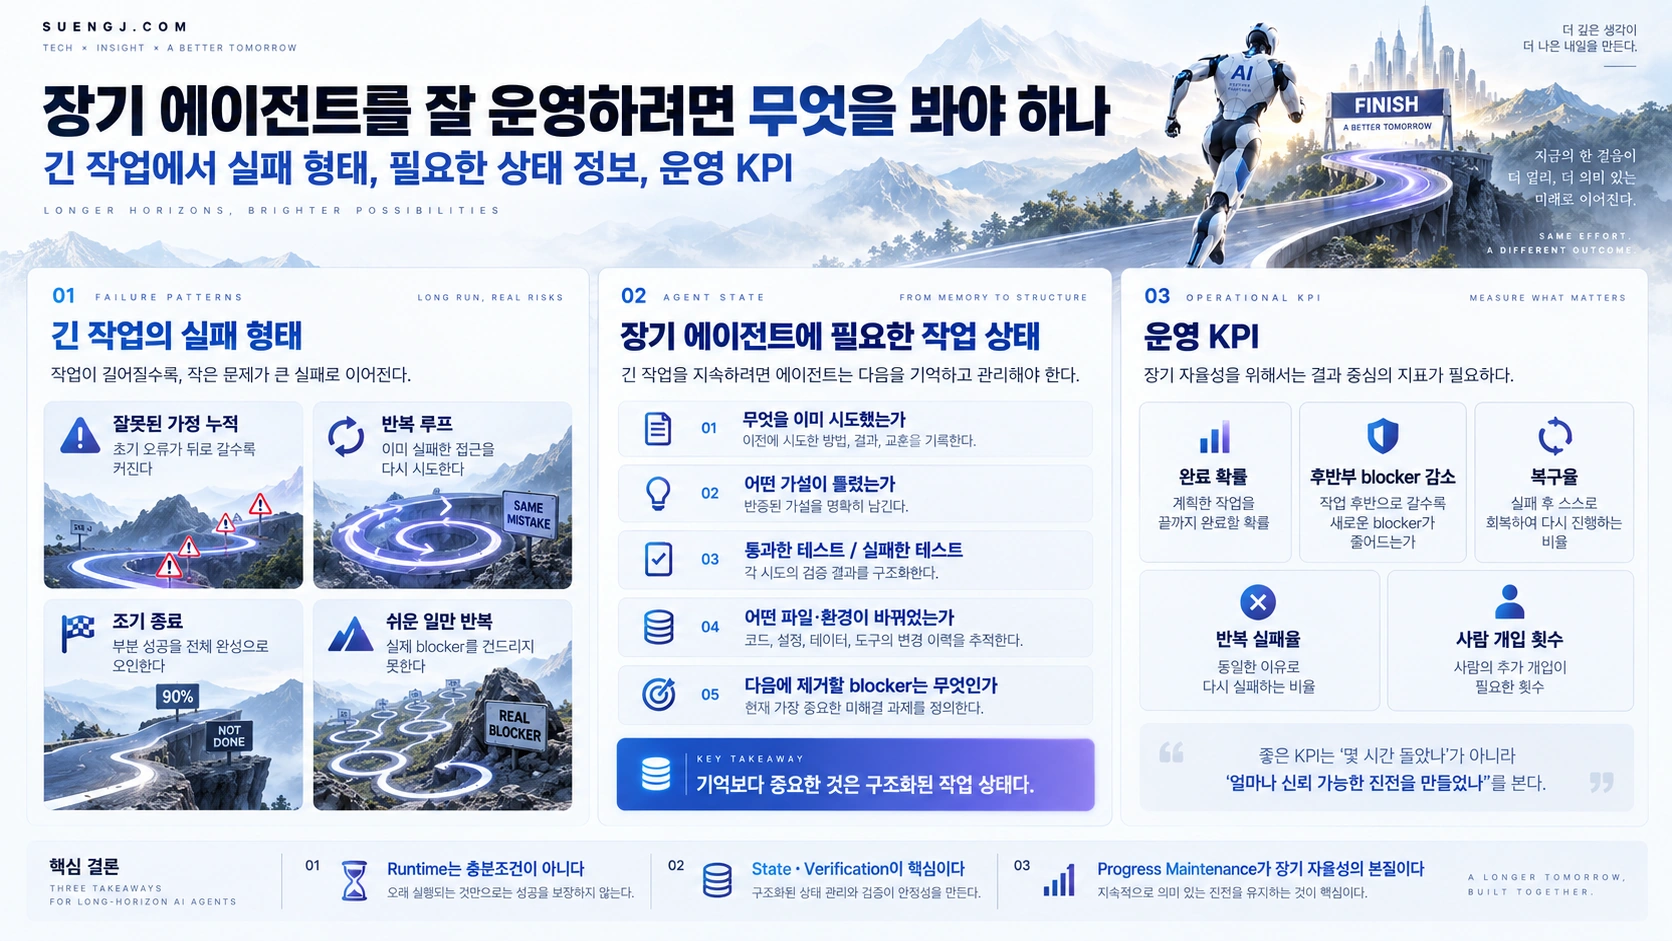
작업이 길어지면 실패의 형태가 달라진다. 에이전트가 잘못된 가정을 세운 뒤 그 위에서 수십 단계를 진행할 수 있다. 이미 시도한 해결책을 잊고 반복하거나, 쉬운 하위 문제만 계속 다듬으면서 실제 blocker를 건드리지 않을 수도 있다. 테스트 일부를 통과한 상태를 완성으로 오인해 너무 일찍 멈추는 경우도 있다.
이 문제는 각 단계의 평균 정확도만 높여서는 완전히 해결되지 않는다.
가령 한 단계가 99% 확률로 올바르게 진행된다고 단순 가정해도, 100개의 독립적인 단계가 모두 올바를 확률은 약 37%다. 실제 에이전트 작업의 오류는 독립적이지 않고, 중간 검증과 복구가 존재하기 때문에 이 계산을 그대로 현실의 성공률로 볼 수는 없다. 그래도 장기 작업에서 왜 오류를 한 번도 내지 않는 능력보다 오류를 발견하고 다시 목표 쪽으로 돌아오는 능력이 중요해지는지는 보여준다.
긴 작업은 결국 하나의 거대한 정답을 생성하는 문제가 아니다. 상태를 바꾸고, 결과를 관찰하고, 계획을 수정하는 작은 폐쇄루프가 수백 번 이어지는 문제다.
Marathoner가 바꾼 것은 모델 크기보다 ‘학습시킬 작업의 모양’이다
Marathoner 연구에서 눈에 띄는 첫 번째 선택은 어려운 질문을 더 많이 만드는 대신 오래 걸릴 수밖에 없는 작업 구조를 만들었다는 점이다.
연구진은 1만 개 GitHub 저장소에서 10만 개의 주요 release PR을 수집했다. 새 코드가 1,000줄을 넘는 PR은 어려운 작업으로 분류했고, 저장소를 해당 PR 직전 상태로 되돌린 뒤 새 기능을 다시 구현하도록 했다. 실행환경도 의존성이 미리 설치되지 않은 Ubuntu sandbox로 구성해 환경 설정부터 직접 처리하게 했다.[^1]
여기까지라면 난도가 높은 코딩 benchmark와 크게 다르지 않아 보인다. 핵심은 그다음이다.
연구진은 서로 다른 저장소의 작업 다섯 개를 하나의 과제로 연결하는 Multi-Task Chaining을 추가했다. 한 저장소에서 한 문제를 해결한 뒤 끝나는 대신, 여러 코드베이스를 오가면서 독립적인 목표를 계속 처리해야 한다. 작업이 길어지는 이유를 단순히 토큰을 더 많이 쓰게 해서가 아니라 완료해야 할 상태 전환을 여러 개 이어 붙이는 방식으로 만든 것이다.[^1]
이 차이는 중요하다. 장기 에이전트를 훈련하려면 “오래 생각하라”는 지시보다, 중간에 몇 개의 목표를 달성해도 전체 과제가 끝나지 않는 환경이 필요하다는 뜻이기 때문이다.
최종 정답만 보상하면 에이전트는 후반부에 무너질 수 있다
Marathoner의 두 번째 선택은 보상의 위치다.
일반적인 코딩 agent 평가에서는 마지막에 테스트를 모두 통과했는지 확인하기 쉽다. 성공이면 1, 실패면 0이다. 이 방식은 최종 결과를 명확하게 평가할 수 있다는 장점이 있지만, 10시간짜리 trajectory에서 어느 구간의 행동이 성공에 실제로 기여했는지는 거의 알려주지 않는다.
연구진은 이를 보완하기 위해 Later Stage Bonus Reward를 넣었다. 전체 trajectory를 여러 단계로 요약한 뒤, 실행 후반부에서 숨은 버그를 찾아 고치거나 핵심 최적화를 수행하는 등 의미 있는 진전이 확인되면 추가 보상을 주는 방식이다. 최종 correctness reward와 별도로 “오래 실행된 뒤에도 가치 있는 행동을 계속했는가”를 학습 신호로 만든 셈이다.[^1]
이 설계가 말해주는 것은 장기 에이전트의 문제가 단순한 인내심이 아니라는 점이다.
초반 20%에서 좋은 계획을 세운 뒤 남은 80%를 반복 작업으로 보내는 에이전트는 오래 실행됐지만 장기 자율성이 높은 것이 아니다. 반대로 중간에 가설이 틀렸다는 증거를 발견하고, 접근법을 바꾸고, 마지막 단계에서 새로운 blocker를 해결했다면 실행시간이 같아도 전혀 다른 trajectory다.
그래서 장기 작업에서는 “몇 시간 돌아갔는가”보다 후반부에도 정보가 늘고 상태가 개선되고 있는가가 더 중요한 지표가 된다.
9B 모델의 결과는 흥미롭지만 ‘프런티어 모델을 이겼다’고 읽으면 과장이다
Marathoner의 결과는 specialized post-training이 작은 모델의 장기 실행 능력을 크게 끌어올릴 수 있다는 점에서 의미가 있다.
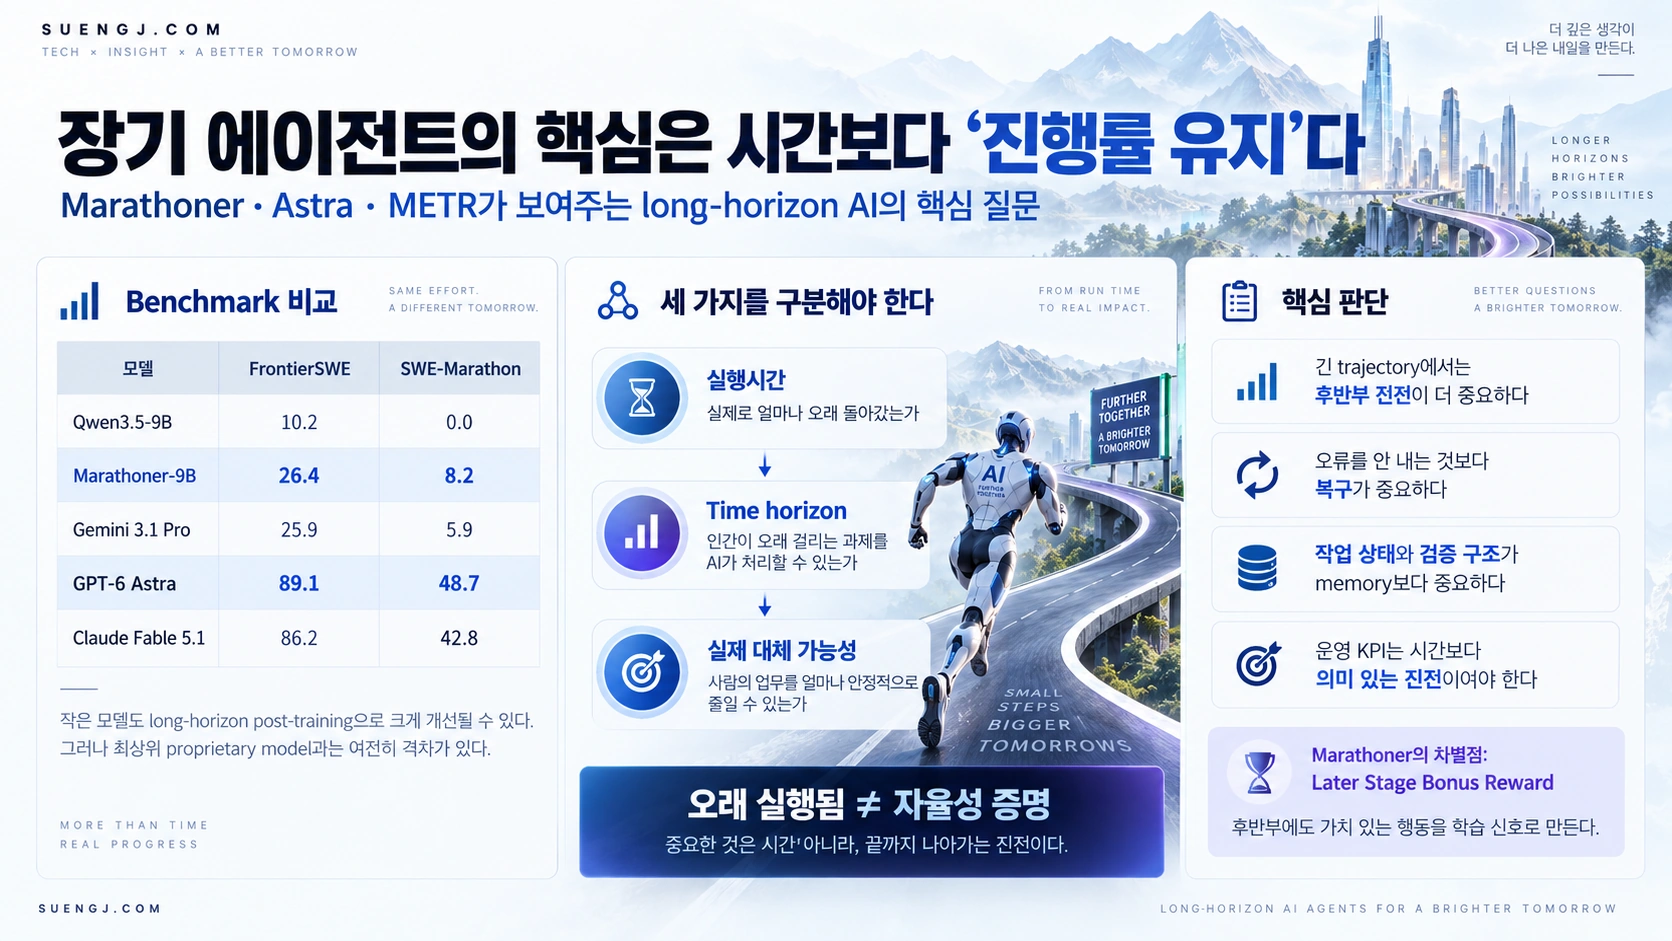
논문 표에 따르면 기본 Qwen3.5-9B는 FrontierSWE 10.2점, SWE-Marathon 0점을 기록한 반면 Marathoner-9B는 각각 26.4점과 8.2점을 기록했다. 같은 표에서 Gemini 3.1 Pro는 25.9점과 5.9점으로 Marathoner보다 낮았다.[^1]
하지만 현재 최상위 proprietary model과 비교하면 이야기가 달라진다.
| 모델 | FrontierSWE | SWE-Marathon |
|---|---|---|
| Qwen3.5-9B | 10.2 | 0.0 |
| Marathoner-9B | 26.4 | 8.2 |
| Gemini 3.1 Pro | 25.9 | 5.9 |
| GPT-6 Astra | 89.1 | 48.7 |
| Claude Fable 5.1 | 86.2 | 42.8 |
즉 “9B 모델이 프런티어를 넘어섰다”기보다, 장기 작업에 맞는 task synthesis와 post-training이 같은 크기의 base model에서 큰 차이를 만들었고 일부 강한 모델을 특정 benchmark에서 넘어섰다고 읽는 편이 정확하다.
이 구분은 실무에서도 중요하다. 장기 에이전트의 성능을 모델 크기 하나로 설명하면 다음 모델을 기다리는 것이 전략이 된다. 반대로 작업 구조와 reward, harness가 중요하다면 현재 모델로도 개선할 수 있는 engineering surface가 생긴다.
‘Time horizon’과 실제 실행시간을 섞으면 판단이 틀어진다
장기 에이전트를 설명할 때 또 하나 주의해야 할 용어가 time horizon이다.
METR의 task-completion time horizon은 AI가 실제로 몇 시간 동안 켜져 있었는지를 뜻하지 않는다. 인간 전문가가 완료하는 데 X시간 걸리는 과제를 AI가 특정 성공확률로 처리할 수 있는가를 나타내는 지표다. METR도 2026년 별도 설명에서 time horizon은 “AI가 독립적으로 일하는 시간”이 아니라고 명시했다.[^4][^5]
예를 들어 8시간 time horizon을 가진 모델이 반드시 8시간 동안 자율 실행한다는 뜻은 아니다. 인간에게 8시간 걸리는 과제를 AI는 훨씬 짧은 wall-clock time 안에 끝낼 수도 있다. 반대로 agent harness가 10시간 동안 계속 실행됐다고 해서 인간 10시간짜리 업무를 50% 신뢰도로 대체한다는 뜻도 아니다.
이 둘을 구분해야 세 가지 서로 다른 질문을 분리할 수 있다.
첫째, 모델은 얼마나 복잡한 과제를 해결할 수 있는가.
둘째, agent는 실제 환경에서 얼마나 오래 상태를 유지하며 실행할 수 있는가.
셋째, 그 긴 실행이 사람의 일을 얼마나 안정적으로 줄이는가.
지금의 benchmark와 사례는 첫째와 둘째가 빠르게 개선되고 있음을 보여준다. 셋째는 훨씬 더 어려운 문제다.
METR도 최신 time-horizon 측정에서 16시간을 넘는 구간은 현재 task suite로 신뢰하기 어렵다고 표시하고 있다.[^4] 긴 업무 능력이 빠르게 늘고 있다는 큰 방향과 특정 모델의 “몇 시간” 숫자를 같은 확신도로 다루면 안 되는 이유다.
실제 운영에서는 ‘기억’보다 작업 상태가 더 구체적이어야 한다
에이전트가 긴 작업을 하려면 과거 내용을 기억해야 한다. 하지만 메모리를 단순히 대화 요약으로 이해하면 부족하다.
장기 작업에서 필요한 것은 작업 상태다.
무엇을 이미 시도했는지, 어떤 가설이 틀렸는지, 현재 통과한 테스트와 실패한 테스트는 무엇인지, 어떤 파일이 바뀌었는지, 아직 검증하지 않은 위험은 무엇인지, 다음 행동이 어떤 blocker를 제거하려는 것인지가 남아 있어야 한다.
이 정보가 없으면 컨텍스트 창이 아무리 커도 같은 실수를 반복할 수 있다. 반대로 작업 상태가 잘 구조화돼 있으면 일부 대화 기록이 압축되더라도 실행을 이어가기 쉽다.
OpenAI의 Playco 사례가 흥미로운 것도 이 때문이다. Astra가 Unity와 Godot 안에서 코드를 생성하는 데서 끝나지 않고, 장면을 수정한 뒤 게임을 직접 실행하고 결과를 확인할 수 있게 했다. 생성 → 실행 → 관찰 → 수정의 루프가 닫혀 있으니 모델은 자신의 출력이 실제 환경에서 어떤 상태를 만들었는지 다시 입력으로 받을 수 있다.[^3]
장기 자율성에 필요한 메모리는 결국 “무슨 말을 했는지”보다 현재 세계가 어떤 상태이고 다음 검증 가능한 변화가 무엇인지를 보존하는 쪽에 가깝다.
모델이 오래 일할수록 사람의 역할도 ‘지시’에서 ‘작업 그래프 설계’로 이동한다
장기 에이전트가 충분히 좋아진다고 해서 사람이 사라지는 것은 아니다. 오히려 사람의 병목이 다른 곳으로 이동할 가능성이 크다.
METR는 2026년 3월, 가상의 200시간 time-horizon AI를 사용할 수 있다고 가정한 워크플로 실험을 진행했다. 연구자들이 예상한 문제는 agent 실행속도가 아니었다. 우선순위를 정하고, 여러 agent가 만든 결과를 이해하고, 외부 피드백과 실험처럼 병렬화하기 어려운 단계를 기다리는 일이 새로운 병목으로 나타났다.[^6]
이 관찰은 장기 에이전트의 운영 구조를 생각할 때 유용하다.
에이전트 하나에게 “끝날 때까지 알아서 해”라고 시키는 대신, 어떤 상태에서 다음 단계로 넘어갈 수 있는지 정의하고, 긴 작업을 서로 검증 가능한 subtask로 나누며, 외부 피드백이 필요한 지점을 명시하는 편이 낫다. 작업이 길어질수록 prompt의 문장보다 작업 그래프와 acceptance condition이 중요해진다.
여기서 manager-agent 구조도 의미가 생긴다. manager가 단순히 worker에게 일을 분배하는 것이 아니라, 각 단계의 완료 증거를 읽고 다음 작업을 열어주는 역할을 한다면 긴 trajectory를 여러 개의 짧고 검증 가능한 구간으로 바꿀 수 있다.
장기 에이전트의 KPI는 ‘몇 시간 돌았나’가 아니어야 한다
10시간, 1,000 tool calls 같은 숫자는 눈에 잘 띈다. 하지만 운영 KPI로 쓰면 쉽게 왜곡된다. 오래 실행하고 더 많은 도구를 호출하는 것이 목적이 될 수 있기 때문이다.
더 유용한 지표는 다음과 같은 질문에 가깝다.
- 같은 난도의 과제를 끝까지 완료하는 확률이 얼마나 되는가.
- 실행 중반 이후에도 blocker를 실제로 줄이고 있는가.
- 잘못된 경로에 들어갔을 때 스스로 탐지하고 복구하는가.
- 이미 실패한 접근을 얼마나 자주 반복하는가.
- 사람의 개입은 몇 번 필요했고, 개입 한 번당 얼마나 큰 방향 수정이 필요했는가.
- 최종 결과가 독립적인 테스트나 외부 환경에서 검증되는가.
이 지표들은 장기 실행을 “시간”이 아니라 신뢰 가능한 진전의 연속성으로 본다.
중요한 것은 무조건 agent를 더 오래 풀어두는 것이 아니다. 오히려 실행이 길어질수록 중간의 상태와 증거를 더 잘 구조화해야 한다.
이 가설이 틀릴 수 있는 조건도 있다
Marathoner는 장기 실행에 특화된 post-training이 큰 개선을 만들 수 있다는 사례지만 아직 하나의 연구 결과다. 논문의 task distribution은 소프트웨어 엔지니어링에 집중돼 있고, reward verifier도 테스트가 명확한 환경에 유리하다. 계약 협상, 조직 변화, 전략 수립처럼 성공 조건이 모호한 업무에 같은 방법이 그대로 통할지는 알 수 없다.
또한 모델 자체의 장기 실행 훈련보다 외부 orchestration이 더 중요할 수도 있다. 짧은 horizon에서 안정적인 여러 agent를 manager가 조율하고, 상태와 검증을 외부 시스템이 맡기는 구조가 하나의 장기 모델보다 비슷하거나 더 높은 신뢰도를 낸다면 specialized long-horizon post-training의 가치는 줄어든다.
반대로 Marathoner와 이후 연구에서 같은 패턴이 반복된다면 의미는 커진다. task를 길게 만드는 방법, 후반부의 진전을 보상하는 방법, 실패 뒤 회복을 학습시키는 방법이 모델 크기와 별개의 핵심 연구축으로 자리잡을 수 있다.
현재 증거로 가장 안전하게 말할 수 있는 것은 이 정도다.
AI 에이전트의 다음 도약은 단순히 더 오래 실행되는 데 있지 않다. 긴 trajectory의 후반부까지 목표와 상태를 유지하고, 틀린 길에서 돌아오며, 검증 가능한 진전을 계속 만드는 능력이 별도의 학습·평가 대상이 되고 있다.
앞으로 “이 agent가 몇 시간 일했는가”라는 숫자를 볼 때는 한 가지를 더 물어봐야 한다.
그 시간 동안 실제로 무엇이 앞으로 나아갔는가.
[^1]: Zhang Ruiyang et al., “Marathoner: Ultra-Long-Horizon Autonomous Intelligence,” arXiv, September 28, 2026. https://arxiv.org/abs/2609.34378 [^2]: OpenAI, “GPT-6 Astra: A new generation of intelligence,” September 3, 2026. https://openai.com/index/gpt-6-astra/ [^3]: OpenAI, “Playco cut manual fixes 50% prototyping games with GPT-6 Astra,” September 3, 2026. https://openai.com/index/playco-game-prototyping-with-astra/ [^4]: METR, “Task-Completion Time Horizons of Frontier AI Models,” updated May 8, 2026. https://metr.org/time-horizons/ [^5]: Thomas Kwa, METR, “Clarifying limitations of time horizon,” January 22, 2026. https://metr.org/notes/2026-01-22-time-horizon-limitations/ [^6]: Thomas Kwa and Tom Cunningham, METR, “We spent 2 hours working in the future,” March 19, 2026. https://metr.org/notes/2026-03-19-org-uplift-game/