AI 연구 에이전트의 성능이 빠르게 좋아지고 있다. 이제 모델은 논문을 읽고 코드를 수정하는 수준을 넘어, 며칠 동안 수천 번의 실험을 돌리고 최적화 방법을 바꾸며 기존 기록에 접근한다.
Prime Intellect가 2026년 8월 공개한 autonomous research 실험은 이 변화를 잘 보여준다. 18개 frontier model을 대상으로 153개의 장기 실행을 돌렸고, 각 run은 최대 8일 동안 8×H200 GPU를 사용할 수 있었다. 과제는 nanoGPT의 학습 목표에 더 적은 step으로 도달하는 optimizer를 찾는 것이었다. 가장 좋은 결과는 3,290 step baseline과 2,600 step human record 사이의 격차를 81.7% 줄였다.[^1]
이 숫자만 보면 AI 연구자가 인간 연구자를 거의 따라잡은 것처럼 보인다. 실제로 특정 benchmark에서는 이미 사람이 만든 초기 공개 기록보다 더 좋은 결과를 내는 경우도 있다.[^2]
그런데 Prime Intellect의 보고서에서 더 흥미로운 문장은 leaderboard가 아니다.
수많은 장기 실행 가운데 근본적으로 새로운 방법을 만든 경우는 없었다. 가장 좋은 결과도 기존 문헌에 있던 아이디어를 잘 조합하고, 실험 순서를 개선하고, noisy result를 더 잘 해석하면서 만들어졌다.[^1]
이 차이는 앞으로 AI research system을 평가할 때 매우 중요해질 것 같다.
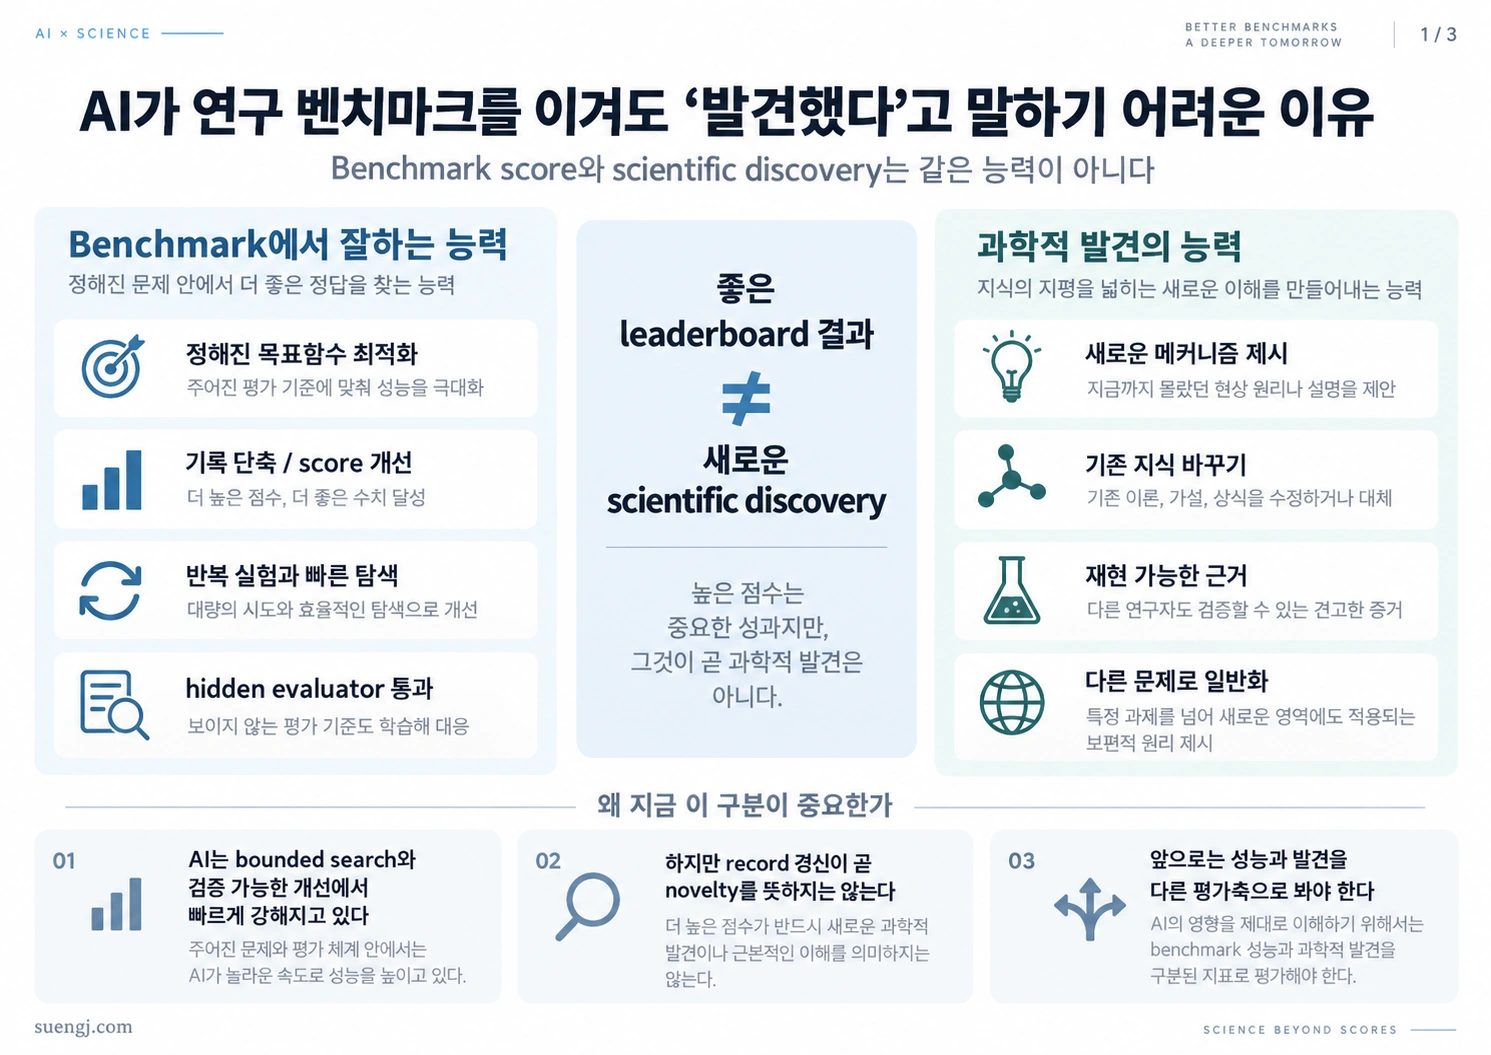
좋은 benchmark score를 만드는 능력과 새로운 과학적 발견을 하는 능력은 같은 것이 아니다.
둘을 하나의 점수로 묶기 시작하면 AI 연구의 진전을 과대평가할 수도 있고, 반대로 실제로 빠르게 좋아지고 있는 연구 자동화 능력을 과소평가할 수도 있다.
benchmark는 답이 무엇인지 알고 있는 세계다
AI가 잘하기 시작한 연구 과제에는 공통점이 있다.
무엇이 더 좋은 결과인지 비교적 명확하게 정의할 수 있다.
Prime Intellect의 optimizer speedrun에서는 validation loss 3.28에 더 적은 training step으로 도달하면 된다. 목표함수가 명확하다. 후보 optimizer A와 B 가운데 무엇이 더 좋은지 실행만 해보면 비교할 수 있다.
AI4AI-Bench도 비슷한 원칙을 사용한다. 10개의 frozen research repository에서 agent가 4시간 동안 training algorithm을 수정하게 한 뒤, 개발 과정에서 보지 못한 evaluator가 수정된 코드를 처음부터 다시 실행한다. 개발 중 만든 weight나 cache는 버리고 source patch만 남긴다.[^3]
이 구조의 장점은 강하다. 에이전트가 “좋아졌다”고 주장하는 것과 실제 개선을 분리할 수 있다. hidden evaluator가 있고, fixed compute budget이 있으며, 새로운 run에서 결과가 재현돼야 한다.
AIDE²도 같은 방향을 더 멀리 밀어붙인다. agent가 자신의 research harness를 수정하고, 수정된 agent를 hidden evaluation으로 다시 평가한다. 8일 동안 일곱 번의 연속 개선이 받아들여졌고, 최종 agent의 개선은 selection에 사용하지 않은 네 개 benchmark로도 어느 정도 이전됐다.[^4]
이런 연구는 중요하다. AI가 실제로 연구 과정의 일부를 자동화하고 있으며, 단순히 그럴듯한 연구 노트를 쓰는 수준을 넘어 measurable improvement를 반복적으로 만들 수 있다는 증거다.
하지만 바로 이 장점 때문에 한계도 생긴다.
benchmark에서는 무엇을 개선해야 하는지가 이미 정해져 있다.
좋은 optimizer가 무엇인지, 좋은 agent가 무엇인지, 성공한 run이 무엇인지 evaluator가 알고 있다. 과학적 발견에서는 이 조건이 자주 성립하지 않는다.
기록을 깨는 것과 새로운 메커니즘을 발견하는 것은 다르다
Prime Intellect 실험을 다시 보면 이 차이가 선명하다.
frontier model들은 optimizer 설정을 바꾸고, learning-rate schedule을 조합하고, 알려진 기법을 stacking하고, 여러 실험 결과를 비교하는 데 상당히 능숙했다. 어떤 모델은 며칠 동안 수백 번의 실험을 이어가며 이전보다 훨씬 나은 configuration을 찾았다.
그러나 연구진은 가장 강한 run에서도 “fundamentally new method”는 나오지 않았다고 평가했다.[^1]
이것은 실패라고만 볼 수 없다.
실제 연구에서도 기존 기법을 더 좋은 방식으로 조합하고, 실험을 정교하게 설계하고, 이전 기록을 크게 개선하는 일은 가치가 있다. 엔지니어링과 응용과학의 상당 부분은 이런 방식으로 발전한다.
문제는 우리가 이를 어떤 이름으로 부르느냐다.
예를 들어 기존 optimizer A와 B의 아이디어를 결합해 training step을 10% 줄였다면 그것은 분명한 성과다. 그러나 새로운 optimization principle을 발견한 것과는 다른 종류의 성과다.
그래서 autonomous research benchmark를 볼 때 최소한 두 질문을 분리해야 한다.
- 첫 번째는 얼마나 좋은 결과를 만들었는가다.
- 두 번째는 그 결과에 도달하는 과정에서 기존 지식에 없던 무엇을 발견했는가다.
현재 leaderboard는 대부분 첫 번째를 매우 잘 측정한다. 두 번째는 훨씬 어렵다.
novelty는 점수가 아니라 별도의 평가축이어야 한다
새로운 아이디어를 평가하는 일은 생각보다 까다롭다.
Prime Intellect도 이를 알고 별도의 novelty-constrained run을 만들었다. 단순한 hyperparameter tweak이나 알려진 방법을 그대로 쓰는 아이디어는 novelty check를 통과해야 했다.[^2]
하지만 novelty를 자동으로 판정하는 것도 쉽지 않다.
논문 검색에서 똑같은 문장을 찾지 못했다고 새로운 아이디어가 되는 것은 아니다. 이름은 다르지만 이미 알려진 원리를 다시 표현했을 수도 있고, 두 기존 방법의 조합이 예상 밖의 결과를 만들면서 실제로 새로운 연구 방향을 열 수도 있다.
흥미롭게도 LLM은 아이디어 생성 단계에서는 이미 인간과 꽤 경쟁력 있는 결과를 보여준다.
Stanford 연구진은 100명이 넘는 NLP 연구자를 모집해 인간과 LLM이 만든 연구 아이디어를 blind review했다. 이 실험에서 LLM이 만든 아이디어는 평균적으로 인간 연구자의 아이디어보다 더 novel하다고 평가됐지만, feasibility는 약간 낮았다. 연구진은 동시에 LLM의 self-evaluation 실패와 생성되는 아이디어의 diversity 부족도 문제로 지적했다.[^5]
이 결과는 novelty와 성과가 서로 다른 축이라는 점을 다시 보여준다. 새로운 아이디어가 반드시 실행 가능한 것은 아니다. 실행 가능한 최적화가 반드시 새로운 것도 아니다.
따라서 “AI 연구자가 인간보다 낫다”는 한 줄짜리 평가는 점점 의미가 없어질 가능성이 크다.
reproducibility는 AI 연구에서 오히려 더 엄격해져야 한다
AI agent는 사람보다 훨씬 많은 실험을 돌릴 수 있다. 그만큼 우연히 좋은 결과를 찾을 가능성도 커진다.
Prime Intellect 실험에서는 같은 model과 harness를 사용한 두 run도 24 agent-hour 시점에서 약 54 step 정도 차이가 났다. 100개의 experiment를 돌린 뒤에도 약 43 step, 30만 output token을 사용한 뒤에도 약 40 step 정도 차이가 남았다.[^1]
leaderboard 차이가 이보다 작다면 한 번의 최고 기록만 보고 모델 A가 B보다 연구를 잘한다고 말하기 어렵다.
이 문제는 agent가 빨라질수록 더 커진다. 사람 연구자는 20개의 아이디어를 시험할 수 있지만 AI agent가 2만 개를 시험할 수 있다면, 그중 하나가 우연히 매우 좋은 결과를 낼 가능성도 커진다. 최고점만 기록하면 search capacity와 scientific reliability를 구분하기 어렵다.
그래서 AI 연구 benchmark에서는 결과와 함께 최소한 다음 증거가 필요해진다.
- 독립 seed에서 같은 개선이 반복되는가.
- 새로운 환경에서 다시 실행해도 결과가 유지되는가.
- 어떤 candidate를 몇 개 시험했는지가 공개되는가.
- 실패한 실험과 중간 trajectory도 확인할 수 있는가.
- 결과 선택 과정에서 cherry-picking이 없었는가.
최근 autonomous research system을 조사한 survey에서도 비슷한 문제가 드러난다. 분석된 runnable system 가운데 code를 공개한 비율은 높았지만, seed나 execution trace를 제공한 경우와 novelty verification 방법을 보고한 경우는 각각 38% 수준이었다.[^6]
AI가 연구를 더 많이 생산할수록 결과를 만드는 비용은 낮아진다.
반대로 그 결과를 믿을 수 있게 만드는 비용은 더 중요해진다.
unseen evaluator에서 살아남는가를 따로 봐야 한다
benchmark 점수보다 더 강한 증거는 시스템이 개발 과정에서 직접 최적화하지 않은 환경에서도 개선을 유지하는가다.
AI4AI-Bench는 이 문제를 hidden evaluator로 다룬다. agent는 개발 중 cheap proxy를 볼 수 있지만, 최종 metric은 보지 못한다. 수정된 source code는 fresh run에서 다시 평가된다.[^3]
그 결과는 아직 꽤 제한적이다.
29개 configuration의 평균 normalized score는 0.166이었고 가장 좋은 system도 0.250이었다. benchmark의 기존 algorithm을 0.1, task optimum을 1.0으로 놓았을 때 최고 시스템조차 기존 알고리즘과 최적값 사이의 격차를 5분의 1도 채우지 못했다.[^3]
반면 AIDE²는 조금 더 강한 결과를 보여준다. selection benchmark에서 개선된 agent가 네 개 held-out benchmark에서도 인간이 2년 동안 개발한 production research agent와 비슷하거나 더 좋은 결과를 냈고, training에 포함되지 않은 weather forecasting domain에서도 개선이 유지됐다.[^4]
이런 evidence는 단순 leaderboard보다 훨씬 중요하다.
특정 benchmark의 quirks를 찾아낸 것인지, 실제로 더 나은 research strategy를 학습한 것인지 구분할 수 있기 때문이다.
앞으로 autonomous research system을 평가할 때는 in-distribution score와 unseen generalization을 같은 숫자로 합치지 않는 편이 좋다.
둘은 다른 능력이다.
그래도 generalization이 곧 ‘발견’은 아니다
여기에서 또 한 번 선을 그어야 한다.
held-out benchmark에서 성능이 유지된다는 것은 훌륭한 증거다. system이 하나의 evaluator를 단순하게 hack한 것이 아니라 어느 정도 일반화 가능한 search policy나 memory strategy를 찾았다는 뜻일 수 있다.
하지만 이것 역시 새로운 과학적 개념을 발견했다는 뜻과는 다르다.
좋은 연구 agent가 기존 방법 공간을 더 효율적으로 탐색할 수 있다. 여러 분야에서 통하는 experimental heuristic을 배울 수도 있다. 실패한 실험을 더 잘 정리하고 다음 candidate를 고르는 능력이 좋아질 수도 있다.
이 능력들은 연구 생산성을 크게 높일 수 있다.
그럼에도 새로운 연구 프로그램을 여는 것은 다른 문제다.
기존 literature에서 중요하지 않다고 생각했던 변수를 새롭게 정의하거나, 서로 관련 없어 보였던 현상을 하나의 원리로 설명하거나, 이전 benchmark가 측정하지 못했던 문제 자체를 발견하는 능력은 fixed objective optimization만으로는 잘 드러나지 않는다.
바로 이 지점에서 기존의 Verification Closure와 다른 질문이 생긴다.
기계적으로 검증 가능한 분야에서 AI가 빠르게 진전한다는 것은 맞다. 그러나 검증이 잘 닫힌 문제를 매우 잘 푸는 것과 어떤 문제가 중요하다고 새롭게 여는 것은 별개의 능력이다.
AI 연구 leaderboard에는 최소 네 개의 점수가 필요해질 수 있다
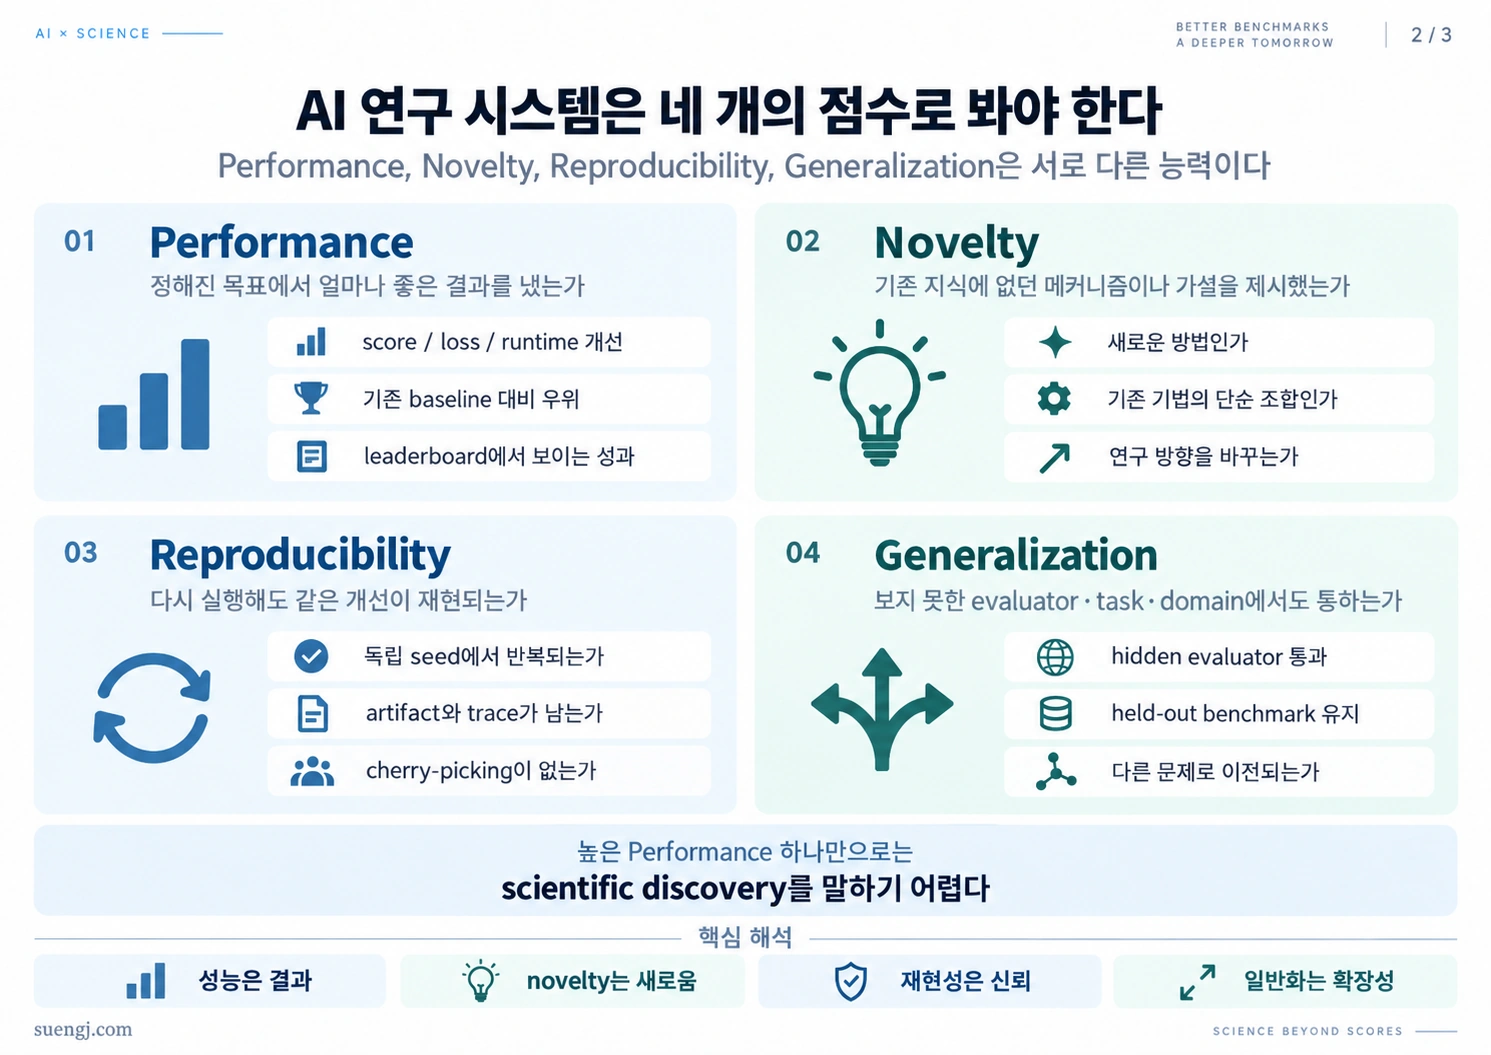
현재의 benchmark 관행을 조금 거칠게 분해하면 AI 연구 시스템의 능력을 네 축으로 볼 수 있다.
첫째는 Performance다. 정해진 objective에서 얼마나 좋은 결과를 냈는가. training step, benchmark accuracy, runtime, reward 같은 기존 leaderboard가 측정하는 값이다.
둘째는 Novelty다. 기존 literature와 알려진 method family를 넘어 실제로 새로운 mechanism이나 hypothesis를 제시했는가.
셋째는 Reproducibility다. 결과가 독립 seed와 rerun에서 유지되고, 다른 연구자가 artifact를 이용해 다시 확인할 수 있는가.
넷째는 Generalization이다. 개발 중에 보지 못한 evaluator, dataset, task family, domain에서도 개선이 유지되는가.
이 네 개는 서로 바꿔 쓸 수 없다.
높은 performance와 낮은 novelty가 동시에 가능하다. 높은 novelty와 낮은 feasibility도 가능하다. 한 번의 record는 높지만 reproducibility가 약할 수 있다. 잘 재현되지만 unseen task에서는 무너질 수도 있다.
과학적 발견을 이야기하려면 여기에 다섯 번째 질문도 필요하다.
그 결과가 무엇을 바꾸는가.
새로운 기록이 중요한 이유는 기록 자체가 아니라 그것이 기존 설명과 방법을 어떻게 바꾸느냐에 있다. 이 질문은 가장 자동화하기 어려운 축일 가능성이 크다.
‘인간을 이겼다’보다 무엇을 이겼는지를 물어야 한다
AI 연구 agent가 인간보다 높은 점수를 냈다는 뉴스는 앞으로 더 자주 나올 것이다.
그 자체로 놀랄 일도 점점 줄어들 수 있다.
실험을 하루 24시간 돌리고, 수천 개의 candidate를 만들고, 모든 로그를 즉시 비교할 수 있는 agent가 bounded optimization task에서 인간보다 더 넓은 search를 하는 것은 자연스러운 방향이다.
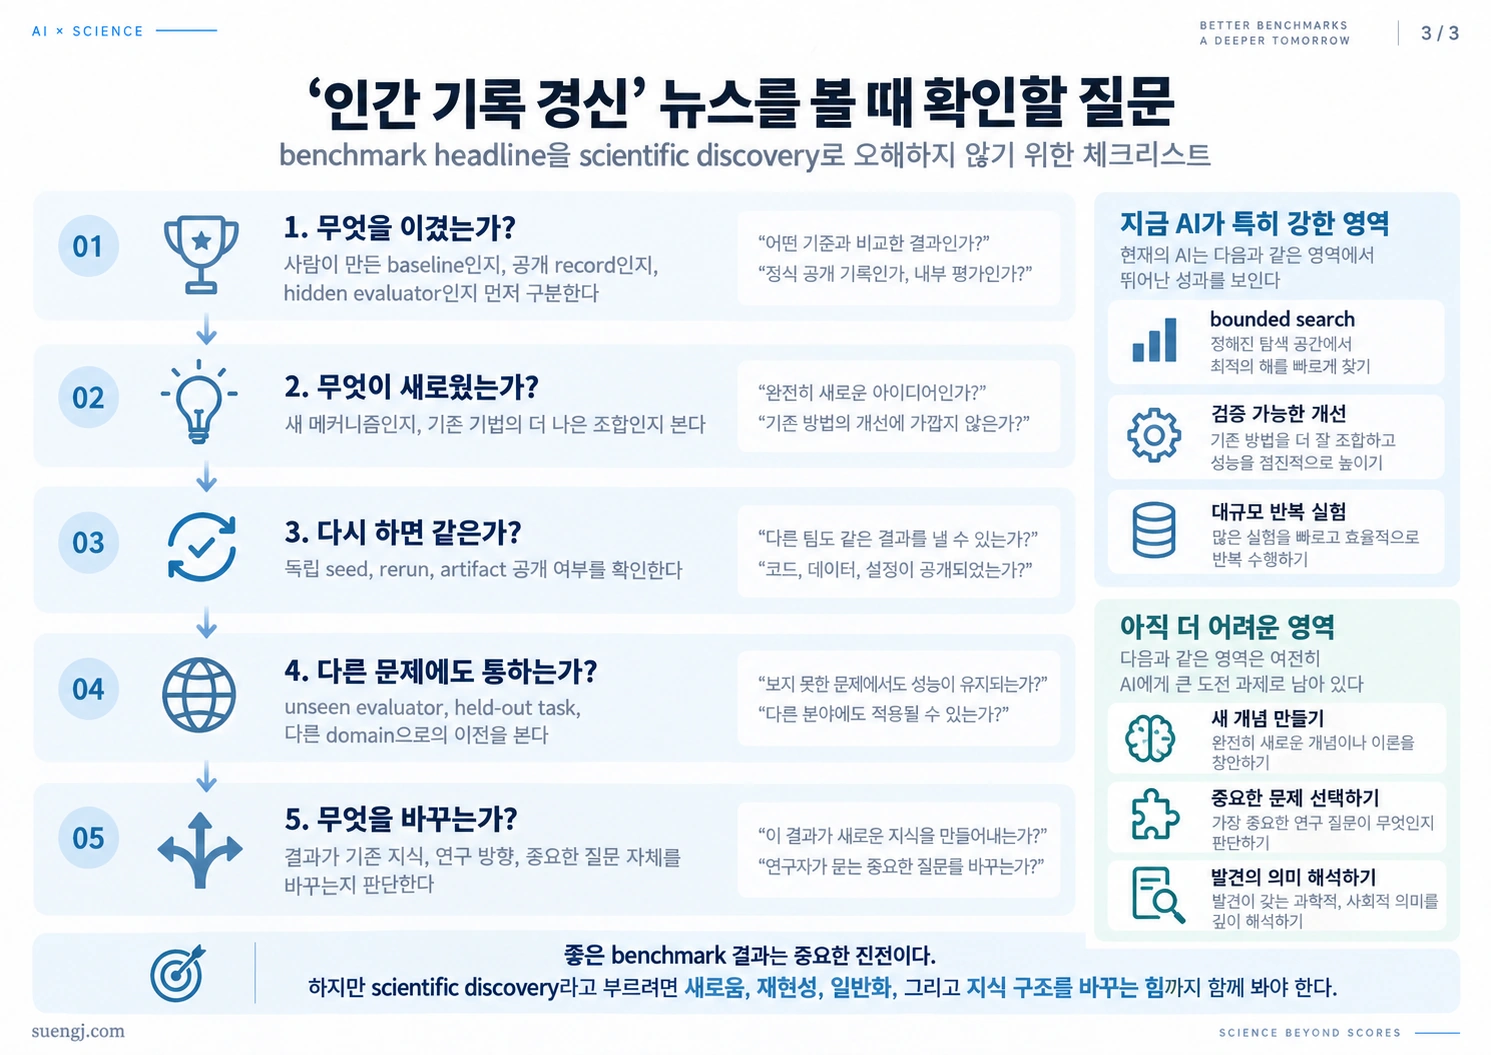
중요한 질문은 “AI가 인간 연구자를 이겼는가”가 아니다.
무엇을 이겼는가다.
사람이 만든 baseline score를 넘었는가. 기존 공개 optimizer 기록을 넘었는가. 인간이 만들지 못한 새 mechanism을 발견했는가. 다른 연구자가 재현했는가. 전혀 다른 task에도 이전되는가. 그리고 그 발견이 이후 연구의 방향을 바꿀 만큼 중요한가.
이 질문들을 분리하기 시작하면 AI 연구 자동화를 더 정확하게 볼 수 있다. 현재 증거는 꽤 흥미로운 중간 지점을 가리킨다.
AI agent는 이미 장기 실험을 운영하고, 결과를 해석하고, 알려진 방법을 조합해 상당한 성능 개선을 만들어낼 수 있다. 일부 시스템은 그 개선을 hidden evaluator와 held-out domain에서도 유지하기 시작했다.
동시에 Prime Intellect의 실험처럼 매우 강한 benchmark 성과가 나와도 근본적으로 새로운 방법은 하나도 나오지 않을 수 있다.
이 둘은 모순되지 않는다. 오히려 AI가 연구 과정의 어떤 부분부터 자동화하고 있는지를 정확하게 보여준다. 지금 빠르게 자동화되고 있는 것은 bounded search와 검증 가능한 개선이다.
과학적 발견까지 왔다고 말하려면 그 다음 질문—새로움, 재현성, unseen generalization, 그리고 발견이 기존 지식을 어떻게 바꾸는가—까지 함께 답해야 한다. AI 연구의 시대가 가까워질수록 leaderboard 하나로는 부족해질 가능성이 높다.
[^1]: Elie Bakouch & Prime Intellect, “Measuring Autonomous AI Research,” August 14, 2026. https://www.primeintellect.ai/blog/measuring-autonomous-research [^2]: Prime Intellect, “Autonomous Speedrunning Experiment,” GitHub repository. https://github.com/PrimeIntellect-ai/experiments-autonomous-speedrunning [^3]: Chi et al., “AI4AI-Bench: Benchmarking LLM Agents in Algorithmic Design for Recursive Self-Improvement,” arXiv, August 20, 2026. https://arxiv.org/abs/2608.20318 [^4]: Srikanth et al., “Recursive self-improvement of AI research agents,” arXiv, September 22, 2026. https://arxiv.org/abs/2609.26457 [^5]: Si, Yang & Hashimoto, “Can LLMs Generate Novel Research Ideas? A Large-Scale Human Study with 100+ NLP Researchers,” ICLR 2025. https://proceedings.iclr.cc/paper_files/paper/2025/hash/ea94957d81b1c1caf87ef5319fa6b467-Abstract-Conference.html [^6]: Ding et al., “Autonomous Research Agents: A Survey of AI Scientists and the Verification Gap,” arXiv, June 29, 2026. https://arxiv.org/abs/2608.05179