여행을 계획하는 도구는 8년 전보다 훨씬 좋아졌다. 검색은 빨라졌고, 리뷰는 많아졌고, AI에게 조건을 말하면 몇 초 안에 일정표와 후보 목록을 받을 수 있다. 그런데 McKinsey가 2026년 미국 여행자의 의사결정 과정을 다시 추적한 결과, 평균 접점은 2018년 약 45개에서 65개로 늘었다. 여행자의 74%는 결정을 내리기 전에 같은 사이트나 앱을 여러 번 다시 찾았다. 도구 하나하나는 편해졌지만 전체 결정 과정은 더 짧아지지 않았다.[^1]
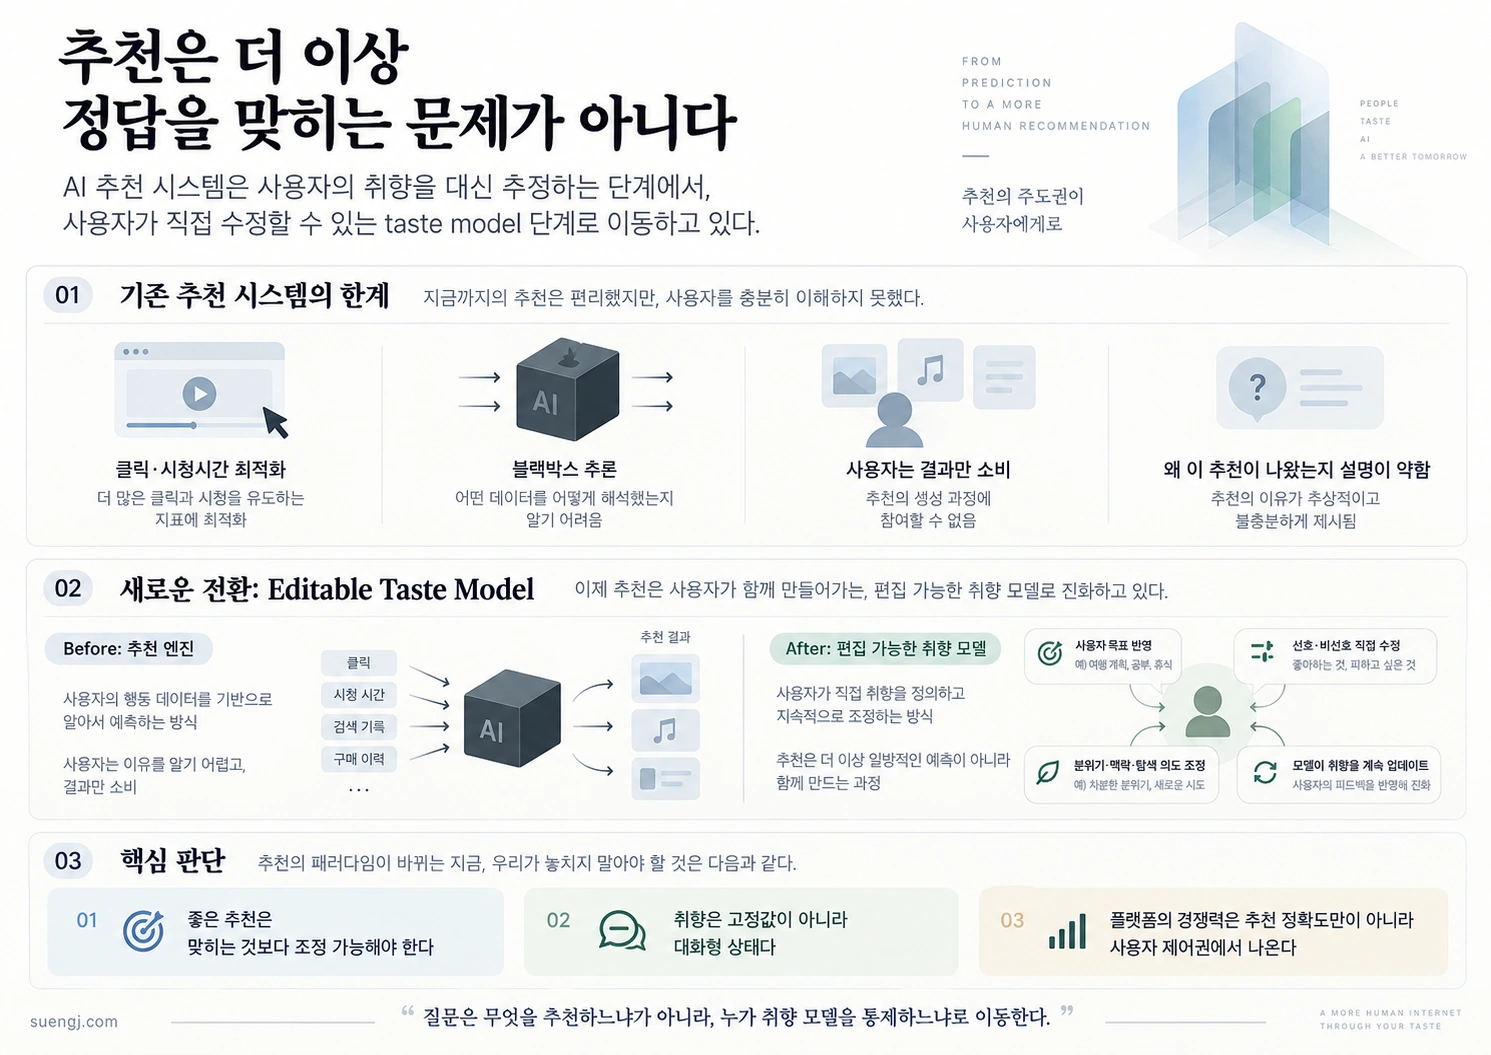
이 장면은 추천 시스템이 어디로 가야 하는지를 보여준다. AI가 후보를 더 많이 만들고 더 정교하게 순위를 매길수록, 다음 병목은 “무엇을 더 추천할 수 있는가”가 아니다. 사용자가 이미 무엇을 좋아하고 싫어했는지, 지금 무엇을 원하고 있는지, 이전에 어떤 후보를 버렸는지를 시스템이 얼마나 일관되게 기억하고 사용자가 그 해석을 얼마나 쉽게 고칠 수 있는가가 더 중요해진다.
최근 Spotify와 DoorDash의 추천 시스템을 보면 이 변화가 기술 구조에서도 나타난다. 카탈로그의 수많은 상품과 콘텐츠를 단순한 ID가 아니라 모델이 다룰 수 있는 의미 표현으로 바꾸고, 사용자의 행동과 명시적 의도를 같은 공간에 연결하려 한다. 동시에 Spotify는 9월 23일 미국 Premium 이용자에게 Taste Profile을 확대하면서, 알고리즘이 이해한 자신의 취향을 사용자가 직접 보고 수정하도록 만들었다.[^2]
추천의 다음 경쟁은 거대한 LLM을 화면 앞에 세우는 일보다, 카탈로그와 사용자 사이에 지속적이고 편집 가능한 ‘의미 계층’을 만드는 일에 가까울 수 있다.
선택지가 늘어날수록 좋은 후보를 찾는 것만으로는 부족하다
생성형 AI는 사용자의 의도를 훨씬 풍부하게 표현하게 해준다. “운동할 때 들을 음악”보다 “아침 40분 러닝에서 초반에는 차분하고 마지막 10분은 속도를 올릴 수 있는 곡”처럼 조건을 자연어로 전달할 수 있다.
문제는 생성 가능한 선택지가 늘어난다고 의사결정 비용까지 줄지는 않는다는 데 있다. McKinsey의 최근 여행 조사에서는 AI가 계획을 쉽게 해준다고 답한 사람이 62%였지만, 서비스 사이를 이동할 때 이전 맥락이 이어지지 않는 문제가 계속 나타났다. 사람들은 검색을 다시 하고, 이미 버린 후보를 다시 검토하고, 다른 채널에서 같은 조건을 재입력했다.[^1]
추천 품질을 한 번의 랭킹 정확도만으로 보면 이런 비용이 잘 보이지 않는다. 사용자가 지난 세션에서 호텔 A를 제외한 이유를 다음 세션이 모른다면, 더 좋은 모델이 같은 후보를 다시 추천할 수도 있다. 알고리즘은 정확할 수 있지만 사용자는 다시 일해야 한다.
따라서 개인화의 단위가 세션별 점수에서 지속되는 사용자 상태로 이동하는 것은 자연스러운 변화다.
Spotify가 만드는 것은 추천 문장보다 도메인 언어에 가깝다
Spotify의 최근 연구는 이 문제를 기술적으로 풀고 있다. NEO라는 통합 모델은 음악·팟캐스트·오디오북 같은 카탈로그 아이템을 Semantic Identifier(SID)라는 이산 토큰으로 표현하고, 자연어와 이 아이템 토큰을 하나의 시퀀스 안에서 함께 다룬다. 사용자가 자연어로 원하는 것을 말하면 모델은 텍스트로 답할 수도 있고 실제 카탈로그의 유효한 아이템 ID를 생성할 수도 있다.[^3]
중요한 것은 LLM이 말을 잘한다는 사실보다 카탈로그 자체가 모델이 추론할 수 있는 언어의 일부가 된다는 점이다.
Spotify는 NEO를 1,000만 개가 넘는 실제 카탈로그 아이템과 여러 discovery task에서 평가했고, 검색·추천·사용자 이해를 한 모델에서 함께 다룰 때 task 간 긍정적 전이가 관찰됐다고 보고했다.[^3]
DoorDash에서도 비슷한 방향이 보인다. DoorDash 연구진은 음식 주문과 검색 기록에서 LLM으로 계층적 취향 특징을 만들고, 이를 grocery·retail처럼 상대적으로 데이터가 적은 vertical의 production ranking model에 넣는 방식을 연구했다. 핵심은 LLM을 모든 요청의 최종 응답기로 쓰는 것이 아니라, 풍부한 행동 이력을 다른 추천 모델이 재사용할 수 있는 의미 특징으로 변환하는 것이다.[^4]
두 회사의 구현은 같지 않다. Spotify는 생성형 추천을 production path에 적극적으로 넣고 있고, DoorDash 사례는 LLM의 추론을 특징량으로 만들어 기존 ranking stack에 연결한다. 하지만 공통점은 분명하다. LLM의 가치가 긴 답을 생성하는 데만 있지 않고, 복잡한 행동과 카탈로그를 재사용 가능한 의미 표현으로 바꾸는 데 있다.
사용자에게 필요한 것은 알고리즘 설명서보다 수정 가능한 상태일 수 있다
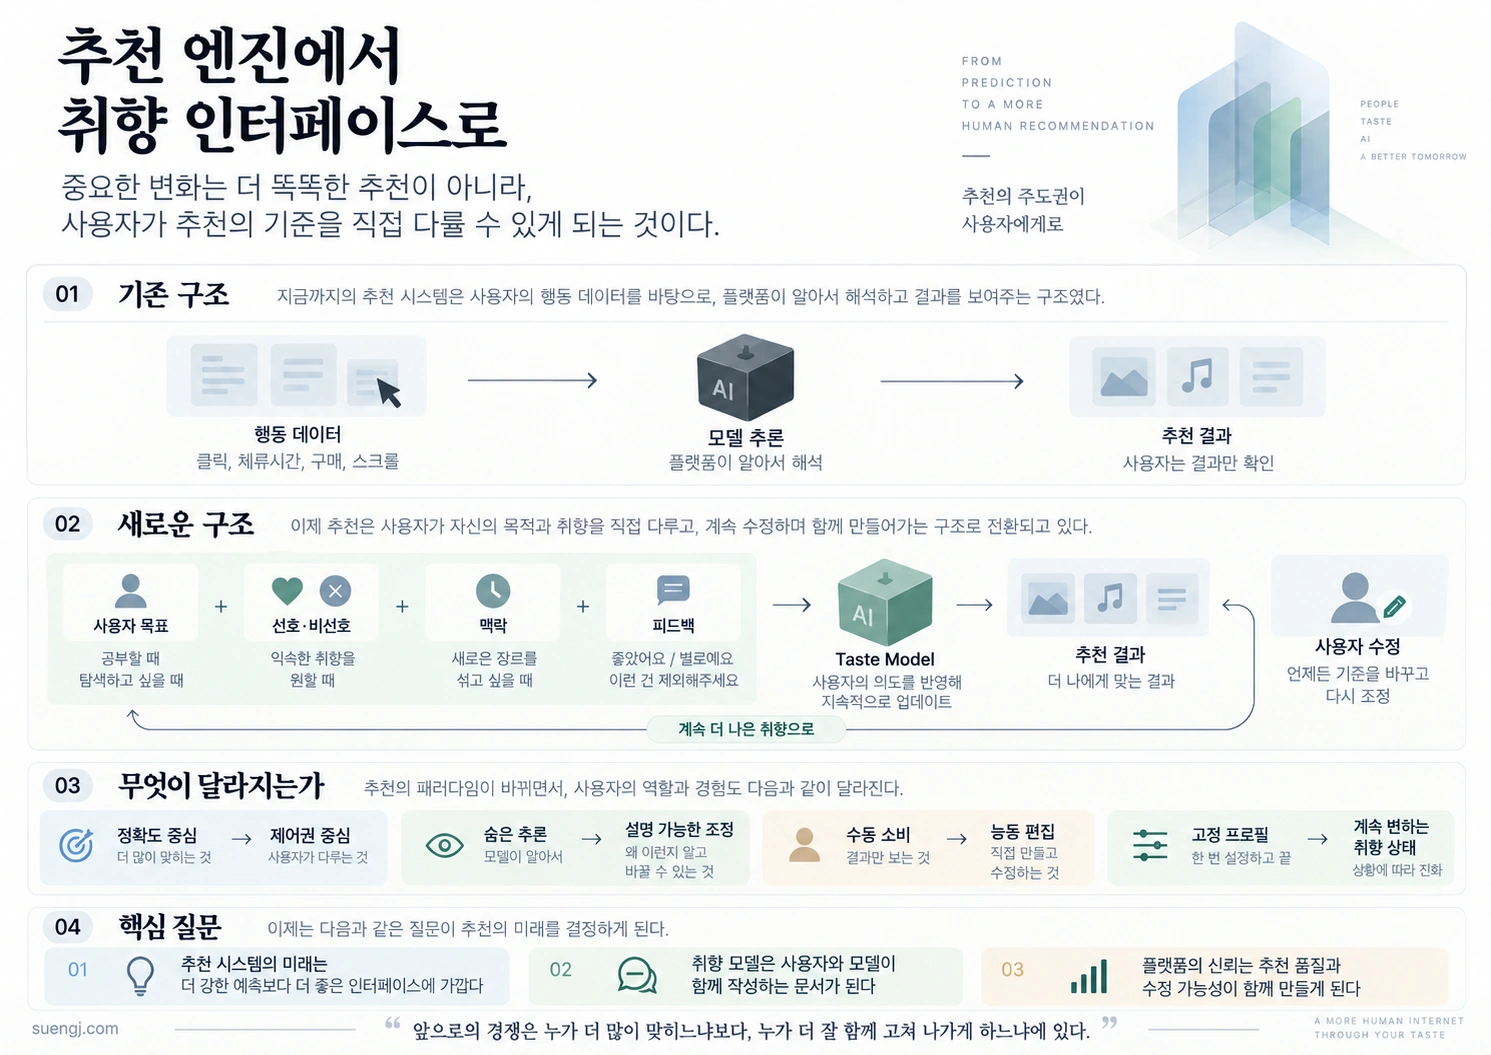
행동 로그는 생각보다 모호하다. 아이를 위해 반복 재생한 동요가 부모의 음악 취향으로 기록될 수 있고, 선물용으로 검색한 상품이 장기 구매 선호로 남을 수 있다. 여행을 한 번 검색했다고 매달 같은 지역을 추천받고 싶은 것도 아니다.
Spotify가 올해 도입한 Taste Profile은 이 관계를 조금 바꾼다. 사용자는 Spotify가 자신의 음악·팟캐스트·오디오북 취향을 어떻게 해석하고 있는지 보고, 자연어로 “이런 것은 더 보여달라”거나 “이런 취향은 이제 줄여달라”고 입력할 수 있다. 9월 23일부터 미국 Premium 이용자에게도 beta가 확대됐다.[^2]
이 기능의 의미는 UI 하나가 추가됐다는 데 있지 않다. 추천 모델 내부에만 존재하던 사용자 표현 일부를 사용자와 협상 가능한 상태로 바꾼다는 데 있다.
좋은 사용자 모델은 단순히 오래 기억하는 모델이 아닐 수 있다. 장기 취향, 지금 세션의 목적, 일회성 행동을 구분하고, 사용자가 틀린 추정을 수정할 수 있어야 한다. 기억의 양보다 기억의 수정 가능성이 중요해진다.
McKinsey 조사에서 소비자가 겪는 큰 마찰도 옵션 부족보다 채널을 옮길 때 판단 맥락이 사라지는 restart tax였다. 소비자는 더 많은 도구보다 돌아왔을 때 이전 상태가 복원되고 같은 질문을 다시 하지 않아도 되는 연속성을 원했다.[^1]
생각하는 과정을 보여주는 추천이 더 좋은 추천이라는 보장도 없다
Spotify 연구진이 9월 23일 공개한 실험은 자연어 reasoning trace를 더 잘 만드는 것이 추천 성능과 같은 목표가 아님을 보여준다. 연구진은 Amazon 상품 도메인에서 자연어 제목과 Semantic ID를 사용하고, 추천 전에 명시적인 설명형 reasoning trace를 생성하도록 학습한 조건을 비교했다. 설명의 grounding은 좋아질 수 있었지만, 표준 SFT와 RL 설정에서는 reasoning trace를 추가한 경우 전통적인 offline 추천 성능이 오히려 낮아졌다.[^5]
이 결과를 추론이 필요 없다는 뜻으로 읽으면 과도하다. 특정 모델과 데이터, 평가 설정의 결과이고 reward 설계를 바꾸면 일부 성능은 회복됐다.
더 중요한 해석은 사람이 읽기 좋은 설명과 추천을 잘 고르는 내부 표현은 같은 목표가 아니라는 것이다. 인터페이스는 자연어가 될 수 있지만 내부 시스템까지 매번 긴 자연어 reasoning을 통과할 필요는 없다.
최고의 추천은 때로 추천을 덜 하는 것일 수도 있다
사용자가 원래 스스로 발견했을 콘텐츠를 추천 슬롯에 다시 보여주는 것은 추가 가치가 아닐 수 있다.
Spotify가 9월 25일 공개한 causal recommendation 연구는 추천을 받은 경우의 소비 가능성과 추천이 없어도 자연스럽게 소비할 가능성을 따로 추정해 추천 때문에 실제로 행동이 달라질 가능성이 높은 경우에만 노출하는 정책을 실험했다. 수백만 명 규모의 A/B test에서 추천 노출은 7% 줄었지만 전체 추천 콘텐츠 소비에는 통계적으로 유의한 감소가 없었다.[^6]
좋은 recommender는 최대한 많은 콘텐츠를 끼워 넣는 시스템이 아니라, 사용자가 혼자서는 도달하기 어려운 좋은 선택을 필요한 순간에 줄 수 있는 시스템일 수 있다. 추천의 양보다 incremental value가 중요해진다.
생성형 AI는 후보 생성비용을 낮춘다. 시스템이 “하나만 더 찾아보기”를 계속 확대하면 추천은 도움보다 탐색의 연장이 될 수 있다.
LLM 추천의 아키텍처는 하나로 수렴하지 않을 가능성이 크다
Spotify는 Semantic ID를 생성하는 모델을 실제 discovery system에 넣고 자연어 지시와 카탈로그 retrieval을 통합하는 방향을 밀고 있다. GLIDE 연구에서는 대규모 사용자 A/B test를 통해 Semantic ID 기반 생성형 retrieval이 비습관적 팟캐스트 청취와 새로운 쇼 발견을 늘리면서 production latency와 cost constraint를 만족했다고 보고했다.[^7]
반면 DoorDash 사례에서는 LLM이 풍부한 사용자 행동을 분석해 taxonomic feature를 만들고 실제 serving은 production multi-task ranking model이 담당한다.[^4]
어느 쪽이 정답이라고 보기 어렵다. 콘텐츠 도메인, latency, 비용, 카탈로그 변화속도, 사용자 interaction 방식이 다르기 때문이다.
대신 공통 인프라는 보인다. 카탈로그에는 모델이 다룰 수 있는 의미 표현이 필요하고, 사용자에게는 장기·단기 선호를 구분하는 상태가 필요하다. 그리고 이 둘을 자연어 요청과 연결하되 실제 serving path는 제품의 비용과 지연 요구에 맞게 선택해야 한다.
이렇게 보면 “LLM을 추천에 도입했는가”보다 더 중요한 질문은 어떤 의미 상태를 만들었고, 그 상태가 제품 전체에서 얼마나 재사용되는가다.
추천 제품의 KPI도 클릭률 하나보다 넓어져야 한다
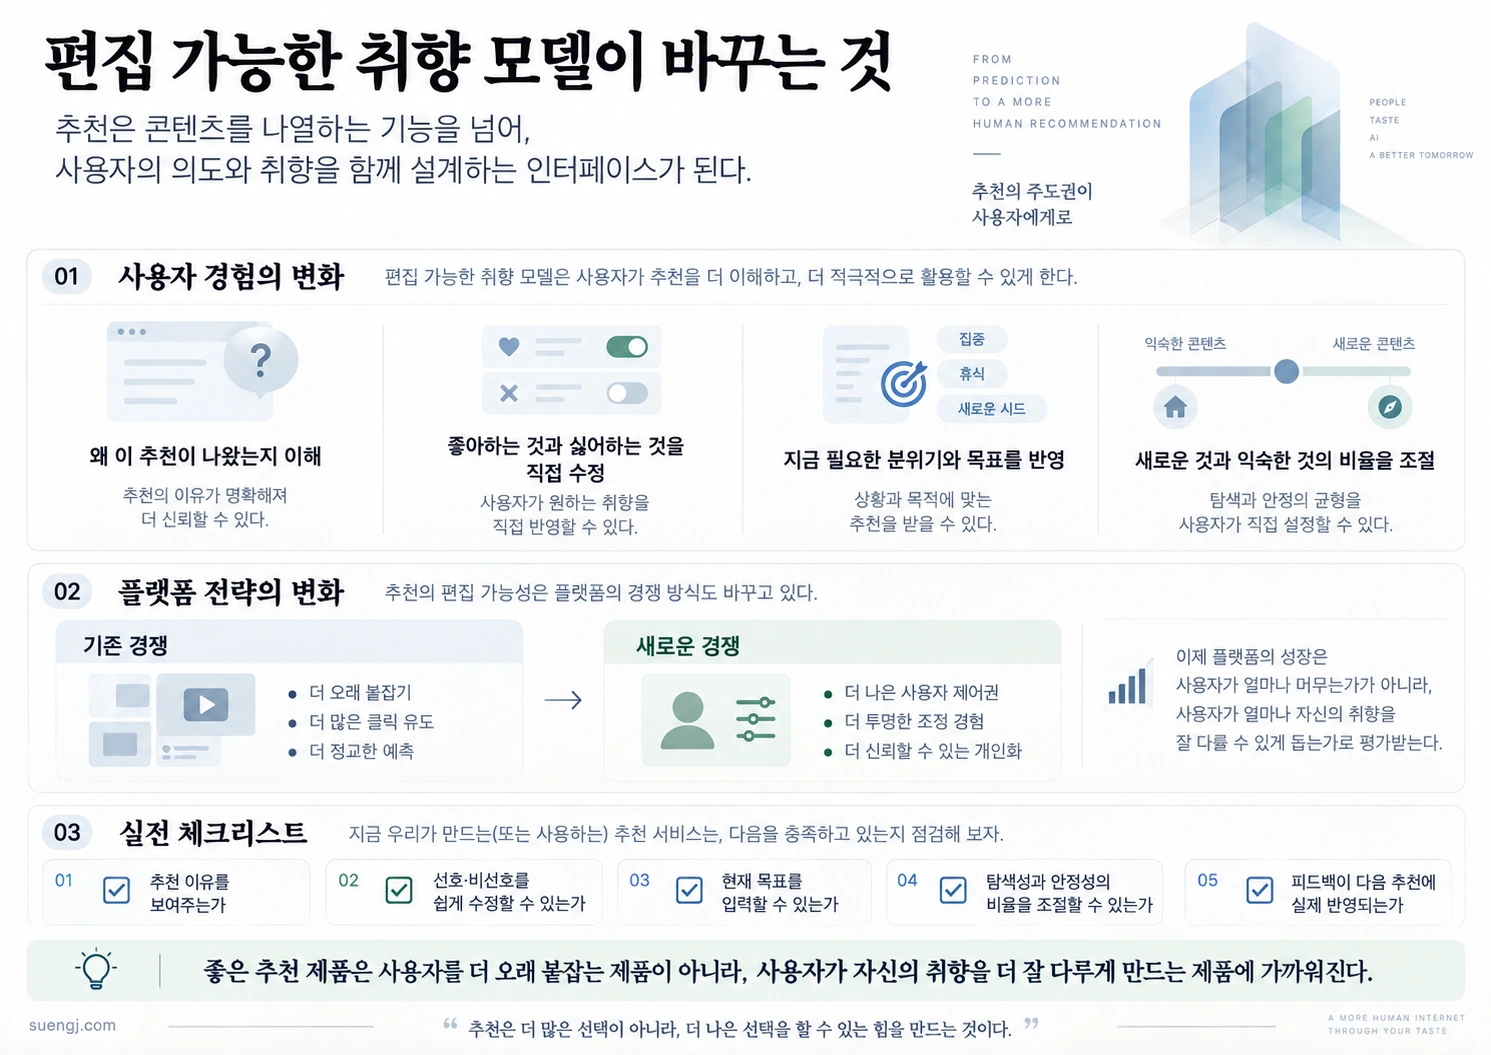
CTR이나 시청시간, 주문 전환율은 여전히 중요하다. 그러나 개인화 모델이 장기 의사결정을 돕는다면 사용자가 같은 조건을 반복 입력하는 비율이나 이미 제외한 후보가 다시 등장하는 빈도도 품질 신호가 된다.
사용자가 자신의 취향을 수정한 뒤 추천이 얼마나 빨리 바뀌는지, 자연어로 표현한 제약이 다른 surface에서도 유지되는지, 새로운 콘텐츠를 발견했지만 후회하지 않는지 같은 지표도 중요해질 수 있다.
특히 추천이 없었어도 일어났을 행동을 구분하는 incrementality는 더 중요해진다. 생성형 모델이 보여줄 수 있는 후보가 늘수록 단순 노출과 소비량은 시스템의 실제 기여를 과대평가하기 쉽다.
결국 추천 시스템의 성능은 세 층으로 나눠볼 수 있다. 후보를 이해하는 representation, 사용자를 이해하는 state, 실제 행동을 바꾸는 incremental decision support다. 세 층을 모두 잘한다고 해서 반드시 하나의 거대한 모델이어야 하는 것은 아니다.
이 관점이 틀릴 수 있는 조건
범용 LLM이 카탈로그와 행동 이력을 별도 표현 계층 없이도 충분히 싸고 빠르게 처리하면서 기존 추천 시스템을 일관되게 압도한다면 Semantic ID나 증류된 feature layer의 중요성은 줄어들 수 있다.
사용자가 자신의 취향 모델을 직접 보고 수정하는 일을 번거롭게 느낄 수도 있다. 자동 추론이 충분히 정확해져 explicit control을 거의 쓰지 않는다면 편집 가능한 프로필은 핵심 인터페이스가 아니라 예외 처리 기능에 머물 수 있다.
장기적인 취향 모델이 새로운 발견을 막을 가능성도 있다. 과거 행동을 너무 정확히 반영하면 개인화가 다양성과 탐색을 줄이는 필터가 될 수 있다. 그래서 사용자 상태는 정확하기만 해서는 안 되고 언제 벗어나야 하는지도 설계해야 한다.
privacy와 governance 문제도 남는다. 여러 서비스와 세션을 연결하는 사용자 상태가 강력해질수록 데이터 보존기간, 사용범위, 수정·삭제 권한이 제품 경쟁력만큼 중요해진다.
그럼에도 최근의 변화는 한 방향을 가리킨다.
소비자 AI가 더 많은 선택지를 만드는 것은 이미 쉬워지고 있다. 더 어려운 문제는 사용자가 무엇을 원하는지에 대한 지속적이지만 수정 가능한 모델을 만들고, 그 상태를 수많은 후보와 연결하면서, 실제로 도움이 되는 순간에만 추천을 개입시키는 일이다.
추천의 미래가 챗봇처럼 보일 수는 있다. 그러나 경쟁력은 대화창보다 아래에 있을 가능성이 높다. 나를 얼마나 오래 기억하느냐가 아니라, 나를 얼마나 정확하게 표현하고 내가 그 표현을 얼마나 쉽게 고칠 수 있느냐가 다음 개인화 경쟁의 핵심이 될 수 있다.
[^1]: McKinsey & Company, “Winning hearts in an age of infinite travel choices,” September 22, 2026. https://www.mckinsey.com/industries/travel/our-insights/winning-hearts-in-an-age-of-infinite-travel-choices [^2]: Spotify, “How to Use Our Taste Profile Feature to Shape Your Spotify Homepage,” September 23, 2026. https://newsroom.spotify.com/2026-09-23/taste-profile-shape-home-feed/ [^3]: Spotify Research, “A Unified Model for Personalization: Language-Steerable Generative Recommendation, Search, and User Understanding,” August 11, 2026. https://research.atspotify.com/publications/unified-model-personalization-language-steerable-generative-recommendation-search-user-understanding [^4]: Sinha et al., “Mind the Gap: Bridging Behavioral Silos with LLMs in Multi-Vertical Recommendations,” June 4, 2026. https://arxiv.org/abs/2606.06779 [^5]: Spotify Research, “The Disconnect Between Better Descriptive Reasoning Trace Quality and Recommendation Effectiveness,” September 23, 2026. https://www.research.atspotify.com/publications/the-disconnect-between-better-descriptive-reasoning-trace-quality-and-recommendation-effectiveness [^6]: Spotify Research, “Incremental Recommendation via Causal Models,” September 25, 2026. https://research.atspotify.com/publications/incremental-recommendation-via-causal-models [^7]: Spotify Research, “From Habits to Discovery: Deploying LLMs for Personalized Generative Recommendations at Spotify,” August 11, 2026. https://research.atspotify.com/publications/from-habits-to-discovery-deploying-llms-personalized-generative-recommendations-spotify