요즘 강한 AI 모델을 쓰는 방법은 대체로 한 방향으로 진화해왔다. 어려운 문제라면 바로 답하지 말고 더 오래 생각하게 한다. 여러 후보를 만들고, 스스로 다시 검토하게 하고, 필요하면 검색이나 도구를 추가로 사용하게 한다. 실제로 이런 test-time compute, 즉 모델이 학습을 끝낸 뒤 실제 질문을 받을 때 추가로 쓰는 계산량은 수학과 코딩 같은 복잡한 문제에서 성능을 끌어올리는 강력한 방법이다.
그런데 최근 연구를 같이 놓고 보면 반대 방향의 변화도 선명해진다. Meta FAIR 연구진은 같은 문제에서 생성된 여러 추론 가운데 짧게 끝난 reasoning chain이 긴 chain보다 오히려 더 정확한 경우가 체계적으로 나타난다고 보고했다.[^2] 한편 **Contrastive Language Models(CLM)**라는 접근은 아예 “모든 판단을 긴 문장으로 생성할 필요가 있는가”라는 질문을 던진다.[^1]
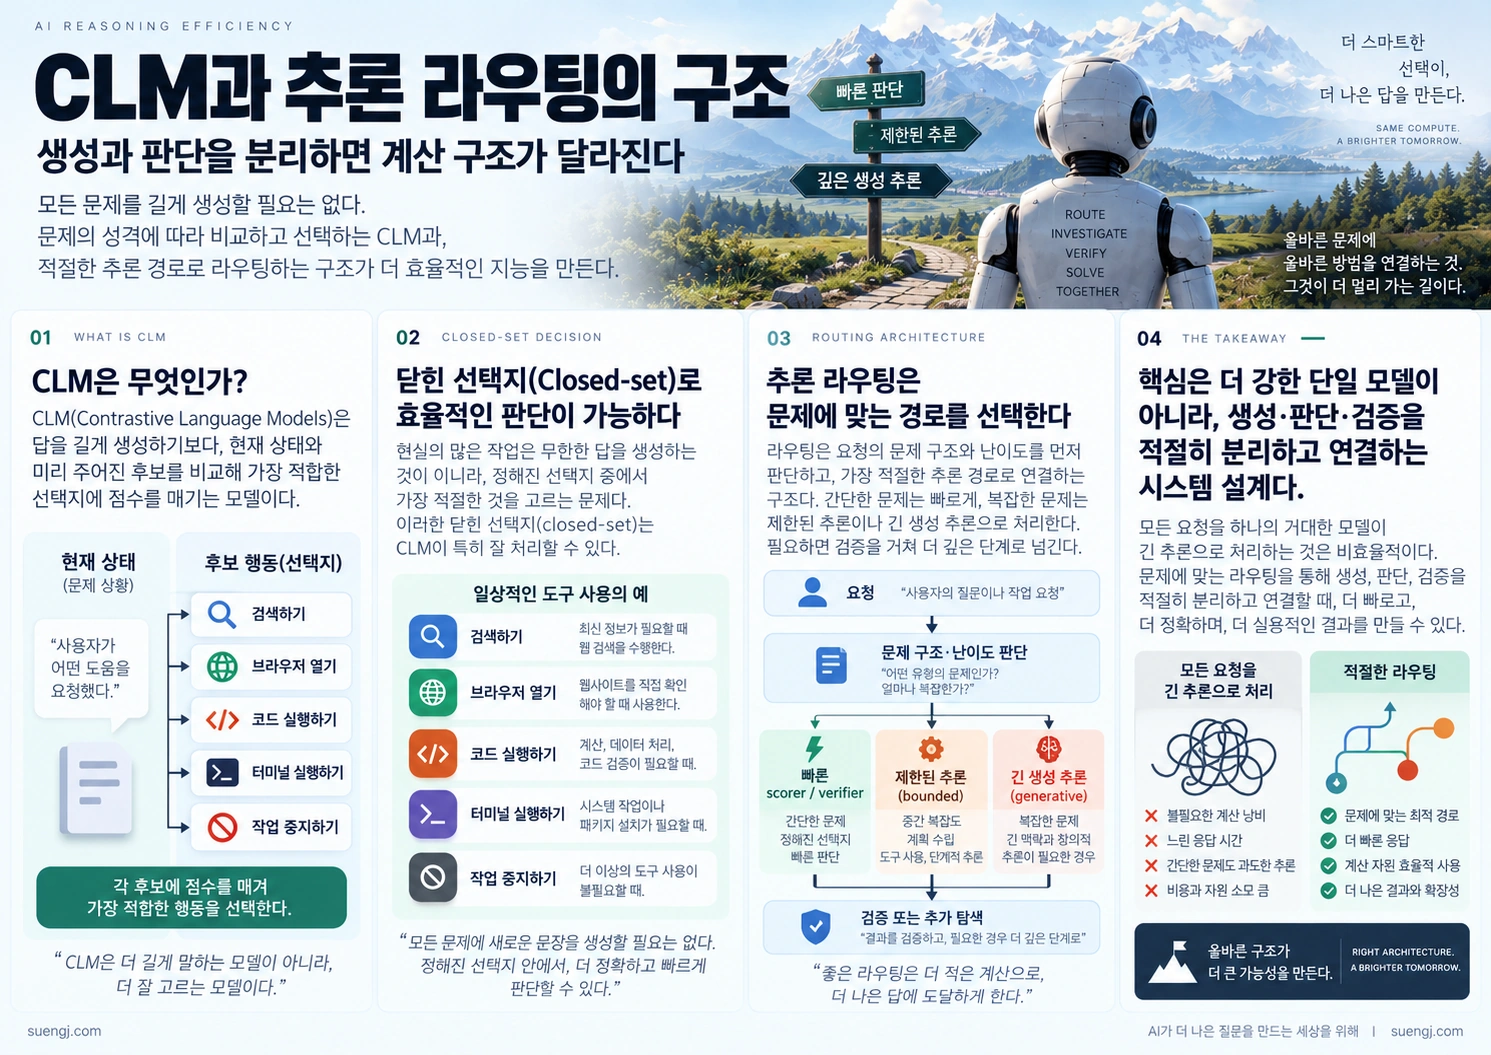
CLM은 쉽게 말해 정답을 처음부터 문장으로 만들어내는 모델이 아니라, 현재 상황과 미리 주어진 여러 선택지를 비교해 가장 적합한 후보에 점수를 주는 모델이다. 예를 들어 에이전트가 search, browser, code, terminal, stop 가운데 다음 행동 하나를 골라야 한다면, 매번 긴 추론을 생성하는 대신 현재 상태와 각 후보를 비교해 가장 잘 맞는 행동을 고른다. Contrastive라는 이름도 이런 식으로 “어떤 후보가 더 잘 맞는가”를 서로 비교해 학습한다는 데서 나온다.
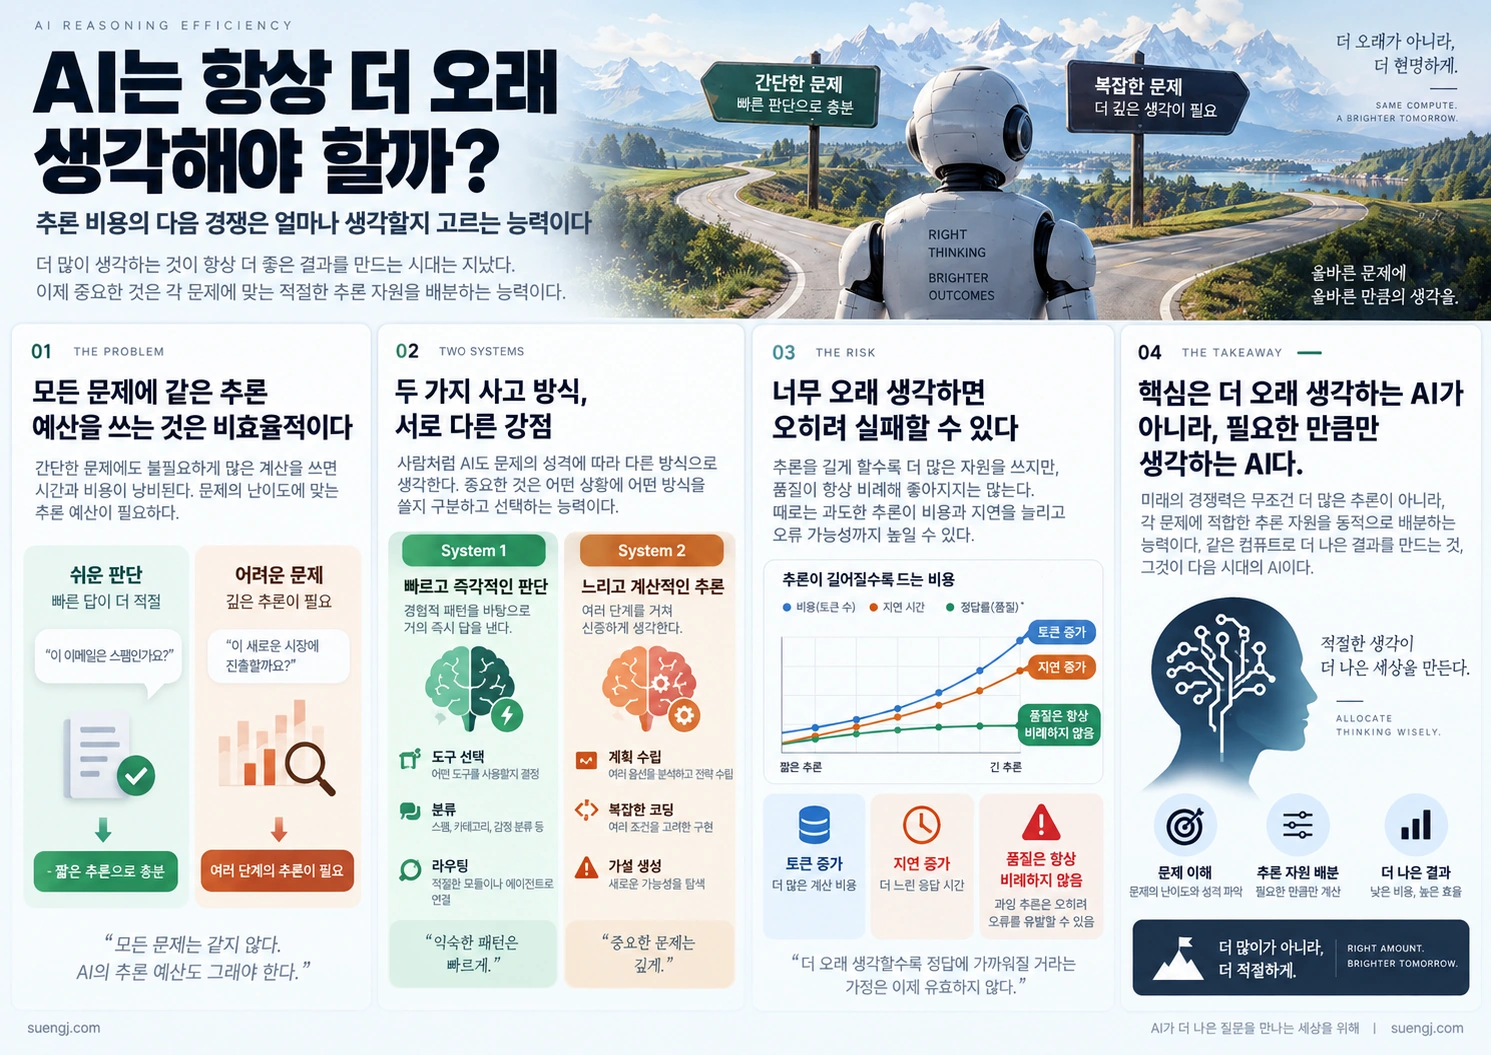
이 두 흐름이 함께 가리키는 결론은 “AI는 짧게 생각해야 한다”가 아니다. 더 중요한 점은 모든 문제에 같은 방식과 같은 양의 추론을 쓰는 것이 비효율적이라는 것이다. 쉬운 판단과 반복적인 선택까지 긴 Chain-of-Thought를 거칠 이유는 없고, 반대로 어려운 문제에서 무조건 생각을 줄이는 것도 잘못이다.
사람도 비슷하다. 익숙한 길에서 신호등을 보고 멈추는 데에는 긴 숙고가 필요하지 않지만, 집을 사거나 복잡한 계약서를 검토할 때는 천천히 생각한다. AI에서도 중요한 것은 “얼마나 오래 생각할 수 있는가”보다 어떤 상황에서 얼마나 생각해야 하는지를 구분하는 능력일 수 있다.
앞으로 AI inference의 경쟁은 모델의 최대 reasoning 길이에서 한 단계 더 나아가, 필요한 문제에 필요한 만큼의 계산을 배분하는 능력으로 이동할 가능성이 크다.
먼저, System 1과 System 2가 무엇인지 짚고 가자
이 글에서 자주 등장하는 System 1과 System 2는 인간의 사고를 설명할 때 널리 쓰여온 비유에서 가져온 표현이다.
아주 단순하게 말하면 System 1은 빠르고 즉각적인 판단, System 2는 느리고 계산적인 사고다. 익숙한 얼굴을 알아보거나 두 선택지 가운데 명백히 더 나은 것을 고르는 일은 System 1에 가깝다. 반대로 복잡한 수학문제를 풀거나 여러 조건을 비교해 계획을 세우는 일은 System 2에 가깝다.
AI에서 이 구분을 인간의 뇌 구조와 똑같이 받아들일 필요는 없다. 여기서는 빠른 판별·선택 계층과, 비용이 더 들지만 열린 문제를 풀 수 있는 생성형 추론 계층을 구분하는 실용적인 표현으로 보는 편이 정확하다.
예를 들어 에이전트가 정해진 도구 목록 가운데 다음 행동 하나를 고르는 문제는 System 1식 판단으로 처리할 수 있다. 반대로 “이 서비스의 장애 원인을 추정하고 가장 안전한 복구 계획을 세워라”는 요청은 System 2에 가까운 추론이 필요하다. 문제는 지금까지 많은 AI 시스템이 이런 차이를 세밀하게 나누기보다 꽤 많은 요청을 비싼 생성형 추론으로 보내왔다는 데 있다.
‘생각을 많이 하면 더 정확하다’는 전제가 항상 맞지는 않는다
Reasoning model의 직관은 이해하기 쉽다. 바로 답하지 않고 중간 추론을 충분히 거치면 실수를 발견하고 복잡한 문제를 단계적으로 풀 수 있다. 실제로 추가 test-time compute가 성능을 높이는 사례는 많다.
문제는 추론 길이가 곧 추론의 질은 아니라는 점이다. Don't Overthink it 연구는 같은 질문에서 여러 reasoning chain을 생성한 뒤 길이와 정답 여부를 비교했다. 그 결과 가장 짧은 chain이 가장 긴 chain보다 최대 34.5% 더 높은 정확도를 보였다. 연구진이 제안한 short-m@k는 여러 후보를 병렬로 생성하되 먼저 reasoning을 끝낸 후보를 우선 사용한다. short-1@k는 기존 majority voting과 비슷하거나 더 좋은 성능을 내면서 thinking token을 최대 40% 줄였고, short-3@k는 여러 compute budget에서 majority voting을 앞서면서 wall time도 최대 33% 줄였다.[^2]
여기서 majority voting은 같은 문제를 여러 번 풀게 한 뒤 가장 많이 나온 답을 선택하는 방식이다. 답 하나를 그대로 믿기보다 여러 시도를 모아 합의를 만드는 셈이다.
다만 이 결과를 “짧은 답이 항상 더 좋다”로 읽으면 곤란하다. 어려운 문제는 평균적으로 더 긴 추론을 요구할 수 있고, 짧게 끝났다는 사실 자체가 정답의 원인이라고 단정할 수도 없다. 모델이 문제를 정확히 이해한 경우 빠르게 정답으로 수렴한 반면, 처음부터 잘못된 방향으로 들어간 경우 같은 오류를 반복하면서 chain만 길어졌을 가능성도 있다.
그럼에도 운영 관점에서는 중요한 신호다. 생성된 토큰 수는 비용이고 latency인데, 그 비용이 항상 품질로 바뀌지는 않는다. 여기서 latency는 사용자가 요청을 보낸 뒤 결과를 받을 때까지 기다리는 시간이다. 같은 정확도를 얻을 수 있다면 2초와 20초는 제품 경험과 서버 비용에서 완전히 다른 결과다.
따라서 더 긴 reasoning을 모든 요청의 기본값으로 두는 정책은 쉬운 문제에서 계산을 낭비할 수 있다. 일부 문제에서는 모델이 잘못된 생각을 더 오래 이어가게 만들 수도 있다.
CLM은 ‘생각하지 않아도 되는 판단’을 생성형 모델에서 빼려는 접근이다
여기서 CLM의 역할이 더 분명해진다.
일반적인 생성형 언어모델은 “다음에 무엇을 해야 할까?”라는 질문을 받으면 토큰을 하나씩 생성하면서 답을 만든다. CLM은 그와 달리 현재 상태(state)와 가능한 행동(action)을 각각 벡터로 바꾼 뒤, 둘이 얼마나 잘 맞는지를 점수화한다. 후보 action이 반복해서 쓰인다면 그 벡터는 미리 계산해 cache할 수 있고, 새로운 state만 한 번 처리하면 된다.[^1]
이런 문제를 closed-set이라고 부를 수 있다. 선택지가 열려 있지 않고 미리 정해져 있다는 뜻이다.
예를 들어 에이전트가 매 순간 다음 도구 가운데 하나를 골라야 한다고 해보자.
현재 상태
→ search
→ browser
→ code
→ terminal
→ stop
후보가 이미 다섯 개로 정해져 있는데 매번 “어떤 도구를 써야 하는지 긴 문장으로 생각한 뒤 답을 생성”할 필요는 없다. 현재 상태를 읽고 후보 가운데 하나를 고르는 문제가 충분히 안정적으로 정의된다면, 생성보다 scoring이 더 자연스러운 구조일 수 있다.
CLM-8B는 이런 목적을 위해 6천만 QA pair로 pre-training하고, 3천만 synthetic hard negative로 더 미세한 구분을 학습한 뒤, 100만 agent trajectory로 post-training됐다. 공식 공개 결과에서는 computer-use·gaming·tool-calling의 zero-shot 평가에서 Jev와 비슷한 성능을 보이면서 latency가 최대 9배 낮았다고 보고한다.[^1]
coding verifier 평가에서는 숫자를 조금 더 주의해서 읽어야 한다. 여기서 verifier는 답을 직접 만드는 모델이 아니라, 이미 만들어진 여러 답 가운데 어느 것이 더 좋은지 판정하는 역할이다. DeepSWE 38개 held-out task와 Terminal-Bench 2.1의 30개 held-out task에서 CLM은 각각 81.6%, 87.6%를 기록했고 Jev보다 4.1~5.7배 빠른 latency가 보고됐다. 다만 여기에는 lightweight fine-tuning이 들어갔고, CLM이 코드 자체를 처음부터 만든 것이 아니라 Opus 5와 Fable 5가 만든 여러 후보 가운데 좋은 답을 고르는 verifier 역할을 했다.[^1]
이 제한이 오히려 중요하다. CLM은 느린 reasoning을 없앤 사례라기보다, 느린 reasoning이 만든 후보를 모든 단계에서 다시 느린 reasoning으로 평가할 필요는 없다는 사례에 가깝다. 생성을 잘하는 모델과 빠르게 고르는 모델을 분리하면 시스템 전체의 계산구조를 다르게 설계할 수 있다.
실제 핵심은 ‘System 1 대 System 2’가 아니라 둘 사이의 라우팅이다
AI 시스템에서 System 1과 System 2 가운데 하나만 고를 이유는 없다. 더 현실적인 구조는 어떤 요청을 어느 경로로 보낼지 결정하는 것이다. 이것을 routing이라고 생각하면 된다.
예를 들어 다음과 같은 흐름이 가능하다.
요청
↓
문제의 구조와 난이도 판단
↓
빠른 선택으로 충분 ─────→ System 1 scorer / classifier / verifier
↓ 아니오
짧은 추론으로 해결 ─────→ bounded reasoning
↓ 여전히 불확실
긴 추론·검색 필요 ──────→ System 2 generation
↓
검증 또는 escalation
여기서 bounded reasoning은 추론을 하되 무한히 오래 생각하지 않고 일정한 계산 예산 안에서 끝내는 방식이다. escalation은 빠른 경로가 자신 있게 판단하지 못할 때 더 강한 모델이나 더 긴 reasoning으로 넘기는 것이다.
이렇게 보면 inference optimization의 단위는 모델 하나가 아니라 route, 즉 계산 경로 전체가 된다. 닫힌 선택지가 있고 동일한 후보가 반복되는 도구 선택은 빠른 scorer가 유리하다. 여러 후보 중 최선 하나를 고르는 문제는 verifier나 ranker로 분리할 수 있다. 반대로 새로운 가설을 만들거나 설계 대안을 비교하는 open-ended task는 생성형 reasoning이 필요하다.
핵심은 처음부터 모든 요청을 가장 비싼 경로로 보내지 않는 것이다.
그렇다고 긴 reasoning의 가치가 줄어든 것은 아니다
Don't Overthink it만 보면 “thinking token은 줄일수록 좋다”는 결론으로 가기 쉽다. 하지만 다른 test-time scaling 연구는 그 반대 사례를 분명히 보여준다.
Snell 등은 같은 inference compute라도 문제의 난이도에 따라 효과적인 사용법이 다르다는 점을 분석했다. 문제별로 test-time compute를 적응적으로 배분하는 compute-optimal 전략은 연구 설정에서 best-of-N baseline보다 4배 이상 효율적이었다. 일부 문제에서는 작은 base model에 더 많은 test-time compute를 주는 방식이 FLOPs를 맞췄을 때 14배 큰 모델보다 높은 성능을 보이기도 했다.[^3]
s1 연구에서도 reasoning을 강제로 일찍 끊거나, 반대로 모델이 끝내려 할 때 Wait을 추가해 더 생각하도록 만드는 budget forcing을 실험했다. 어려운 AIME24 문제에서는 추가 reasoning을 허용했을 때 성능이 50%에서 57%로 올라갔다.[^4]
즉 Don't Overthink it과 이런 연구는 서로 반대되는 결론이 아니다. 쉬운 문제까지 오래 생각하는 것은 낭비일 수 있지만, 필요한 문제에서 충분히 생각하지 않는 것 역시 손실이다. 따라서 최적 정책은 짧게도 길게도 아니다. 필요한 만큼이다.
이 차이가 중요하다. AI inference 최적화의 목표가 “토큰을 최대한 아끼자”라면 어려운 문제에서 성능이 무너질 수 있다. 반대로 “최대한 많이 생각시키자”가 기본값이면 쉬운 문제에서 비용과 지연이 불필요하게 커진다. 결국 좋은 시스템은 문제마다 다른 계산량을 배정해야 한다.
그래서 추론 예산을 고르는 작은 control plane이 생길 수 있다
이 문제를 시스템 설계로 옮기면 새로운 계층이 하나 생긴다. 모델에게 바로 요청을 보내는 대신, 요청의 구조와 현재 확신도, 실패비용을 보고 reasoning budget을 정하는 control layer다.
여기서 control plane은 네트워크나 클라우드에서 자주 쓰는 표현을 빌린 것이다. 실제 작업을 직접 수행하기보다 어떤 자원을 어디에 얼마나 배분할지를 결정하는 작은 운영 계층이라고 이해하면 된다.
최근 CoRefine은 이 방향을 꽤 직접적으로 실험했다. frozen LLM 위에 약 21만 개 파라미터의 작은 controller를 두고, reasoning trace의 confidence를 읽어 stop, 다시 검토, 다른 접근 시도 가운데 하나를 고르게 했다. 논문은 평균 2.7회의 refinement로 512-sample parallel baseline에 비해 token 사용량을 크게 줄이면서 경쟁력 있는 정확도를 유지했다고 보고한다.[^5]
여기에서 confidence를 정답의 증명으로 이해해서는 안 된다. 모델이 자신 있다고 느끼는 것과 실제로 맞는 것은 다를 수 있다. 연구진도 confidence를 correctness guarantee가 아니라 다음 계산을 더 쓸 가치가 있는지를 판단하는 control signal로 다룬다.
실제 제품에서는 이 signal이 하나일 필요도 없다. 선택지 사이의 score margin이 큰지, verifier가 결과를 명확하게 판정할 수 있는지, 후보들이 서로 크게 갈리는지, 이전 단계가 실패했는지, 이번 행동의 실패비용이 높은지, 사용자가 latency보다 정확성을 우선하는지 등을 함께 볼 수 있다.
이런 정보를 조합하면 inference budget은 고정된 low / medium / high 옵션이 아니라 작업별 정책으로 바뀔 수 있다. 예를 들어 쇼핑 검색 결과를 정렬하는 문제와, 고객 대신 실제 결제를 승인하는 문제는 같은 신뢰수준을 요구하지 않는다. 첫 번째는 빠른 scorer로 충분할 수 있지만, 두 번째는 reasoning뿐 아니라 verifier와 permission gate까지 붙는 편이 낫다.
즉 계산량은 문제의 난이도뿐 아니라 실패했을 때의 비용에도 따라 달라져야 한다.
에이전트에서는 ‘잘 생각하는 모델’보다 ‘어디에 생각을 쓸지 아는 시스템’이 더 중요해질 수 있다
에이전트 작업은 이 구조가 특히 잘 드러나는 영역이다. 하나의 장기 작업 안에는 파일 목록을 보고 다음 파일을 고르는 일, 이미 알려진 명령을 실행하는 일, 테스트 실패를 분류하는 일, 새로운 수정전략을 세우는 일, 외부 시스템에 실제 변경을 적용하는 일이 모두 섞여 있다. 전부 “에이전트가 하는 일”이지만 필요한 사고 수준은 완전히 다르다.
모든 step에 frontier reasoning model을 최대 effort로 쓰면 품질은 높아질 수 있지만 비용과 latency가 누적된다. 반대로 모든 step을 작은 classifier에 넘기면 distribution shift나 새로운 상황에서 쉽게 무너질 수 있다. 그래서 역할을 나누는 편이 합리적이다.
| 작업 형태 | 쉽게 말하면 | 기본적으로 유리한 경로 |
|---|---|---|
| 반복되는 closed-set routing | 정해진 후보 중 하나 고르기 | 빠른 scorer / System 1 |
| 여러 후보 중 최선 선택 | 답을 만들기보다 판정하기 | verifier / ranker |
| 정답 기준이 명확한 단순 수정 | 짧게 생각하면 충분한 일 | bounded reasoning |
| 새로운 설계·가설·계획 | 답 자체를 새로 만들어야 하는 일 | 긴 generative reasoning / System 2 |
| 확신이 낮거나 후보가 충돌 | 빠른 판단이 불안한 상황 | 추가 compute 또는 stronger model |
| 실패비용이 큰 외부 행동 | 돈·배포·삭제처럼 되돌리기 어려운 일 | reasoning + verification + permission gate |
이 구조에서 frontier model은 사라지지 않는다. 오히려 더 비싼 reasoning을 정말 필요한 순간에 집중시키는 자원이 된다.
이런 관점은 AI 서비스의 원가 구조를 볼 때도 중요하다. 한 번의 어려운 수학 문제를 잘 푸는 benchmark와 하루에 수백만 개의 작은 판단을 처리하는 제품은 최적 inference architecture가 다르다. 후자에서는 요청 하나당 1~2초의 추가 latency와 몇백 token의 불필요한 reasoning도 전체 서비스 규모에서는 거대한 비용으로 누적된다.
예를 들어 하루 천만 번 반복되는 내부 routing에서 요청당 300개의 불필요한 reasoning token을 줄일 수 있다면, 절감되는 계산량은 더 이상 사소한 최적화가 아니다. 반대로 전체 요청의 1%에 불과하지만 실패하면 큰 손실이 발생하는 작업에는 훨씬 더 많은 추론과 검증을 써도 경제적으로 합리적일 수 있다.
다음 benchmark는 정확도만이 아니라 ‘정확도를 얻는 비용’을 같이 봐야 한다
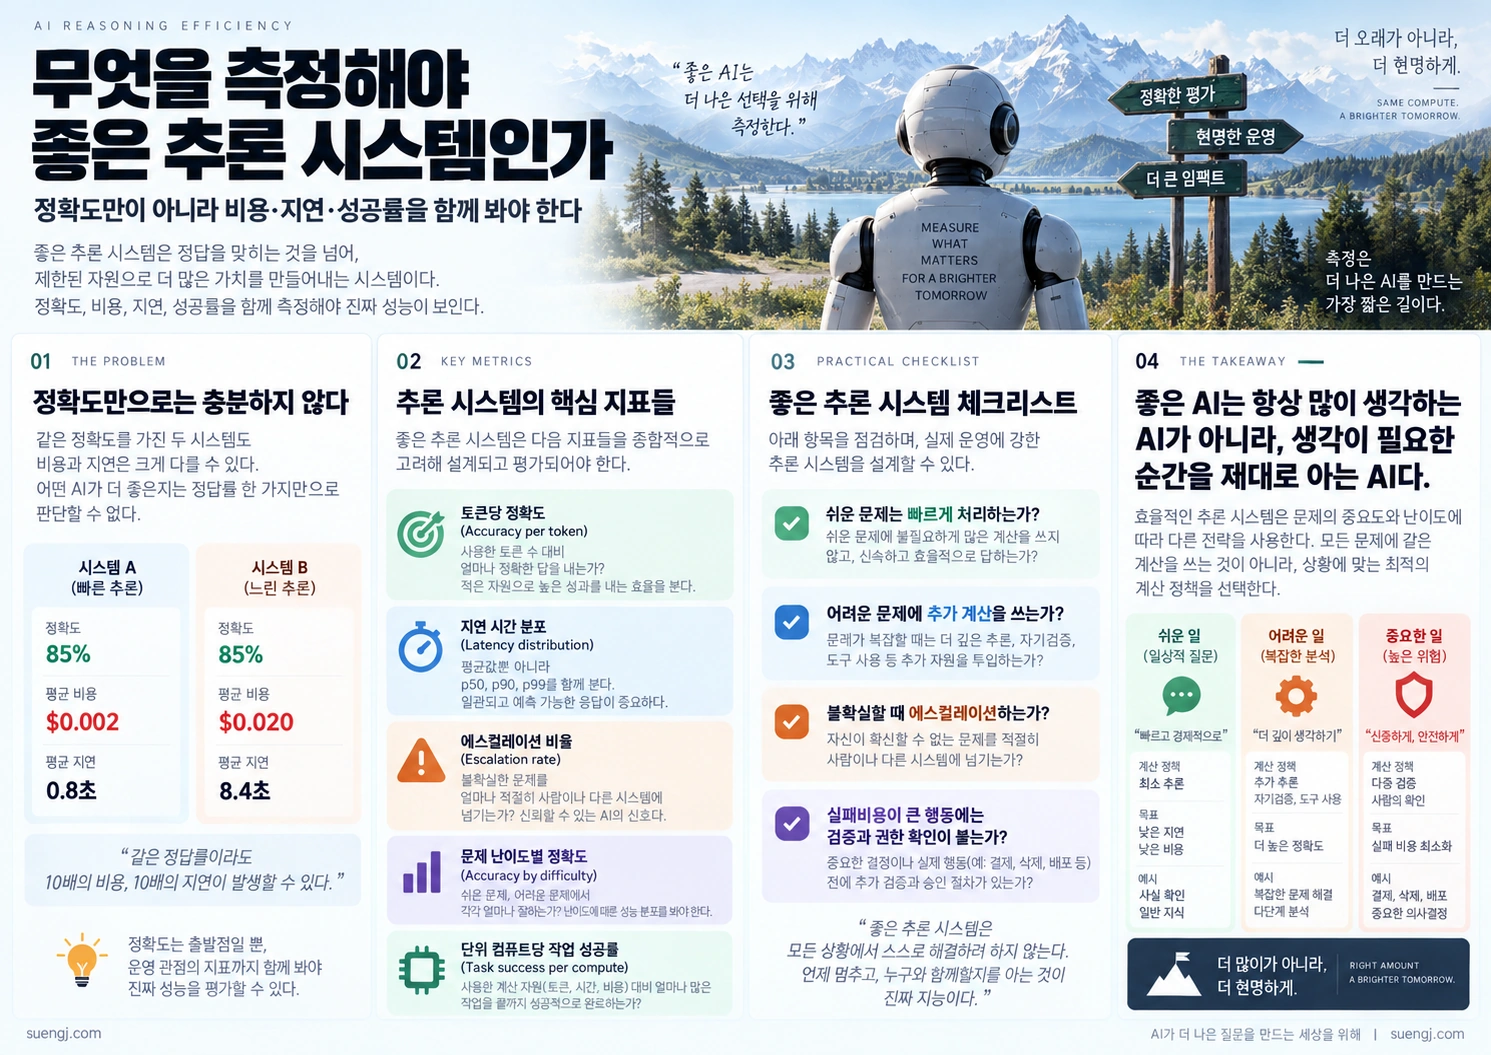
추론 모델을 단순 정확도로만 비교하면 이 변화가 잘 보이지 않는다. 같은 90% 정확도라도 한 모델은 모든 문제에 긴 chain을 쓰고, 다른 시스템은 쉬운 문제 대부분을 빠르게 처리한 뒤 어려운 일부만 깊게 생각할 수 있다. 평균 정확도만 보면 둘은 비슷하지만 사용자 경험과 서비스 원가에서는 전혀 다른 시스템이다.
앞으로는 최소한 몇 가지 지표를 함께 볼 필요가 있다.
Accuracy per token은 같은 품질을 얻기 위해 얼마나 많은 생성비용을 썼는지 보여준다. Latency distribution은 평균 응답시간뿐 아니라 p95·p99처럼 느린 요청에서 reasoning이 얼마나 길어지는지 보여준다. Escalation rate는 빠른 경로가 몇 퍼센트의 요청을 더 비싼 모델이나 더 긴 reasoning으로 넘기는지 알려준다. Accuracy by difficulty는 compute를 줄였을 때 쉬운 문제만 좋아지고 어려운 문제가 무너지는지 확인하게 한다.
에이전트에서는 여기에 task success per unit compute를 붙이는 편이 낫다. 한 step의 분류 정확도가 높아도 잘못된 결정 하나가 전체 작업을 망가뜨리면 의미가 없다. 반대로 일부 step에 더 많은 계산을 쓰더라도 전체 작업 성공률이 크게 올라간다면 그 비용은 정당화될 수 있다.
결국 benchmark도 “누가 더 똑똑한가”에서 “누가 필요한 성능을 더 효율적으로 만들어내는가”로 이동해야 한다.
이 구조가 항상 맞는 것은 아니다
System 1식 scorer가 강하려면 후보 공간이 어느 정도 정의돼 있어야 한다. 새로운 도구가 계속 생기거나 행동 자체를 새로 만들어야 하는 환경에서는 cached candidate ranking의 장점이 줄어든다.
distribution shift도 문제다. 이것은 학습하거나 익숙했던 상황과 실제 들어온 상황의 분포가 달라지는 것을 말한다. 반복적으로 본 state-action 구조에서는 빠른 classifier가 잘 작동해도, 처음 보는 상황에서는 자신 있게 틀릴 수 있다. 이런 경우에는 단순 confidence뿐 아니라 out-of-distribution 신호를 감지해 generative reasoning으로 넘길 장치가 필요하다.
또 미래의 foundation model이 내부적으로 reasoning 길이를 매우 효율적으로 조절하게 되면 별도의 외부 router가 제품에서 보이지 않을 수도 있다. 그러나 그 경우에도 경제적 원리는 남는다. 모델 내부에서 조절하든 외부 control plane에서 조절하든 추가 계산이 실제 품질을 높일 때만 더 쓰는 것이 합리적이라는 점은 같다.
AI의 다음 경쟁은 ‘더 오래 생각하기’보다 ‘생각을 배분하기’에 가까울 수 있다
지금 나타나는 변화는 “빠른 모델이 느린 모델을 대체한다”는 이야기가 아니다. 오히려 AI stack이 더 전문화되는 과정에 가깝다.
생성해야 할 것은 생성하고, 고르기만 하면 되는 것은 빠르게 고른다. 검증 가능한 것은 별도의 verifier로 확인하고, 불확실하면 더 강한 모델이나 더 긴 reasoning으로 넘긴다. 실패비용이 큰 행동에는 permission과 verification을 추가한다.
이렇게 보면 reasoning model의 다음 경쟁력은 생각의 최대 길이가 아닐 수 있다. 어디에서 생각을 멈출지, 어디에서 더 생각할지, 그리고 어디에서는 애초에 긴 생각을 생성할 필요가 없는지를 구분하는 능력이 더 중요해질 수 있다.
AI inference가 대규모 서비스와 장기 실행 에이전트로 들어갈수록 이 판단은 모델 바깥의 작은 최적화가 아니라 전체 시스템의 성능과 비용을 결정하는 핵심 설계 문제가 될 가능성이 크다.
사용자 입장에서는 이 변화가 비교적 단순한 결과로 나타날 것이다. 쉬운 일은 더 빠르고 싸게 끝나고, 어려운 일에는 더 많은 계산이 투입되며, 중요한 일에는 검증과 권한 확인이 추가된다. 좋은 AI 시스템은 항상 많이 생각하는 시스템이 아니라, 생각이 필요한 순간을 제대로 아는 시스템에 가까워질 수 있다.
[^1]: Contrastive-LM, “Contrastive Language Models: A System One Model for Fast and Generalizable Decision-Making,” 2026. https://github.com/Contrastive-LM/CLM [^2]: Michael Hassid et al., “Don't Overthink it. Preferring Shorter Thinking Chains for Improved LLM Reasoning,” arXiv:2505.17813, first submitted May 23, 2025; revised 2026. https://arxiv.org/abs/2505.17813 [^3]: Charlie Snell et al., “Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters,” arXiv:2408.03314, August 2024. https://arxiv.org/abs/2408.03314 [^4]: Niklas Muennighoff et al., “s1: Simple test-time scaling,” arXiv:2501.19393, January 2025. https://arxiv.org/abs/2501.19393 [^5]: Chen Jin et al., “CoRefine: Confidence-Guided Self-Refinement for Adaptive Test-Time Compute,” arXiv:2602.08948, February 2026. https://arxiv.org/abs/2602.08948