9월 15일 TypeSafe AI가 Jev를 공개한 뒤, 시장의 관심은 곧바로 속도와 가격 숫자에 쏠렸다. 회사는 자체 workflow 평가에서 최대 193.6배 빠르고 444.6배 저렴했다고 발표했고, Vercel은 Jev가 AI Gateway에 올라온 뒤 24시간 안에 유료 팀의 약 13%에서 사용돼 자사 Gateway 역사상 가장 빠르게 채택된 모델이라고 밝혔다.[^1][^2]
하지만 Jev에서 더 흥미로운 부분은 “기존 LLM보다 몇 배 싸다”는 숫자가 아니다. 그 숫자는 아직 공급사 자체 평가에 크게 의존하고 있고, TypeSafe도 해당 workflow가 자사 capability 팀이 만든 것이어서 편향 가능성이 있으며 193.6배·444.6배는 현실적 이득의 상단에 가까울 것이라고 직접 적었다.[^1]
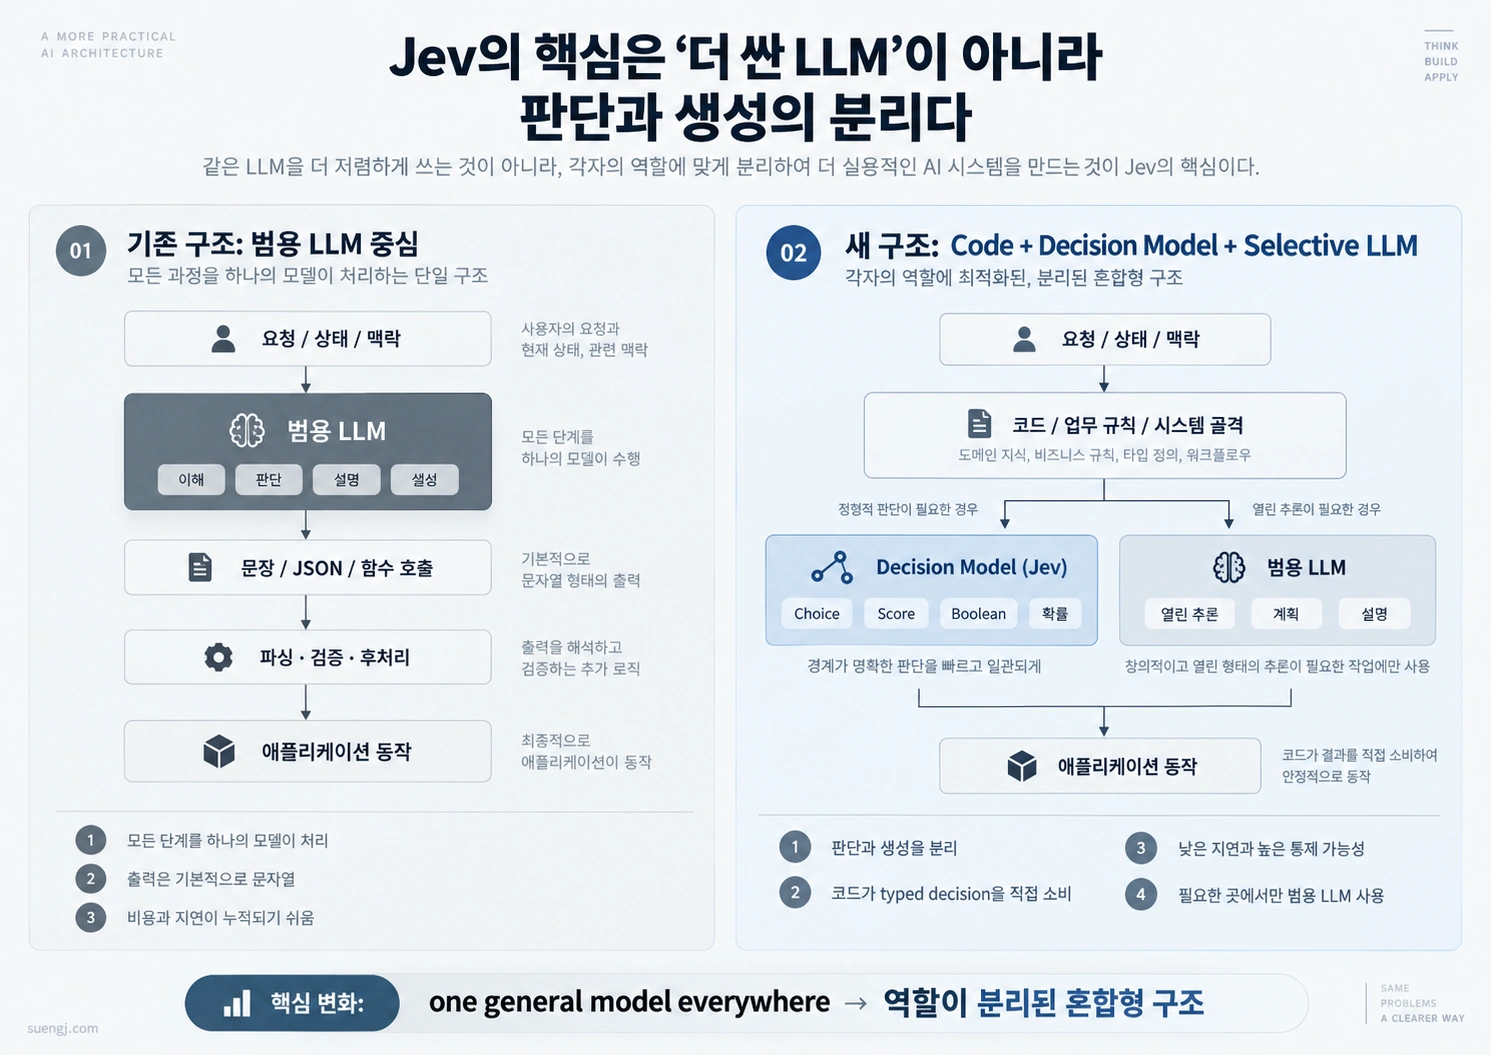
더 중요한 변화는 소프트웨어 안에서 ‘문장을 생성하는 일’과 ‘판단하는 일’을 서로 다른 계산 문제로 분리하려는 시도다. Jev는 긴 자연어 답을 만든 뒤 코드가 다시 해석하는 대신, 프로그램이 미리 정의한 선택지·점수·참/거짓 질문에 확률을 붙여 바로 반환한다. 이 방식이 실제 운영에서도 충분히 정확하고 잘 보정된다면, 에이전트 시스템의 기본 구조가 “모든 것을 하나의 범용 LLM에게 묻는 방식”에서 코드 + 빠른 판단 모델 + 필요한 곳에서만 범용 LLM로 바뀔 수 있다.
LLM이 잘하는 일과 소프트웨어가 필요한 출력은 항상 같지 않다
범용 LLM의 강점은 열린 문제를 다룬다는 데 있다. 모호한 질문을 해석하고, 여러 가능성을 검토하고, 긴 설명이나 코드를 만들어 낼 수 있다. 대신 결과는 기본적으로 문자열이다. 구조화 출력이나 function calling을 쓰더라도, 일반적인 생성 모델은 여전히 토큰을 순차적으로 만들어 결과를 구성한다.
소프트웨어 내부의 많은 판단은 그렇게 열려 있지 않다. 고객 문의를 사람에게 넘길지, 에이전트가 다음 도구를 무엇으로 선택할지, 실패한 작업을 재시도할지 중단할지, 로그의 위험도를 어느 수준으로 볼지처럼 가능한 행동이 이미 제한되어 있는 경우가 많다.
Jev는 바로 이 구간을 겨냥한다. Vercel의 Jev 통합 설명을 보면 입력으로 상태(state)와 질문을 보내고, 출력으로 Choice, Score, Boolean 같은 typed answer와 확률을 받는다. 여러 질문도 한 요청 안에서 병렬 평가할 수 있다.[^3] 즉 모델의 결과를 사람이 읽는 완성 문장으로 만들 필요가 없다. 코드가 소비할 판단 값이면 충분하다.
이 차이는 사소해 보이지만 시스템 설계에서는 크다. 예를 들어 일반 LLM에게 “이 요청을 자동 승인해도 되는지 판단하고 이유를 JSON으로 써라”라고 시키면 모델은 판단, 설명, 형식 준수를 한 번에 수행한다. 이후 프로그램은 응답을 파싱하고 스키마를 검증하며 잘못된 형식이나 모호한 출력을 처리해야 한다.
반대로 필요한 질문을 승인 가능 여부, 위험 수준, 사람 검토 필요 여부처럼 미리 쪼개고 각 판단을 typed value로 받으면, 업무 규칙은 다시 코드 쪽으로 돌아온다. AI는 애매한 부분을 판단하고, 어떤 판단을 조합해 어떤 행동으로 이어갈지는 프로그램이 통제한다.
구조화 출력의 개선이라기보다 ‘지능의 인터페이스’를 바꾸려는 접근에 가깝다
겉으로만 보면 이것은 기존 LLM의 JSON mode나 structured output과 크게 다르지 않아 보인다. 실제로 최종 결과만 놓고 보면 둘 다 정해진 스키마를 반환할 수 있다.
TypeSafe가 주장하는 차이는 출력 형식보다 모델이 최적화된 대상에 있다. Jev는 문자열 생성 자체를 포기하고, 여러 판단을 병렬로 계산하는 sampler와 Reinforcement Learning for Calibrated Decisions(RLCD)라는 학습 방식을 사용한다고 설명한다. 회사가 공개한 가격은 입력 100만 토큰당 0.042달러이며, 별도의 생성 토큰 비용을 받지 않는다. 공식적으로 제시하는 응답시간도 70~500ms 범위다.[^1]
따라서 핵심 질문은 “JSON을 잘 반환하느냐”가 아니다. 자연어 생성이 필요 없는 판단을 굳이 자연어 생성 모델의 전체 비용 구조로 처리할 필요가 있느냐가 더 정확한 질문이다.
이 관점은 최근 에이전트 설계와 특히 잘 맞는다. 에이전트 한 번의 실행을 자세히 보면 긴 답을 만드는 순간보다 작은 판단을 반복하는 순간이 많다. 다음 도구를 고르고, 결과가 충분한지 확인하고, 오류를 재시도하고, 사람에게 넘길지를 결정하고, 최종 응답 전에 정책 위반 가능성을 점검한다.
이 모든 단계를 최고 성능 LLM 호출로 처리하면 구현은 단순하지만 latency와 비용이 누적된다. 반대로 판단의 범위가 명확한 단계만 빠른 decision model로 분리하고, 계획 수립이나 복잡한 해석처럼 열린 추론이 필요한 순간에만 범용 LLM을 호출하면 시스템의 계산 구조 자체가 달라진다.
에이전트의 다음 병목은 모델 선택보다 ‘어떤 판단을 모델에 맡길 것인가’일 수 있다
Vercel이 Jev의 사용 사례로 제시하는 항목도 대부분 생성보다 분기에 가깝다. 다음 tool 또는 subagent 선택, 계속 진행할지 재시도할지 판단, 사용자에게 다시 물을지 중단할지 결정, 위험도 점수화, 불확실한 사례의 human review 전환이 대표적이다.[^2][^3]
이런 작업에서는 모델 하나의 benchmark 점수보다 업무를 어디까지 분해했는지가 더 중요해진다.
가령 고객지원 에이전트를 생각해 보자. 하나의 거대한 프롬프트에 고객 이력, 결제 정보, 정책, 대화 기록을 모두 넣고 “다음 행동을 결정하라”고 요청할 수 있다. 다른 방법은 의도, 긴급도, 환불 가능성, 부정사용 위험, 사람 이관 필요성을 각각 독립적인 질문으로 만들고 마지막 행동 조합은 코드로 처리하는 것이다.
TypeSafe의 workflow eval도 후자의 방식을 전제로 한다. 업무를 작은 판단으로 분해하고, deterministic rule로 처리할 수 있는 부분은 코드에 남기며, 애매한 판단만 모델에 보낸다.[^4] 공급사 자체 평가라는 한계는 있지만, 이 설계 원칙 자체는 Jev의 성능 숫자와 별개로 볼 가치가 있다.
에이전트 비용을 줄이기 위해 저렴한 모델로 단순 routing을 하는 방식은 이미 널리 쓰인다. Jev가 한 단계 더 나아가는 지점은 routing용 모델도 결국 대화형 LLM의 축소판이어야 하는가라는 질문이다. 판단이 몇 개의 선택지와 확률로 표현될 수 있다면, 해당 구간에는 애초에 문장 생성 능력이 필요 없을 수 있다.
가장 중요한 출력은 답보다 ‘얼마나 확신하는가’다
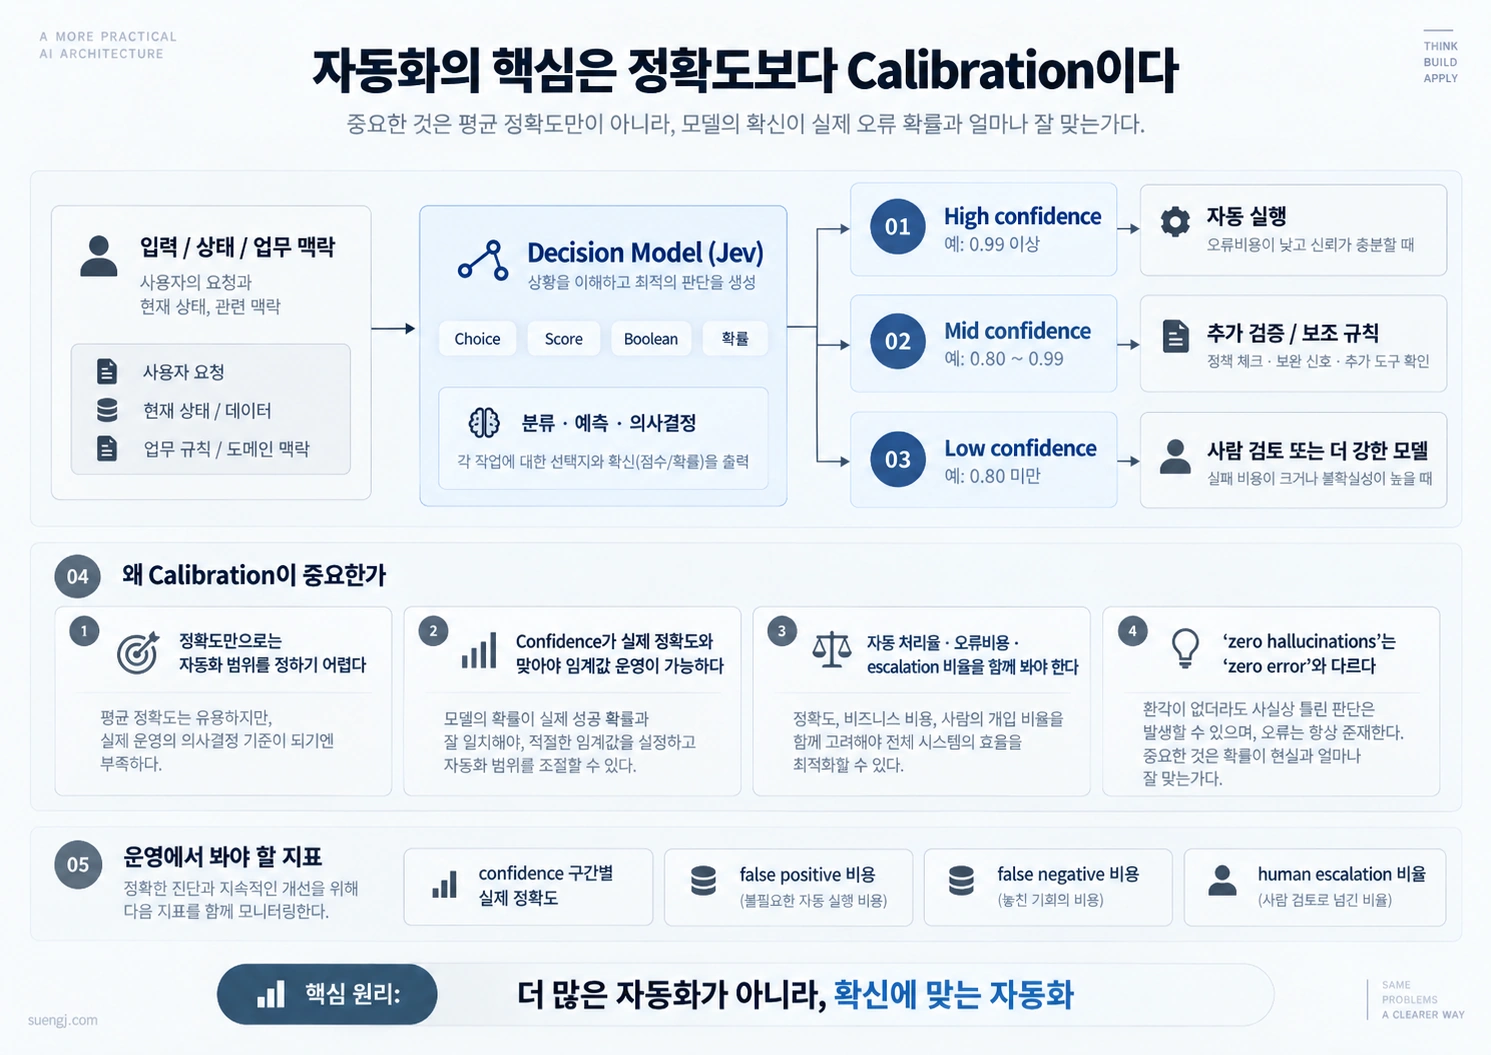
자동화에서 모델의 평균 정확도만 보는 것은 위험하다. 정확도가 95%인 모델이라도 틀리는 5%를 스스로 구분하지 못하면 모든 사례를 자동 실행하기 어렵다. 반대로 confidence가 실제 오류 확률과 잘 맞는다면 코드가 자동화 범위를 조절할 수 있다.
예를 들어 환불 판단의 confidence가 0.99 이상일 때만 자동 처리하고, 0.8~0.99는 추가 검사를 거치며, 그 아래는 사람에게 넘기는 식이다. 이 경우 중요한 KPI는 단순 정확도보다 confidence 구간별 실제 정확도, false positive/negative 비용, human escalation 비율이 된다.
TypeSafe가 RLCD와 calibrated probability를 강조하는 이유도 여기에 있다. 모델이 판단뿐 아니라 불확실성을 함께 반환하면, 자동화 수준을 코드가 결정할 수 있다는 것이다.[^1][^5]
다만 여기에는 중요한 구분이 필요하다. TypeSafe가 말하는 “zero hallucinations”는 주로 스키마 밖의 값을 생성하지 않는 type-safety를 뜻한다. 정해진 선택지 중 틀린 선택을 하지 않는다는 뜻은 아니다. 실제 TypeSafe의 Master Customer Agreement도 서비스가 부정확하거나 오류가 있는 출력을 만들 수 있으며 고객이 결과를 독립적으로 평가해야 한다고 명시한다.[^6]
따라서 Jev의 확률을 곧바로 운영 신뢰도로 받아들이면 안 된다. 실제 도입에서는 각 업무의 private eval로 calibration curve를 확인하고, 임계값을 바꿨을 때 자동 처리율과 오류비용이 어떻게 움직이는지 먼저 측정해야 한다.
‘200배 빠르고 400배 싸다’는 숫자는 출발점이지 결론이 아니다
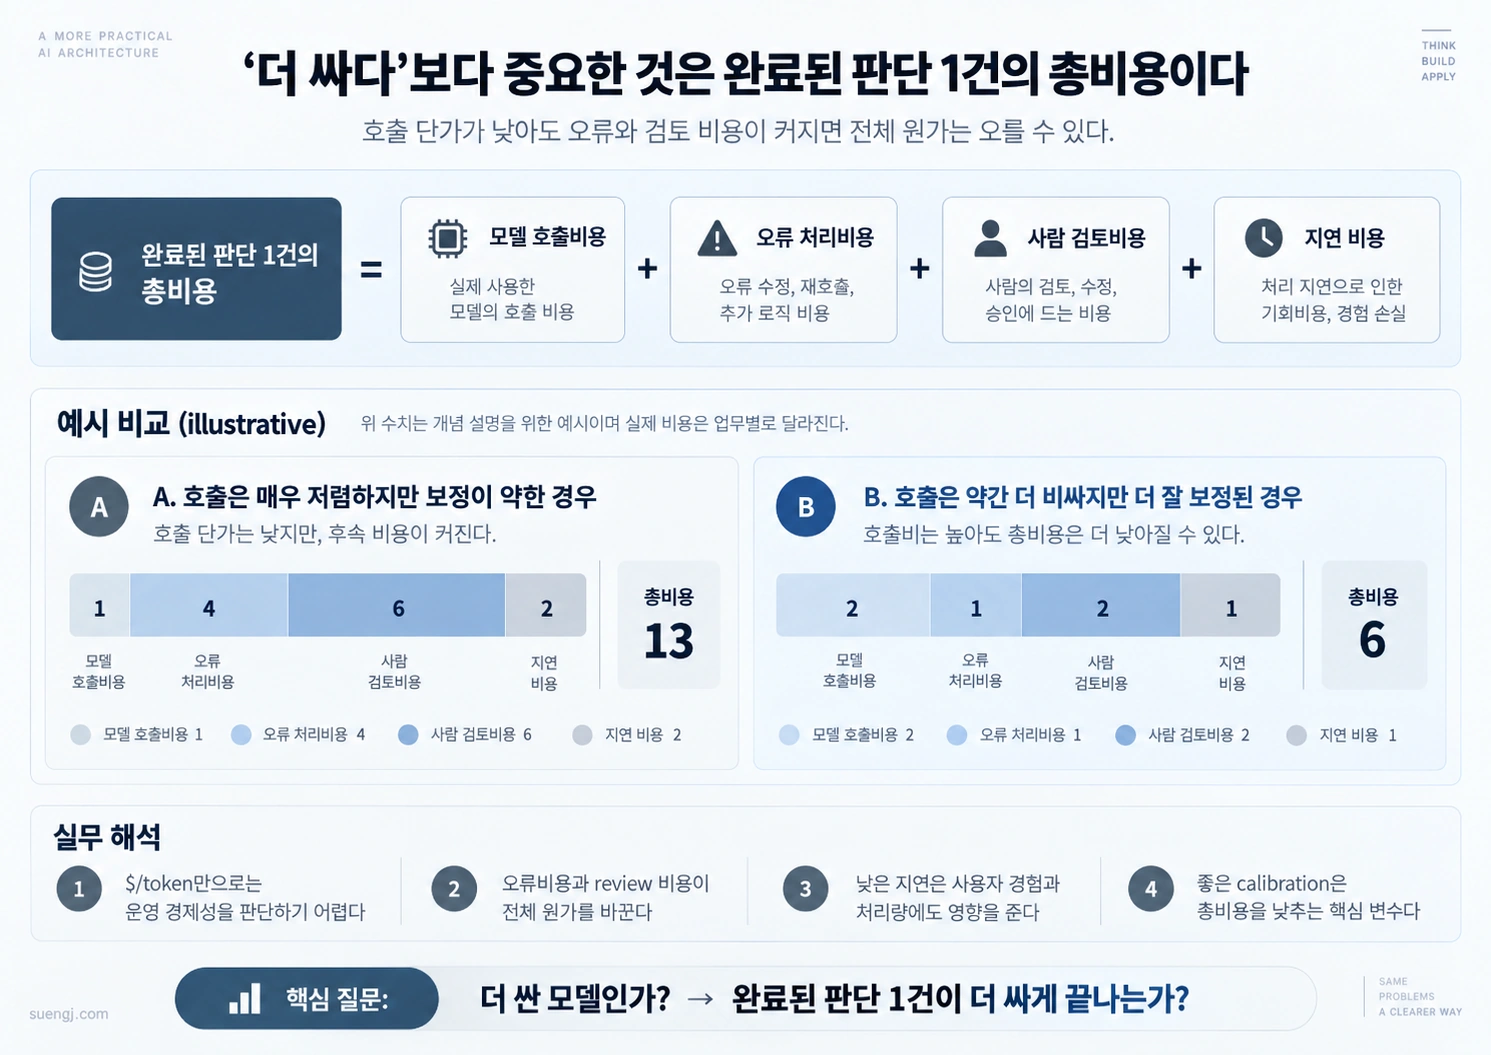
Jev를 둘러싼 가장 강한 홍보 문구는 193.6배의 속도와 444.6배의 비용 차이다. 이 수치가 가능한 이유 자체는 이해하기 어렵지 않다. 생성 토큰을 길게 만들지 않고 여러 제한된 판단을 병렬로 계산한다면, 같은 문제를 긴 언어 생성으로 풀 때보다 훨씬 싸고 빨라질 여지가 있다.
하지만 그 숫자를 일반적인 “LLM 대비 성능”으로 읽으면 안 된다. TypeSafe도 해당 결과가 System One task에 맞춘 workflow에서 나온 것이고, 비교 workflow를 자사 팀이 만들었으며, 공개한 최대 개선폭이 현실의 상단에 가까울 수 있다고 적었다.[^1] 서로 다른 종류의 문제를 같은 가격표로 비교하는 셈이 될 수 있기 때문이다.
그래서 실제 도입 판단은 단순한 $/token보다 다음 식에 가까워져야 한다.
완료된 판단 1건의 비용 = 호출비용 + 오류처리비용 + 사람 검토비용 + 지연이 만든 비용
Jev가 낮은 호출비용을 제공하더라도 오판으로 human review가 급증하면 전체 원가는 올라간다. 반대로 범용 LLM보다 약간 덜 정확하더라도 확실한 사례만 자동으로 처리하고 애매한 사례를 정확히 걸러낸다면 총비용은 크게 낮아질 수 있다.
Vercel에서 출시 직후 빠르게 채택된 것은 이 가설을 실험하려는 개발자 수요가 상당하다는 신호로 볼 수 있다. 다만 24시간의 초기 사용률은 지속적인 production adoption과 같은 뜻이 아니다. 신규 모델에 대한 실험 수요와 장기적인 워크로드 정착은 구분해야 한다.[^2]
범용 LLM을 대체하는 모델이라기보다 그 앞뒤에 들어가는 새로운 계층에 가깝다
Jev를 “LLM 이후의 새로운 AI”로 해석하면 오히려 핵심을 놓치기 쉽다. 열린 문제를 이해하고 새로운 문장을 만들며 복잡한 계획을 세우는 일은 여전히 범용 생성 모델이 강하다. Jev는 그 능력을 없애는 대신 이미 선택 공간이 정의된 판단을 더 싸고 빠르게 처리하는 계층을 제안한다.
성공적인 구조는 오히려 혼합형일 가능성이 높다.
사용자의 모호한 요청을 이해하거나 계획을 다시 짜야 할 때는 범용 LLM을 사용한다. 반복적으로 나타나는 분기, 검증, routing, scoring은 Jev 같은 decision model로 내린다. 규칙이 명확한 부분은 아예 모델을 호출하지 않고 코드로 처리한다. 그리고 confidence가 낮거나 실패 비용이 큰 구간은 사람 또는 더 강한 모델로 상향 전환한다.
이 구조가 자리 잡으면 “어떤 모델이 가장 똑똑한가”보다 “이 단계에 어느 정도의 지능이 필요한가”가 시스템 설계의 중심 질문이 된다. 모델 선택이 아니라 지능을 어디에 배치할지 결정하는 문제가 된다.
Jev의 가장 흥미로운 가능성은 바로 여기에 있다. 지금까지 많은 AI 시스템은 자연어 모델을 중심에 두고 주변 코드를 붙였다. System One 접근은 반대로 코드가 시스템의 골격을 유지하고, AI를 여러 개의 제한된 판단 함수처럼 삽입한다.
이 가설이 틀렸다고 볼 조건도 분명하다
아직 Jev는 출시 초기다. 장기적인 신뢰성, 다양한 도메인의 calibration, 높은 부하에서의 latency, 실제 enterprise SLA 같은 항목은 더 많은 운영 데이터가 필요하다.
첫째, 자체 private eval에서 confidence와 실제 정확도가 잘 맞지 않는다면 확률 기반 자동화의 장점은 크게 줄어든다. 둘째, 업무를 작은 판단으로 분해하고 유지하는 engineering cost가 너무 크다면 저렴한 추론비용이 상쇄될 수 있다. 셋째, 범용 소형 LLM이 비슷한 latency와 가격에서 충분히 안정적인 structured output을 제공하게 되면 별도 decision model의 경제적 공간이 좁아질 수 있다. 넷째, 실제 업무가 예상보다 훨씬 자주 열린 추론을 요구한다면 Jev가 담당할 수 있는 구간 자체가 작아진다.
반대로 여러 production workflow에서 좁은 판단을 안정적으로 떼어낼 수 있고, calibration을 이용해 사람 검토를 줄이면서도 오류비용을 통제할 수 있다면 Jev는 단순한 초저가 모델 이상의 의미를 갖는다.
그때의 변화는 “더 싼 AI가 나왔다”가 아니다. 소프트웨어가 지능을 소비하는 기본 인터페이스가 문장에서 판단으로 넓어지는 것이다. 그리고 에이전트 시스템은 하나의 거대한 모델 호출보다, 코드와 서로 다른 종류의 모델이 역할을 나눠 갖는 쪽으로 더 빠르게 진화할 수 있다.
[^1]: TypeSafe AI, “Introducing System One Models & Jev,” September 15, 2026. https://typesafe.ai/blog/introducing-system-one-models-and-jev [^2]: Vercel, “Jev is the fastest-adopted model in AI Gateway history,” September 18, 2026. https://vercel.com/blog/ai-gateway-jev-model-launch [^3]: Vercel, “TypeSafe AI's Jev now available on AI Gateway,” September 16, 2026. https://vercel.com/changelog/typesafe-ai-jev-now-available-on-ai-gateway [^4]: TypeSafe AI, “Workflow evals.” https://evals.typesafe.ai/ [^5]: TypeSafe AI, “Home — System One Models / Jev.” https://typesafe.ai/ [^6]: TypeSafe AI, “Master Customer Agreement,” updated September 19, 2026. https://typesafe.ai/legal/mca