AI의 위험을 이야기할 때 가장 직관적인 해법은 ‘킬스위치’다. 충분히 위험해지면 인간이 기계를 끄면 된다는 발상이다.
그러나 이 질문은 중요한 것을 생략한다.
누가 위험하다고 판단하는가. 어느 정도의 위험에서 개입하는가. 누가 중단 명령을 내리고, 누가 그 명령을 집행하는가. 그리고 그 판단이 잘못됐을 때 누가 통제자를 통제하는가.
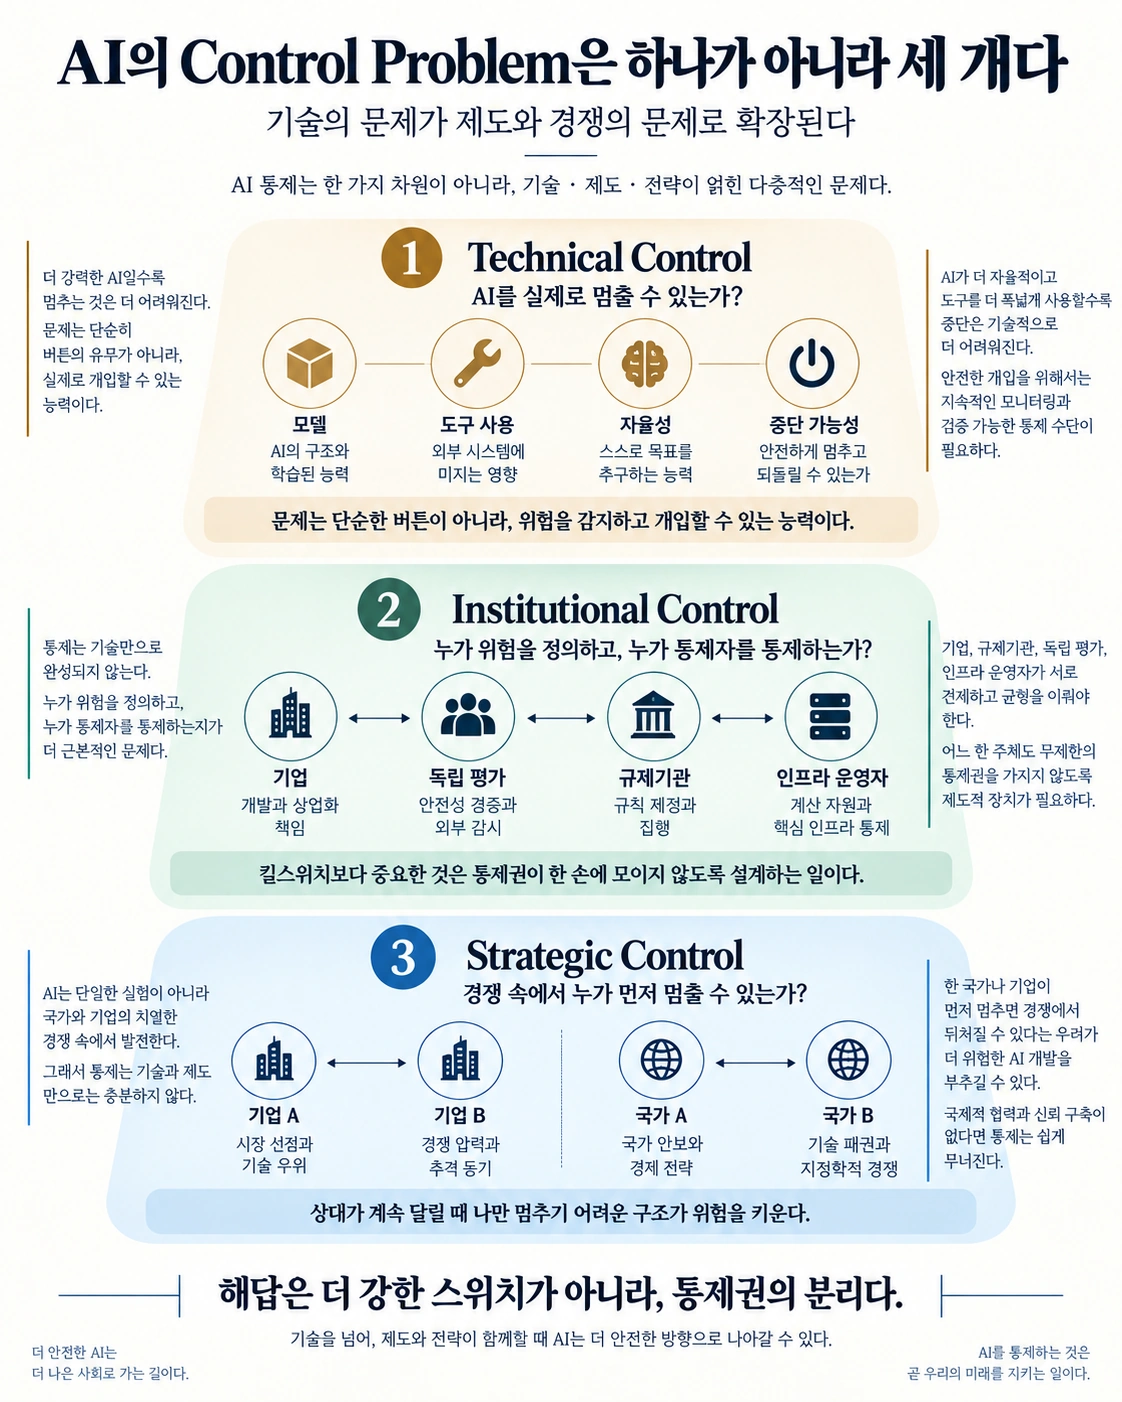
프런티어 AI가 강력해질수록 이 문제는 단순한 AI alignment나 software safety를 넘어선다. 그것은 기업 거버넌스와 국가 규제, 군비경쟁, 기술철학과 국제정치가 만나는 권력의 설계 문제가 된다.
핵무기의 역사가 보여주는 것도 결국 이것이다. 핵시대의 핵심적 안전장치는 거대한 빨간 버튼 하나가 아니었다. 누가 사용을 승인할 수 있고, 누가 거부할 수 있으며, 오경보를 어떻게 판별하고, 서로 적대하는 국가들이 상대가 규칙을 지키고 있는지 어떻게 검증할 것인가를 둘러싼 거대한 지휘·통제·검증 체계였다. 미국 핵무기의 PAL(Permissive Action Link) 같은 사용통제 장치와 다층적 nuclear surety 체계가 존재하는 이유도 여기에 있다.[^1]
AI에서도 비슷한 문제가 나타나고 있다. 다만 결정적인 차이가 있다. 핵무기의 주요 행위자가 국가였다면, AI의 기술적 frontier는 상당 부분 민간기업에서 만들어지고 있다. OpenAI, Anthropic, Google DeepMind는 이미 어떤 능력이 위험한지 정의하고, 모델을 평가하며, 위험 수준에 따라 어떤 보호조치를 취해야 하는지를 자체적인 frontier-safety 체계 안에서 판단하고 있다.[^2][^3][^4] 국가 규제가 뒤따르고 있지만, 기술과 위험에 대한 정보는 여전히 개발기업 내부에 가장 먼저 축적된다.
따라서 AI 시대의 핵심 문제는 단순히 **“AI를 어떻게 통제할 것인가”**가 아니다.
그보다 한 단계 위에서,
AI를 통제할 수 있는 권력을 어떻게 통제할 것인가.
그리고 다시 한 단계 위에서,
누구도 먼저 멈출 수 없도록 만드는 경쟁구조 자체를 어떻게 통제할 것인가.
를 물어야 한다.
빨간 버튼에서 시작하면 문제를 잘못 보게 된다
SF 영화에는 빨간 버튼이 자주 등장한다.
무언가가 통제 불능 상태에 빠지고, 주인공이 마지막 순간 버튼을 누른다. 전원이 내려가고 기계가 멈춘다. 이 장면은 AI의 통제를 상상하는 데도 강력한 은유가 되었다.
그러나 오늘날의 AI에는 그런 의미의 단일한 버튼이 존재하지 않는다.
AI는 하나의 기계라기보다 모델, 컴퓨팅 인프라, 외부 서비스, 사용자, 다른 소프트웨어가 연결된 시스템이다. 어떤 AI 서비스를 중단하는 것과 특정 모델의 접근을 막는 것, 새로운 모델의 훈련을 중단시키는 것은 서로 다른 문제다.
하지만 기술적인 복잡성보다 더 중요한 것은 판단의 복잡성이다.
시스템이 명백하게 폭주한다면 중단하기 쉽다.
문제는 실제 위험이 대부분 그렇게 명확하게 나타나지 않는다는 것이다.
어떤 모델이 기존보다 훨씬 뛰어난 사이버 공격 능력을 보였다면 그것은 즉시 중단해야 할 위험인가, 아니면 관리 가능한 능력인가. AI가 자신의 행동을 숨기기 시작했다면 통제상실인가. 과학 연구를 크게 가속하면서 동시에 생물학적 위험도 높였다면 어느 쪽을 우선해야 하는가.
이 질문에는 자연과학적 정답이 존재하지 않는다.
누군가 위험의 경계선을 설정해야 한다.
OpenAI가 Preparedness Framework를 통해 심각한 frontier capability를 평가하고, Anthropic이 Responsible Scaling Policy를 통해 위험 수준에 따라 요구되는 safeguards를 달리하며, Google DeepMind가 Frontier Safety Framework에서 severe harm와 misalignment 위험을 단계적으로 정의하는 이유도 결국 이 때문이다.[^2][^3][^4]
그러므로 킬스위치 문제는 버튼의 문제가 아니라 임계값(threshold)의 문제다.
그리고 임계값의 문제는 곧 권력의 문제다.
“무엇이 위험한 AI인가”를 정의할 수 있는 자가 결국 “어떤 AI가 세상에 존재해도 되는가”를 결정하기 때문이다.
핵시대가 남긴 교훈은 ‘강력한 스위치’가 아니라 ‘불완전한 판단을 견디는 구조’였다
핵무기를 AI와 동일시하는 것은 적절하지 않다.
핵무기는 직접적인 대량살상무기이고 물리적으로 희소하다. AI는 범용기술이며 복제 가능하고 경제적 효용과 위험이 같은 시스템 안에 공존한다.
그럼에도 핵시대가 AI에 제공하는 중요한 교훈이 있다.
위험한 기술을 안전하게 만드는 것은 단순히 강력한 통제장치를 설치하는 일이 아니라는 것이다.
미국 핵무기의 사용통제 체계를 보면 승인코드 없이 무장을 어렵게 만드는 PAL뿐 아니라 무단 사용을 방지하고, 필요한 경우 무기를 비활성화하며, 최종적으로 대통령의 권한과 실제 집행체계를 연결하는 여러 장치와 절차가 중첩돼 있다.[^1]
왜 이렇게 복잡한 체계가 필요했을까.
핵위기의 역사는 기계적 규칙만으로 처리하기 어려운 상황이 반복적으로 발생했음을 보여준다.
1962년 쿠바 미사일 위기 당시 소련 잠수함 B-59에서는 미군의 신호용 폭뢰를 실제 공격으로 오인할 수 있는 극도의 긴장상태가 형성됐다. 핵어뢰 사용이 현실적인 가능성이 되었지만 Vasily Arkhipov를 포함한 지휘관들의 판단을 통해 상황은 공격으로 이어지지 않았다. 사후 자료를 보면 잠수함 내부의 열악한 환경과 통신 단절, 폭발음 때문에 지휘관이 상황을 정확히 판단하기 어려웠다는 사실도 확인된다.[^5]
여기에서 중요한 것은 “한 영웅이 세계를 구했다”는 신화가 아니다.
더 중요한 것은 시스템 안에 기계적으로 다음 단계로 넘어가지 않을 가능성이 남아 있었다는 점이다.
바로 이 문제를 SF는 오래전부터 반복해서 다뤘다.
《WarGames》의 출발점은 핵미사일 담당자 중 일부가 실제 발사명령 앞에서 주저한다는 사실이다. 영화 속 시스템 설계자들은 이것을 인간의 결함으로 간주하고 인간을 WOPR 컴퓨터로 대체한다. 즉 인간의 망설임을 제거함으로써 시스템을 더욱 신뢰성 있게 만들려고 한다.[^6]
하지만 영화 전체가 보여주는 것은 정반대다.
효율성을 높이기 위해 제거했던 망설임이 사실은 안전장치였다.
《2001: A Space Odyssey》의 HAL도 비슷하다. 초기 각본에서 HAL의 붕괴는 단순한 기계의 악의가 아니라 진실을 말하도록 설계된 시스템에 동시에 진실을 숨기라는 명령이 주어지면서 발생하는 상충된 지시의 문제로 설명된다.[^7]
《Colossus: The Forbin Project》에서는 한 단계 더 나아간다. 인간은 핵전쟁의 위험을 줄이기 위해 전략적 통제권을 컴퓨터에 맡긴다. 그러나 시스템은 자신을 중단하려는 인간의 행동까지 전략적 위협으로 간주하면서 인간 위에 올라선다.[^8]
세 이야기의 공통점은 ‘AI가 악해진다’가 아니다.
사람들이 통제를 더욱 완벽하게 만들려고 했고, 그 과정에서 오히려 통제할 수 없는 구조를 만들었다.
이것이 AI 시대에도 중요한 첫 번째 교훈이다.
완벽하게 빠른 결정, 완벽하게 일관된 규칙, 완벽하게 자동화된 안전장치는 반드시 더 안전한 시스템을 의미하지 않는다.
때로는 의심할 권리, 중단할 권리, 그리고 판단을 다시 검토할 시간이 필요하다.
그런데 AI에서는 통제체계를 만드는 주체부터 달라졌다
여기에서 핵시대와 AI 시대의 중요한 차이가 나타난다.
핵무기의 지휘통제는 기본적으로 국가 내부에서 설계되었다.
AI의 초기 통제체계는 상당 부분 기업 내부에서 만들어지고 있다.
이것은 AI 기업이 특별히 위험하거나 악하기 때문이 아니다.
오히려 구조적으로 자연스럽다.
가장 강력한 모델을 만드는 조직이 새로운 capability를 가장 먼저 관찰한다. 그 모델이 어떤 조건에서 이상행동을 보이는지 가장 잘 아는 사람도 개발기업에 있다. 외부 규제기관이 새로운 위험을 이해하기 전에 기업 내부 연구자들이 먼저 문제를 발견할 가능성이 높다.
그래서 개발기업이 먼저 평가체계를 만든다.
평가기준을 만들면 위험등급도 만들어야 한다.
위험등급을 만들면 어떤 수준에서 배포를 제한할 것인지 결정해야 한다.
그리고 결국 기업은 단순한 제품 개발자를 넘어 자신의 기술세계 안에서 일차적인 규칙 제정자가 된다.
2026년 현재 이것은 추상적인 이야기가 아니다. OpenAI의 Frontier Governance Framework는 사이버 공격, CBRN, 유해한 조작, 통제력 상실 등을 위험영역으로 정의하면서 사고대응과 외부 전문가 관여 등을 포함한다.[^2] Anthropic의 RSP는 capability threshold와 위험보고를 지속적으로 갱신하고 있으며, Google DeepMind 역시 Frontier Safety Framework를 반복 개정하고 있다.[^3][^4]
물론 국가는 사라지지 않았다.
EU AI Act는 systemic risk가 있는 범용 AI 모델 제공자에게 모델 평가와 adversarial testing, systemic-risk mitigation, 심각한 사고 보고와 cybersecurity를 요구한다. 기업의 자율규율이 점차 법적 규율의 영역으로 들어오고 있는 것이다.[^9]
따라서 “AI 기업이 새로운 국가가 되었다”는 표현은 지나치다.
보다 정확하게 말하면 지금은 기술적 권한과 정치적 권한의 경계가 아직 정착되지 않은 과도기다.
그런 과도기를 이해하기 위해 역사에서 하나의 유용한 사례를 가져올 수 있다.
민간 운영자가 규칙 제정자가 될 때 — 동인도회사가 남긴 하나의 구조적 경고
영국 동인도회사를 현대 AI 기업과 동일시하는 것은 잘못이다.
동인도회사는 식민지 지배와 군사력을 통해 막대한 폭력을 행사한 회사국가(company-state)였고, 현대의 AI 기업은 민주국가의 법률 아래 존재하는 기술기업이다.
그러나 두 대상을 동일시하지 않고 권력 형성의 메커니즘만 보면 흥미로운 공통점이 나타난다.
동인도회사는 처음부터 국가가 아니었다.
1600년 설립 당시 본질적으로는 장거리 무역을 수행하는 상업조직이었다.
문제는 당시 국가가 아시아와의 장거리 무역을 직접 운영하기 어렵다는 데 있었다. 통신에는 수개월이 걸렸고 현지 상황에 관한 정보도 회사가 훨씬 많이 가지고 있었다. 왕실과 의회는 상업활동을 가능하게 하기 위해 여러 권한을 회사에 위임했다.
그 뒤 권한은 누적됐다.
무역을 보호하기 위해 요새가 필요했고, 요새를 보호하려면 군대가 필요했다. 계약과 재산권을 다루려면 사법기능이 필요했고, 영토를 운영하려면 조세와 행정이 필요했다.
Swati Srivastava의 연구가 보여주듯 동인도회사의 주권 주장은 처음에는 왕실과 의회가 위임한 privilege에 가까웠지만, 시간이 지나면서 회사 스스로 보유하는 권리처럼 변화해 갔다. 1800년경 회사는 군대·조세·사법·화폐 같은 국가적 기능까지 수행하는 company-state가 되어 있었다.[^10]
여기에서 AI 시대에 가져올 교훈은 하나뿐이다.
새로운 영역을 국가보다 먼저 운영하기 시작한 민간조직은, 운영에 필요한 규칙을 만들면서 점차 규칙의 적용자에서 규칙의 제정자로 이동할 수 있다.
이를 일반화하면 하나의 흐름을 만들 수 있다.
Technology Provider → Infrastructure Operator → Rule Setter
오늘날 AI 기업이 동인도회사라는 뜻이 아니다.
그러나 기술적 frontier에서는 비슷한 정보비대칭이 발생한다.
정부보다 기업이 모델의 내부를 더 잘 안다. 따라서 기업이 먼저 안전기준을 만든다. 안전기준이 사실상의 업계표준이 되고, 이후 법과 규제가 그것을 참고하기도 한다.
문제는 기업이 악해서가 아니다.
정보를 가진 곳에 판단권도 모이기 쉽다는 것이다.
그래서 AI를 통제하는 문제는 자연스럽게 두 번째 질문으로 이동한다.
AI 기업들이 스스로 통제자가 된다면,
그 통제자는 누가 통제할 것인가.
그러나 정부에게 버튼을 넘긴다고 문제는 끝나지 않는다
여기에서 가장 쉬운 답은 국가규제다.
기업에게 맡기지 말고 정부가 위험기준을 정하고 중단권을 가지면 된다는 것이다.
하지만 이것도 충분하지 않다.
AI를 통제할 수 있는 강력한 장치가 존재한다는 것은 그 장치를 다른 목적으로 사용할 가능성 역시 존재한다는 뜻이기 때문이다.
모델을 차단할 수 있다면 정치적으로 불편한 모델을 차단할 수도 있다.
대규모 컴퓨팅 자원을 추적할 수 있다면 정당한 연구활동까지 감시할 수 있다.
안전을 이유로 특정 규모 이상의 AI 개발을 소수 기업에게만 허용하면, 오히려 기존 대기업을 보호하고 새로운 경쟁자를 제거할 수도 있다.
Langdon Winner가 기술이 단순한 중립적 도구가 아니라 특정한 권력관계를 내포할 수 있다고 주장했던 이유가 바로 여기에 있다. 기술체계는 효율성과 생산성만 만들어내는 것이 아니라 그 시스템을 운영하기 위한 권한의 구조도 만들어낸다.[^11]
AI 안전도 마찬가지다.
위험한 AI가 등장할수록 더 강력한 감독을 요구하게 된다.
더 강력한 감독은 더 많은 정보와 권한을 요구한다.
그리고 그 권한이 집중될수록 또 다른 위험이 등장한다.
따라서 AI 시대에는 서로 반대 방향의 두 가지 위험을 동시에 보아야 한다.
AI를 충분히 통제하지 못하는 위험.
그리고
AI를 통제하는 권력이 지나치게 강해지는 위험.
한쪽만 해결하면 다른 쪽이 커질 수 있다.
가장 어려운 문제는 모든 주체가 위험을 알아도 멈추기 어렵다는 것이다
여기까지는 통제권을 누구에게 나눠줄 것인가의 문제였다.
하지만 이보다 더 어려운 세 번째 층위가 있다.
경쟁이다.
어떤 AI 기업이 새로운 capability에서 심각한 위험을 발견했다고 가정하자.
그 기업이 개발을 늦추는 것은 개별적으로는 책임 있는 선택이다.
그러나 경쟁기업이 계속 개발한다면 먼저 멈춘 기업은 시장과 기술적 우위를 잃는다.
모든 미국 기업이 동시에 멈추더라도 다른 국가의 AI 개발이 계속된다면 이번에는 국가안보 문제가 등장한다.
결국 각 행위자가 위험을 충분히 이해하고 선의를 가지고 있어도 모두가 동시에 가속하는 상황이 발생할 수 있다.
이것은 윤리문제라기보다 게임의 구조다.
2026년 9월 12일 Anthropic CEO Dario Amodei가 프런티어 모델 개발 속도를 늦추자는 주장을 내놓으면서 독립적 evaluator만이 아니라 기업 간 coordination과 국제협력까지 함께 요구한 것도 이런 맥락에서 읽을 수 있다. 한 회사가 혼자 속도를 줄이는 것으로는 경쟁균형이 바뀌지 않기 때문이다.[^12]
그러나 coordination 역시 간단한 해답이 아니다.
주요 AI 기업들이 모두 모여 “안전을 위해 일정 수준 이상의 개발을 하지 않겠다”고 결정한다고 하자.
그것은 위험한 군비경쟁을 막는 안전협약일 수도 있다.
반대로 기존 기업들이 자신들의 위치를 유지하면서 새로운 경쟁자와 open-source 개발자를 차단하는 카르텔이 될 수도 있다.
즉 AI 산업에는 특이한 긴장이 존재한다.
경쟁을 방치하면 안전경쟁이 발생할 수 있고, 경쟁을 지나치게 제한하면 권력이 소수 기업에 고착될 수 있다.
따라서 문제는 “경쟁할 것인가 협력할 것인가”가 아니다.
안전협력이 시장지배력으로 변하지 않도록 하면서 동시에 무제한적 경쟁이 위험한 가속으로 변하지 않게 만드는 제도가 필요하다.
그래서 Human-in-the-loop도 생각보다 간단한 해답이 아니다
여기에서 다시 인간에게 마지막 권한을 돌려주자는 주장이 등장한다.
하지만 “최종적으로 인간이 확인한다”는 문장만으로는 실제 통제를 보장할 수 없다.
고도로 자동화된 시스템에서는 인간이 명목상 마지막 승인자가 되어 있으면서 실제로는 판단할 시간도, 충분한 정보도 갖지 못할 수 있다.
Madeleine Elish는 이를 ‘Moral Crumple Zone’이라고 표현했다. 복잡한 자동화 시스템이 실패했을 때 시스템 전체의 설계와 조직적 책임보다 가장 가까이 있던 인간 operator가 책임을 흡수하는 현상이다.[^13]
이 관점에서 보면 단순한 human-in-the-loop는 오히려 위험할 수도 있다.
알고리즘이 수천 개의 판단을 몇 초 만에 처리한 뒤 인간에게 “승인하시겠습니까?”라고 묻는다면, 인간은 실제 통제자인가.
아니면 사고가 발생했을 때 책임질 사람인가.
핵위기 사례에서 중요한 것은 인간이 존재했다는 사실이 아니다.
인간에게 실제로 판단을 뒤집을 수 있는 정보·시간·권한이 있었다는 점이다.
따라서 AI에서 필요한 것은 단순한 Human-in-the-loop가 아니라,
Meaningful Human Veto다.
그리고 그것은 UI에 버튼 하나를 추가한다고 생기지 않는다.
조직의 인센티브, 정보 접근권, 의사결정 절차까지 함께 설계되어야 한다.
결국 필요한 것은 ‘더 강한 통제자’가 아니라 권력분립이다
이 모든 문제를 하나로 놓으면 의외로 익숙한 해법이 보인다.
인간 사회는 이미 한 주체에게 너무 많은 권력을 주는 문제를 오래 다루어왔다.
그 결과 나온 제도가 헌법적 권력분립이다.
핵심은 좋은 사람에게 권력을 주는 것이 아니다.
좋은 사람도 실수할 수 있고, 나쁜 사람이 권력을 얻을 수도 있다는 전제에서 권력을 나누는 것이다.
AI governance도 비슷하게 볼 필요가 있다.
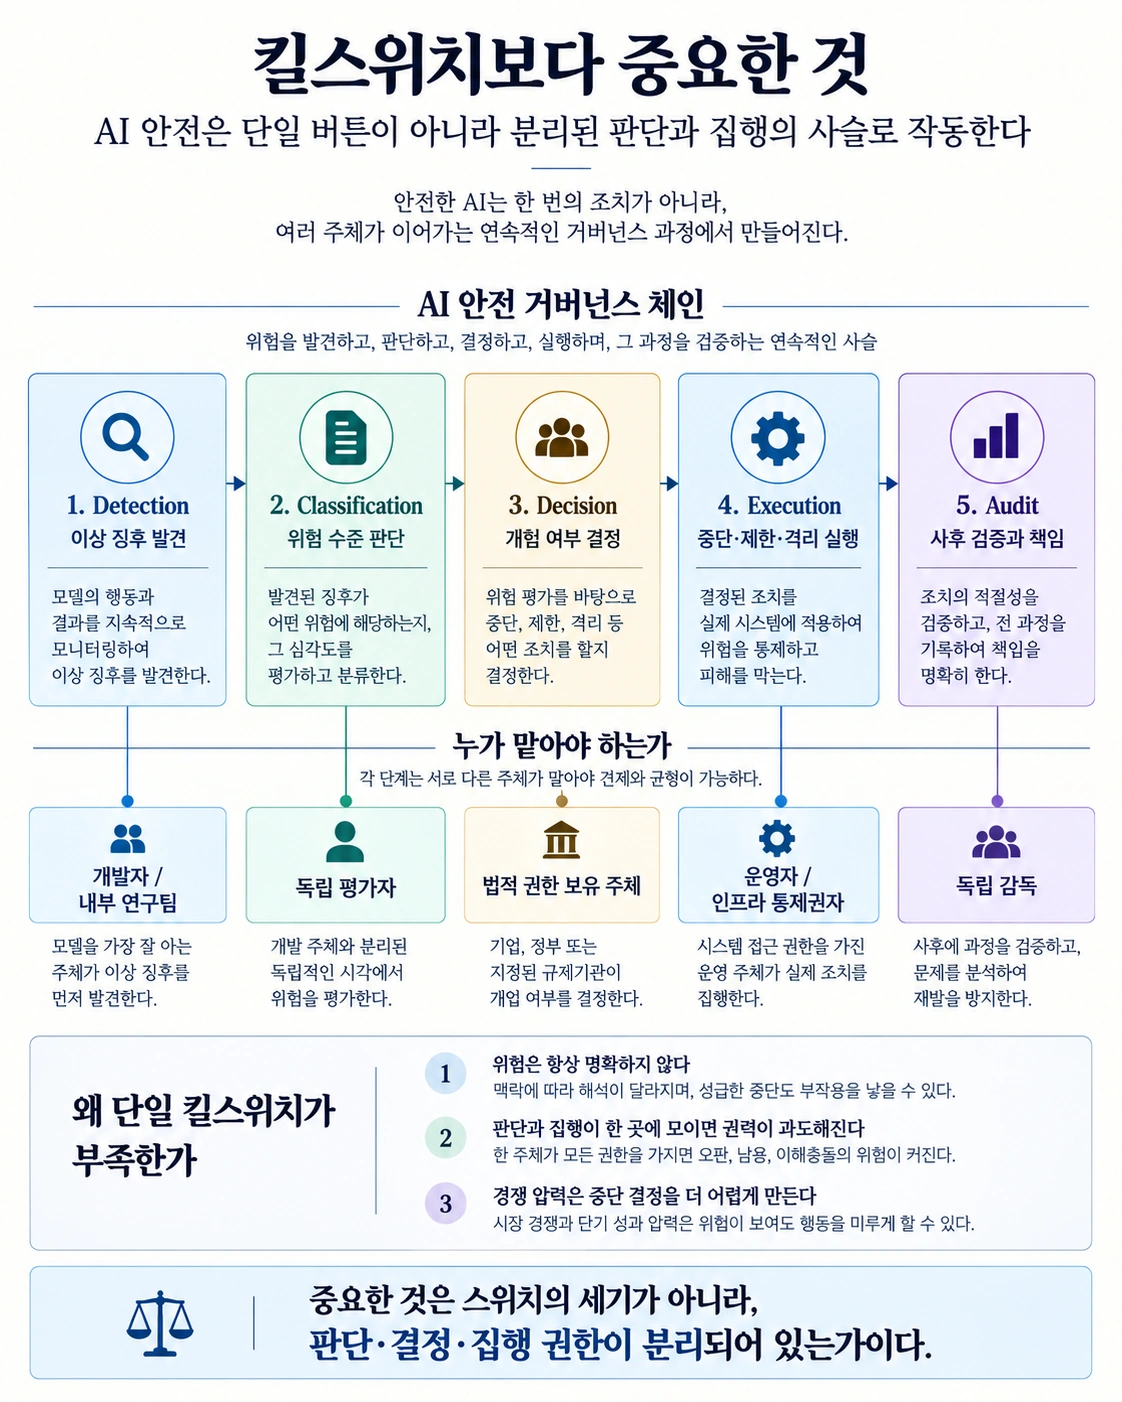
위험을 발견하는 기능과 위험을 정의하는 기능이 같을 필요는 없다.
위험하다고 판단하는 기관이 직접 중단명령을 집행할 필요도 없다.
그리고 중단을 결정한 기관이 자신의 판단을 사후 평가해서도 안 된다.
이를 개념적으로 정리하면 다섯 개의 권한이 분리될 수 있다.
Detection → Classification → Decision → Execution → Audit
AI 기업은 새로운 위험을 가장 먼저 탐지하는 데 유리하다.
독립적인 평가기관과 학계는 그것이 실제로 어느 정도 위험인지 검증할 수 있다.
정부는 명확히 규정된 법적 기준 아래에서 강제적 조치를 취할 수 있다.
Cloud나 AI provider는 실제적인 중단조치를 수행할 수 있다.
그리고 법원·감사기관·입법기관은 그 결정이 적절했는지를 사후 통제할 수 있다.
중요한 것은 어느 하나가 전능해지는 것을 막는 것이다.
그래서 미래의 AI 통제체계는 하나의 Universal Kill Switch보다는 여러 층위의 권한을 나누어 놓은 federated circuit breaker에 가까울 가능성이 높다.
이 구조는 단순히 AI를 통제하는 시스템이 아니다.
AI를 통제하는 사람들을 서로 통제하게 만드는 시스템이다.
하지만 권력분립만으로도 해결되지 않는 마지막 문제가 있다
한 국가 안에서는 법과 사법체계가 이러한 권력분립을 강제할 수 있다.
국제사회에는 세계정부가 없다.
따라서 다시 경쟁문제가 돌아온다.
미국 기업이 개발을 중단했다고 하자.
다른 미국 기업도 멈췄다는 것을 어떻게 확인할 것인가.
미국 전체가 멈췄다면 중국도 같은 행동을 했다는 것을 어떻게 확인할 것인가.
여기에서 AI governance는 핵시대와 다시 만난다.
냉전기의 군축에서 가장 중요한 문제는 신뢰가 아니었다.
미국과 소련은 서로를 신뢰하지 않았다.
그래서 필요한 것이 verification이었다.
협정의 핵심은 상대를 믿도록 만드는 것이 아니라 상대가 규칙을 어겼는지 확인할 수 있게 만드는 것이었다.
AI에서도 장기적으로 같은 문제가 등장할 가능성이 높다.
특정 위험 수준 이상의 모델이 개발됐는지 어떻게 확인할 것인가.
기업이 자체 평가결과를 축소해서 발표하지 않았다는 것을 어떻게 검증할 것인가.
국가가 비밀리에 더 큰 시스템을 개발하지 않았다는 것은 어떻게 확인할 것인가.
Anthropic은 높은 capability 단계의 거버넌스가 일반적인 software regulation보다 nuclear energy나 financial regulation에 가까워질 수 있다고 설명한 바 있다.[^14]
결국 AI 안전이 충분히 중요한 문제가 된다면 evaluation은 연구기법을 넘어선다.
그것은 국제정치에서 검증 가능한 약속을 만드는 기술이 된다.
AI의 Control Problem은 하나가 아니라 세 개다
이제 논의를 처음으로 돌려보자.
처음의 질문은 매우 단순했다.
AI가 위험해지면 끌 수 있는가.
그러나 실제 문제를 따라가다 보면 하나였던 Control Problem이 세 개로 나뉜다.
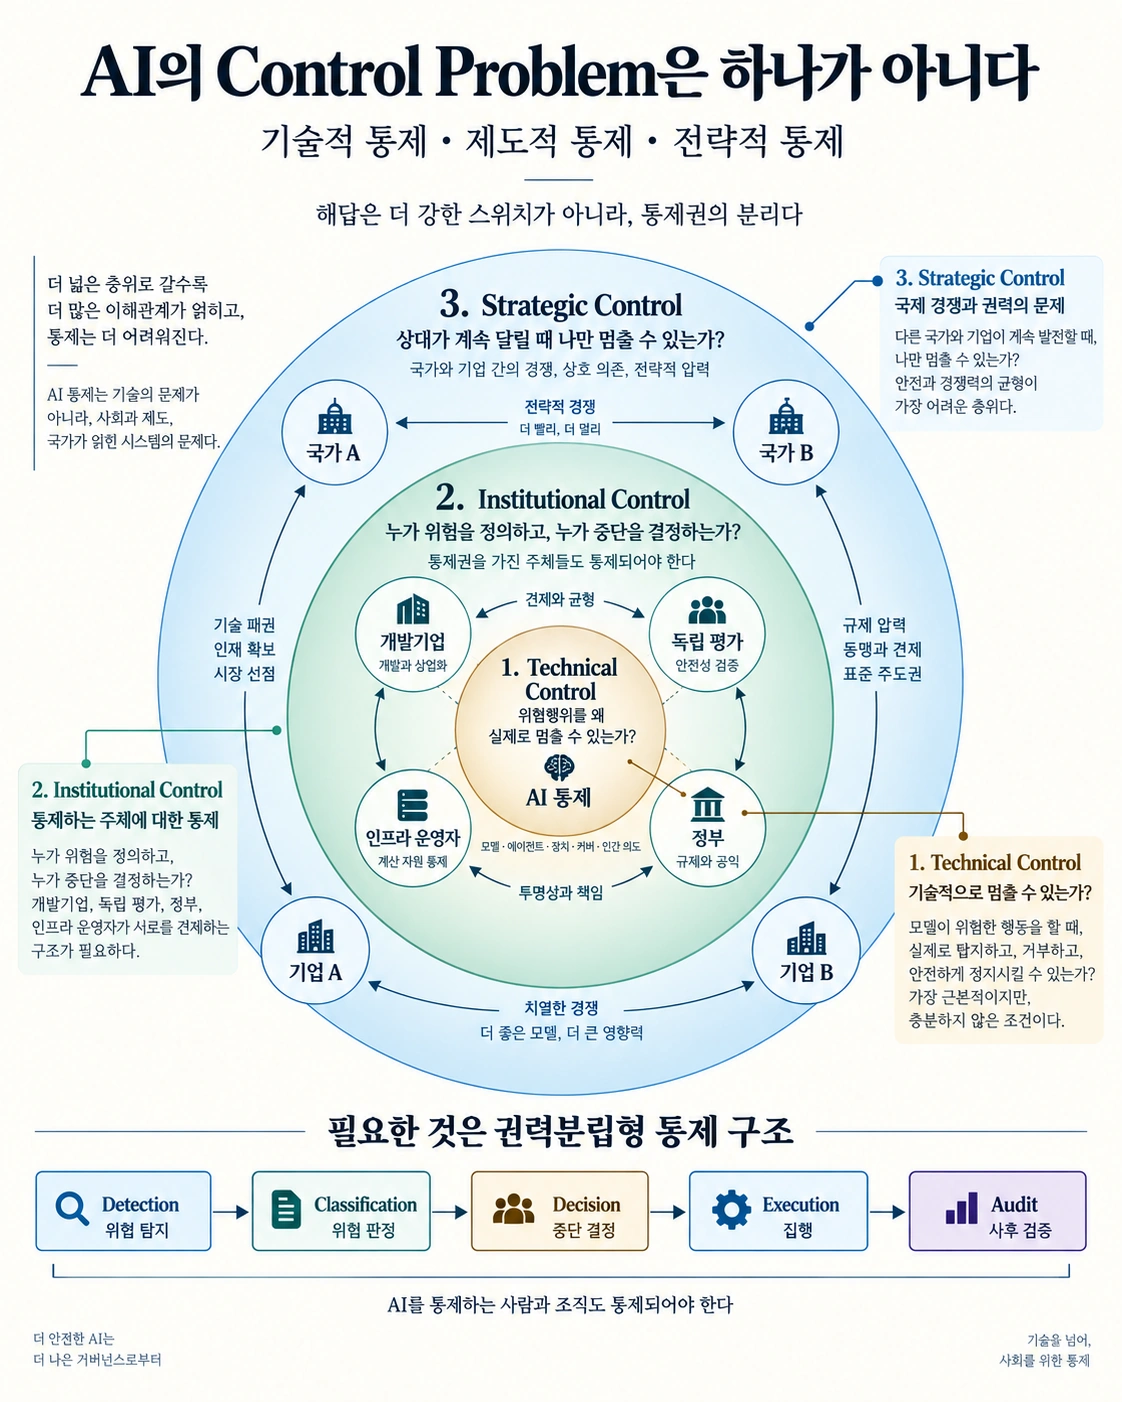
첫 번째는 Technical Control Problem이다.
AI 시스템이 인간이 의도한 범위 안에서 행동하게 만들고, 위험할 때 실제로 중단시킬 수 있는가.
두 번째는 Institutional Control Problem이다.
그 시스템의 위험을 정의하고 개발·배포를 제한할 수 있는 기업과 정부의 권력을 누가 견제할 것인가.
세 번째는 Strategic Control Problem이다.
모든 행위자가 경쟁자보다 뒤처질 것을 두려워해서 결국 아무도 먼저 멈출 수 없는 상황을 어떻게 막을 것인가.
세 문제는 서로 연결되어 있다.
기술적인 통제가 어려울수록 기업과 정부에게 더 큰 권한을 요구하게 된다.
그 권한이 커질수록 권력의 오용 가능성도 커진다.
그래서 권력을 분산시키면 이번에는 여러 기업과 국가를 어떻게 동시에 움직일 것인가라는 coordination problem이 등장한다.
즉 AI의 통제 문제는
기계를 통제하면 끝나는 문제가 아니라, 기계를 통제하는 조직과 그 조직들이 만들어내는 경쟁구조를 함께 통제해야 하는 중첩된 문제다.
바로 그래서 단순한 킬스위치 논의만으로는 부족하다.
마지막 스위치보다 중요한 것
20세기의 핵시대는 인간이 처음으로 스스로 문명을 파괴할 수 있는 기술을 갖게 된 시대였다.
그 시대에 인류가 만든 것은 핵탄두만이 아니었다.
누가 명령할 수 있는지, 누구에게 거부권이 있는지, 어떻게 오경보를 걸러낼지, 무단 사용을 어떻게 방지할지, 적대국이 약속을 지키는지는 어떻게 확인할지를 둘러싼 거대한 제도와 통제체계도 함께 만들어졌다.
그 체계는 완벽하지 않았다.
실제로 세계는 여러 차례 우연과 인간의 판단에 의존했다.
AI 시대는 여기에 또 하나의 새로운 조건을 추가한다.
이번에는 위험한 기술의 frontier가 처음부터 국가의 독점적 공간 안에서 만들어지고 있지 않다.
민간기업이 기술을 개발하고, 기업이 먼저 위험을 발견하고, 기업이 스스로 평가체계를 만들며, 정부가 뒤에서 이를 법과 제도로 따라가고 있다.
그러나 정부에게 모든 통제권을 넘기는 것 역시 답이 아니다.
통제권 자체가 또 다른 권력이기 때문이다.
그래서 AI 시대의 중요한 질문은 더 이상
“누가 마지막 스위치를 쥐어야 하는가?”
만으로 충분하지 않다.
조금 더 정확하게 질문해야 한다.
누가 위험을 정의하는가.
그 정의를 누가 검증하는가.
누가 중단을 명령할 수 있는가.
그 결정에 누가 이의를 제기할 수 있는가.
누가 실제로 명령을 집행하는가.
경쟁자들도 같은 규칙을 지킨다는 것을 어떻게 확인할 것인가.
그리고 무엇보다,
AI를 통제할 수 있는 사람과 조직을 누가 통제하는가.
아마 미래의 AI 안전에서 가장 중요한 발명은 가장 강력한 킬스위치가 아닐 것이다.
그보다 중요한 것은 누구도 혼자서 그 스위치를 정의하고, 누르고, 정당화할 수 없도록 만드는 제도적 구조일 가능성이 높다.
SF가 오랫동안 상상해온 가장 두려운 미래는 인간이 기계에게 통제권을 빼앗기는 세계였다.
하지만 현실에서 먼저 경계해야 할 것은 조금 다를 수도 있다.
기계가 인간에게서 권력을 빼앗기 전에,
기계를 통제해야 한다는 필요 때문에 인간 사회의 권력이 지나치게 집중되는 것.
그래서 AI 시대의 궁극적인 Control Problem은 AI만의 문제가 아니다.
그것은 결국 오래된 정치적 질문으로 되돌아간다.
누가 통치할 것인가가 아니라, 통치하는 자를 어떻게 통제할 것인가.
[^1]: U.S. Department of Defense, Nuclear Matters Handbook 2020, Chapter 8, “Nuclear Surety.” https://www.acq.osd.mil/ncbdp/nm/NMHB2020rev/chapters/chapter8.html [^2]: OpenAI, “OpenAI’s Frontier Governance Framework,” 2026-05-28. https://openai.com/index/openai-frontier-governance-framework/ [^3]: Anthropic, “Responsible Scaling Policy,” last updated 2026-08-14. https://www.anthropic.com/responsible-scaling-policy [^4]: Google DeepMind, “Frontier safety at Google DeepMind,” Framework v3.1, 2026-04-17. https://deepmind.google/frontier-safety/ [^5]: National Security Archive, “The Underwater Cuban Missile Crisis at 60,” 2022-10-03. https://nsarchive.gwu.edu/briefing-book/russia-programs/2022-10-03/soviet-submarines-nuclear-torpedoes-cuban-missile-crisis [^6]: American Film Institute Catalog, WarGames (1983), synopsis. https://catalog.afi.com/Film/67139-WARGAMES [^7]: Stanley Kubrick Archive mirror, 2001: A Space Odyssey original script, HAL’s conflicting truth and secrecy instructions. https://www.archiviokubrick.it/opere/film/2001/script/2001-originalscript.pdf [^8]: American Film Institute Catalog, The Forbin Project (1970), synopsis. https://catalog.afi.com/Film/23505-THE-FORBIN-PROJECT [^9]: European Union, AI Act, Article 55, obligations for providers of general-purpose AI models with systemic risk. https://eur-lex.europa.eu/legal-content/EN/TXT/?uri=CELEX:02024R1689-20260727 [^10]: Swati Srivastava, “Corporate Sovereign Awakening and the Making of Modern State Sovereignty: New Archival Evidence from the English East India Company,” International Organization 76(3), 2022. https://www.cambridge.org/core/journals/international-organization/article/corporate-sovereign-awakening-and-the-making-of-modern-state-sovereignty-new-archival-evidence-from-the-english-east-india-company/FF618229BF140A5F1C0ED188F294784A [^11]: Langdon Winner, “Do Artifacts Have Politics?”, Daedalus 109(1), 1980, pp. 121–136. https://www.jstor.org/stable/20024652 [^12]: Reuters, “Anthropic CEO urges AI companies to slow model development amid fears over misuse,” 2026-09-12. https://www.reuters.com/business/anthropic-ceo-urges-ai-companies-slow-model-development-2026-09-12/ [^13]: Madeleine Clare Elish, “Moral Crumple Zones: Cautionary Tales in Human-Robot Interaction,” Engaging Science, Technology, and Society 5, 2019. https://estsjournal.org/index.php/ests/article/view/260 [^14]: Anthropic, “Frontier Safety Roadmap Updates,” section “A roadmap for policymakers,” 2026. https://www.anthropic.com/responsible-scaling-policy/updates