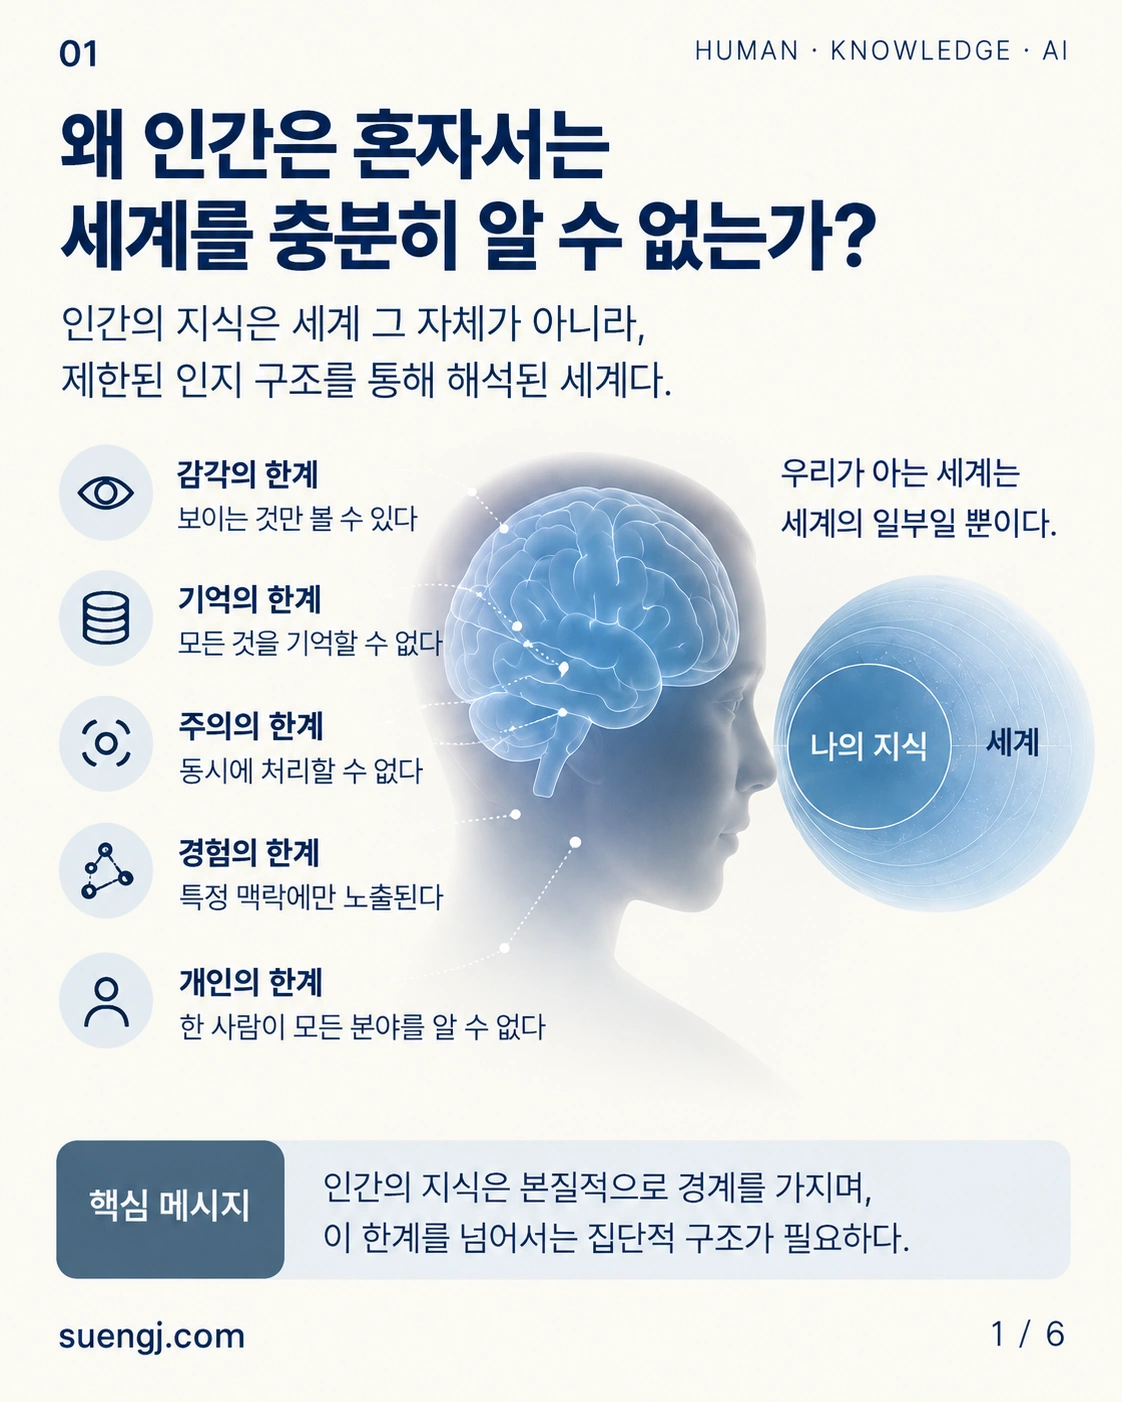
한 사람이 세계에 대해 알 수 있는 범위는 매우 좁다. 감각도 제한되어 있고, 기억과 주의력에도 한계가 있다. 한 분야를 평생 연구하더라도 그 분야에서 생산되는 지식 전체를 따라가기 어렵다. 그런데 인류의 지식은 이 개인적 한계보다 훨씬 넓다.
이 차이는 오래전부터 사회적으로 해결되어 왔다. 사람은 자신이 직접 확인하지 않은 사실을 다른 사람에게서 배우고, 그것을 문자와 논문에 남기며, 대학과 학회와 전문직을 통해 검증하는 방식을 만들었다. 개인의 머릿속에 들어 있지 않은 지식이 공동체 안에서는 지속된다. 물리학자는 모든 실험을 직접 반복하지 않고도 물리학을 할 수 있고, 사회학자는 사회학 전체의 논문을 읽지 않고도 자신이 어느 논쟁 위에 서 있는지 안다.
이렇게 보면 인간의 지식은 처음부터 개인의 소유물이라기보다 여러 사람이 특정한 언어와 기준을 공유하면서 유지하는 집단적 구조에 가까웠다.
여기에 AI가 들어왔다. 오늘날의 거대언어모델은 한 사람이 읽을 수 없는 규모의 문헌과 기록을 학습하고, 서로 멀리 떨어진 분야의 개념을 짧은 시간 안에 연결한다. 그래서 직관적으로는 이런 질문을 하게 된다.
인간이 만든 거의 모든 지식을 학습한 AI가 있다면, 그것은 기존 인간의 지식계를 넘어선 새로운 관찰자가 될 수 있을까.
이 질문은 AI가 얼마나 똑똑한지를 묻는 것과 조금 다르다. 더 근본적으로는 새로운 지식이 어디에서 생기는가를 묻는다.
지식은 개인의 머릿속보다 먼저 ‘계’를 만든다
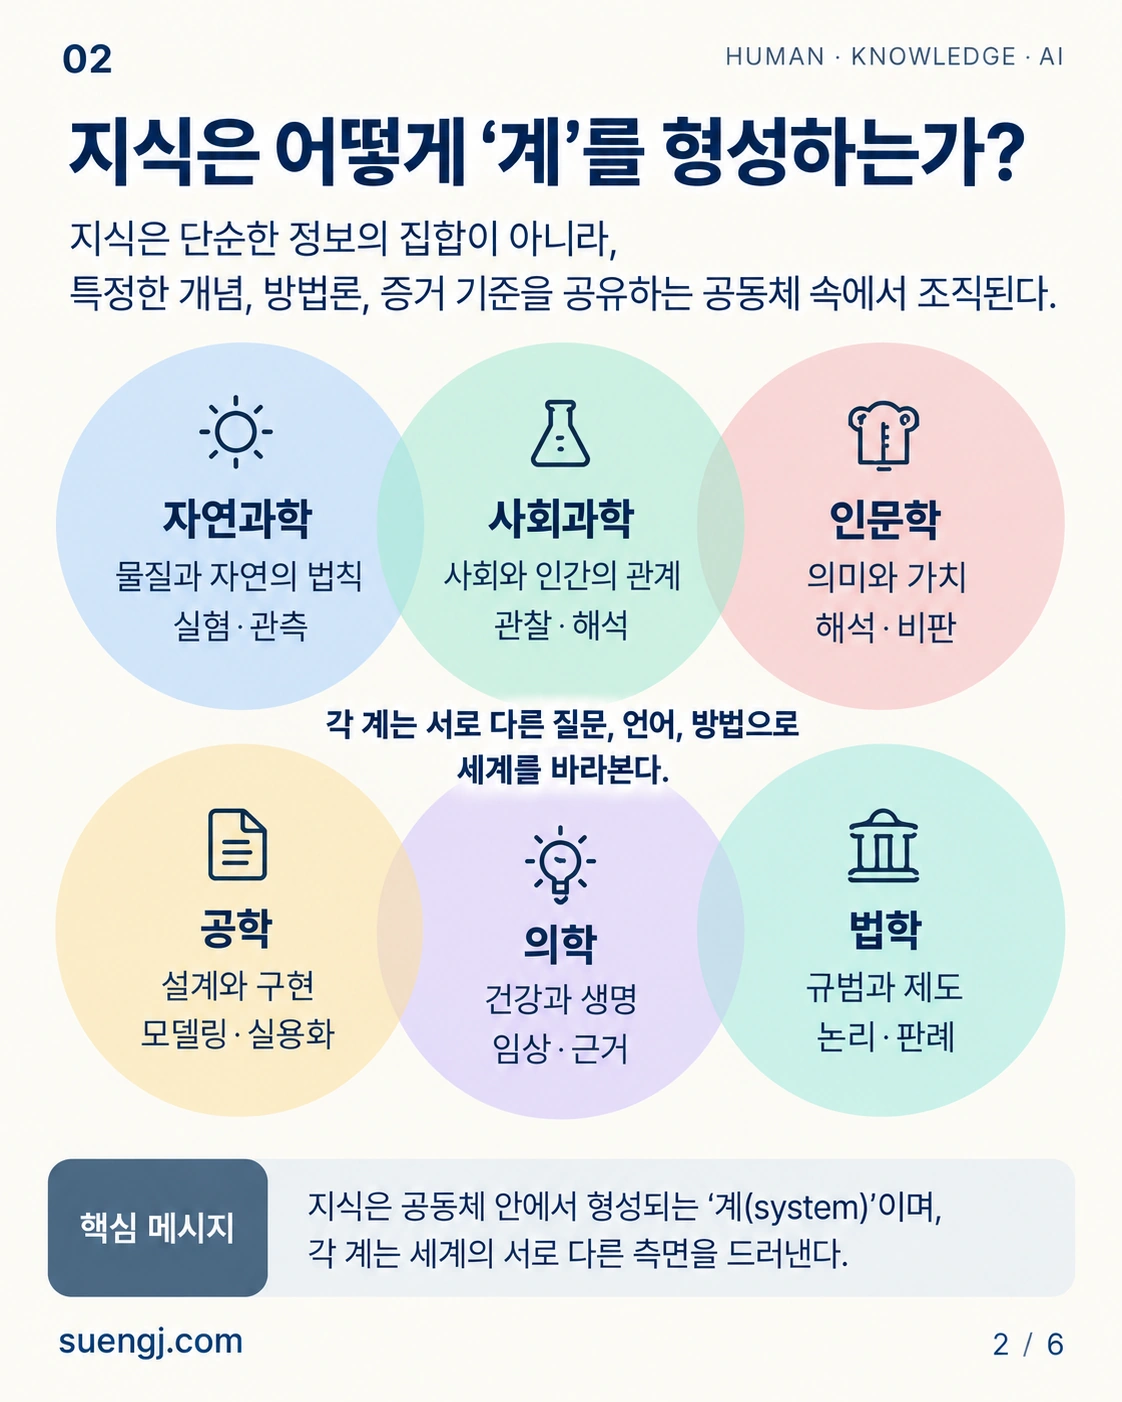
Ludwik Fleck는 1930년대에 과학적 인지를 개인의 고립된 활동으로 보기 어렵다고 주장했다. 사람들은 아이디어를 주고받는 과정에서 thought collective을 만들고, 그 안에서 무엇을 문제로 보고 어떤 설명을 자연스럽게 받아들일지를 규정하는 thought style을 발전시킨다.[^1]
이 생각은 지금 읽어도 꽤 현대적이다. 연구자는 아무 전제도 없는 상태에서 현실을 바라보지 않는다. 어떤 변수에 주목해야 하는지, 무엇을 좋은 증거로 볼지, 어떤 질문이 연구할 가치가 있는지부터 이미 자신이 속한 지식 공동체에서 배운다.
Thomas Kuhn이 이후 disciplinary matrix라고 부른 것도 비슷한 층위를 가리킨다. 하나의 학문은 몇 개의 이론만 공유하는 집단이 아니다. 문제를 푸는 방식, 모범적인 사례, 방법론적 가치, 당연하게 받아들이는 기본 명제까지 묶여 있다.[^2]
이 글에서는 이런 구조를 편의상 지식계라고 부르려 한다. 여기서 ‘계’는 Luhmann의 사회체계 개념을 그대로 가져온 엄밀한 용어라기보다, 특정한 개념·방법·증거 기준·전문언어를 공유하며 지식을 생산하는 공동체를 가리키는 분석적 표현이다.
경제학, 사회학, 심리학이 같은 사회현상을 서로 다르게 읽는 이유도 여기에서 찾을 수 있다.
한 직원이 회사를 떠났다고 해보자. 노동경제학에서는 임금과 외부 노동시장, 기회비용이 먼저 보일 수 있다. 조직심리학에서는 동기, 직무만족, burnout이 연구대상이 된다. 사회학에서는 네트워크, 지위, 조직구조와 제도적 맥락이 들어온다.
사건은 하나지만 연구대상은 같지 않다. 각 지식계가 현실을 잘라내는 방식이 다르기 때문이다.
이를 단순화하면 다음과 같다.
같은 현실
   ↓
서로 다른 개념과 증거 기준
   ↓
서로 다른 관찰
   ↓
서로 다른 설명
여기에는 중요한 양면성이 있다. 지식계가 생기면 개인보다 훨씬 많은 것을 알 수 있다. 전문용어를 만들고, 측정법을 발전시키고, 여러 세대의 연구를 누적할 수 있기 때문이다. 동시에 그 계가 무엇을 볼 수 있는지의 경계도 생긴다.
전문성이 깊어질수록 더 많은 것이 보이지만, 바로 그 전문성 때문에 다른 방식으로 볼 가능성이 줄어들 수도 있다.
지식계 내부의 소통은 지식을 넓히지만, 경계를 없애지는 않는다
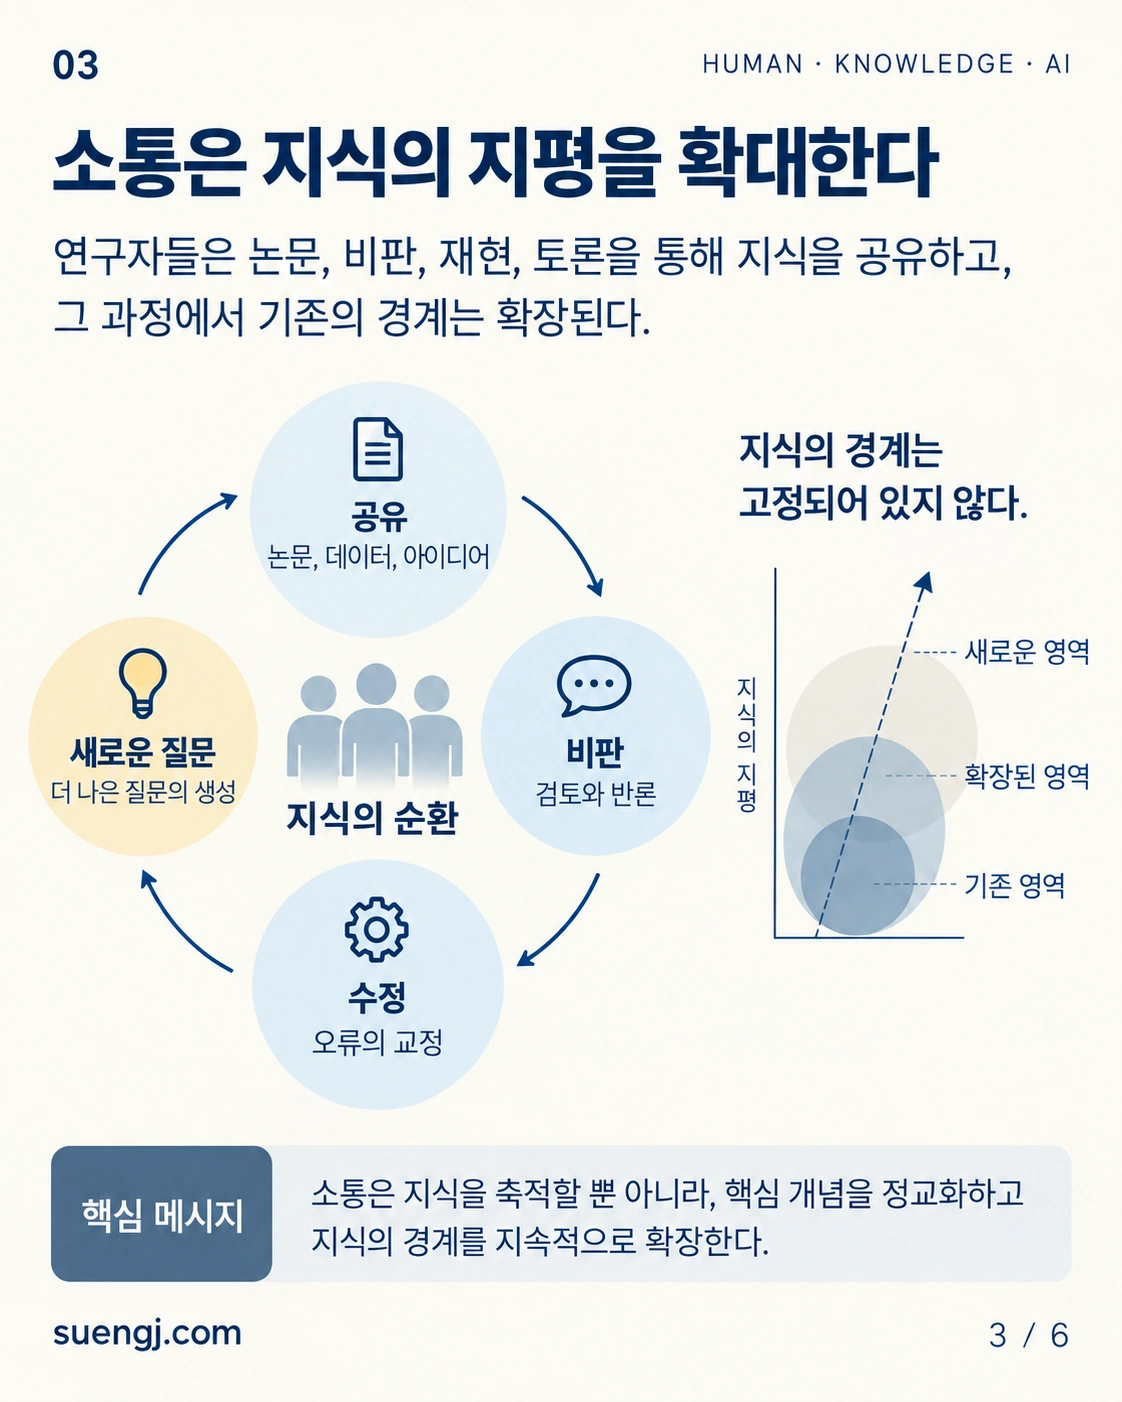
개인의 인지 한계를 넘어서기 위해 인간은 communication을 사용해왔다. 연구자는 자신이 발견한 것을 논문으로 공개하고, 다른 연구자가 비판하고, 재현하고, 수정한다. 한 사람의 오류가 공동체 안에서 수정될 가능성이 생긴다.
Helen Longino는 과학적 객관성을 개인 연구자의 무편견에서 찾기보다 비판이 실제로 작동하는 사회적 과정에서 찾았다. 데이터가 특정 이론을 지지한다는 판단에는 언제나 배경 가정이 들어가며, 한 연구자가 자신의 모든 배경 가정을 스스로 발견하기는 어렵다. 서로 다른 입장을 가진 사람들이 증거와 방법, 전제를 공개적으로 비판하고 그 비판이 실제 연구에 반영될 때 과학적 지식이 더 객관적일 수 있다는 주장이다.[^3]
이 시각에서는 communication이 이미 완성된 지식을 전달하는 파이프가 아니다. 지식을 만드는 과정의 일부다.
개인의 관찰 → 공동체의 비판 → 수정된 설명
다만 같은 지식계 안의 communication은 대개 공유된 언어와 기준을 전제로 한다. 물리학자끼리 논쟁하더라도 무엇이 실험이고 무엇이 오차인지에 대해 상당한 공통 기반이 있다. 이 공통 기반 덕분에 깊은 논의가 가능하지만, 동시에 공동체 전체가 공유하는 전제는 비판에서 빠져나가기 쉽다.
Fleck가 thought style이라고 부른 것의 힘도 여기에 있다. 한 공동체에서 너무 자연스러워진 전제는 더 이상 ‘전제’처럼 보이지 않는다.[^1]
새로운 지식이 반드시 계 내부에서만 생기지 않는 이유다.
서로 다른 계가 만날 때는 ‘답’보다 질문이 바뀐다
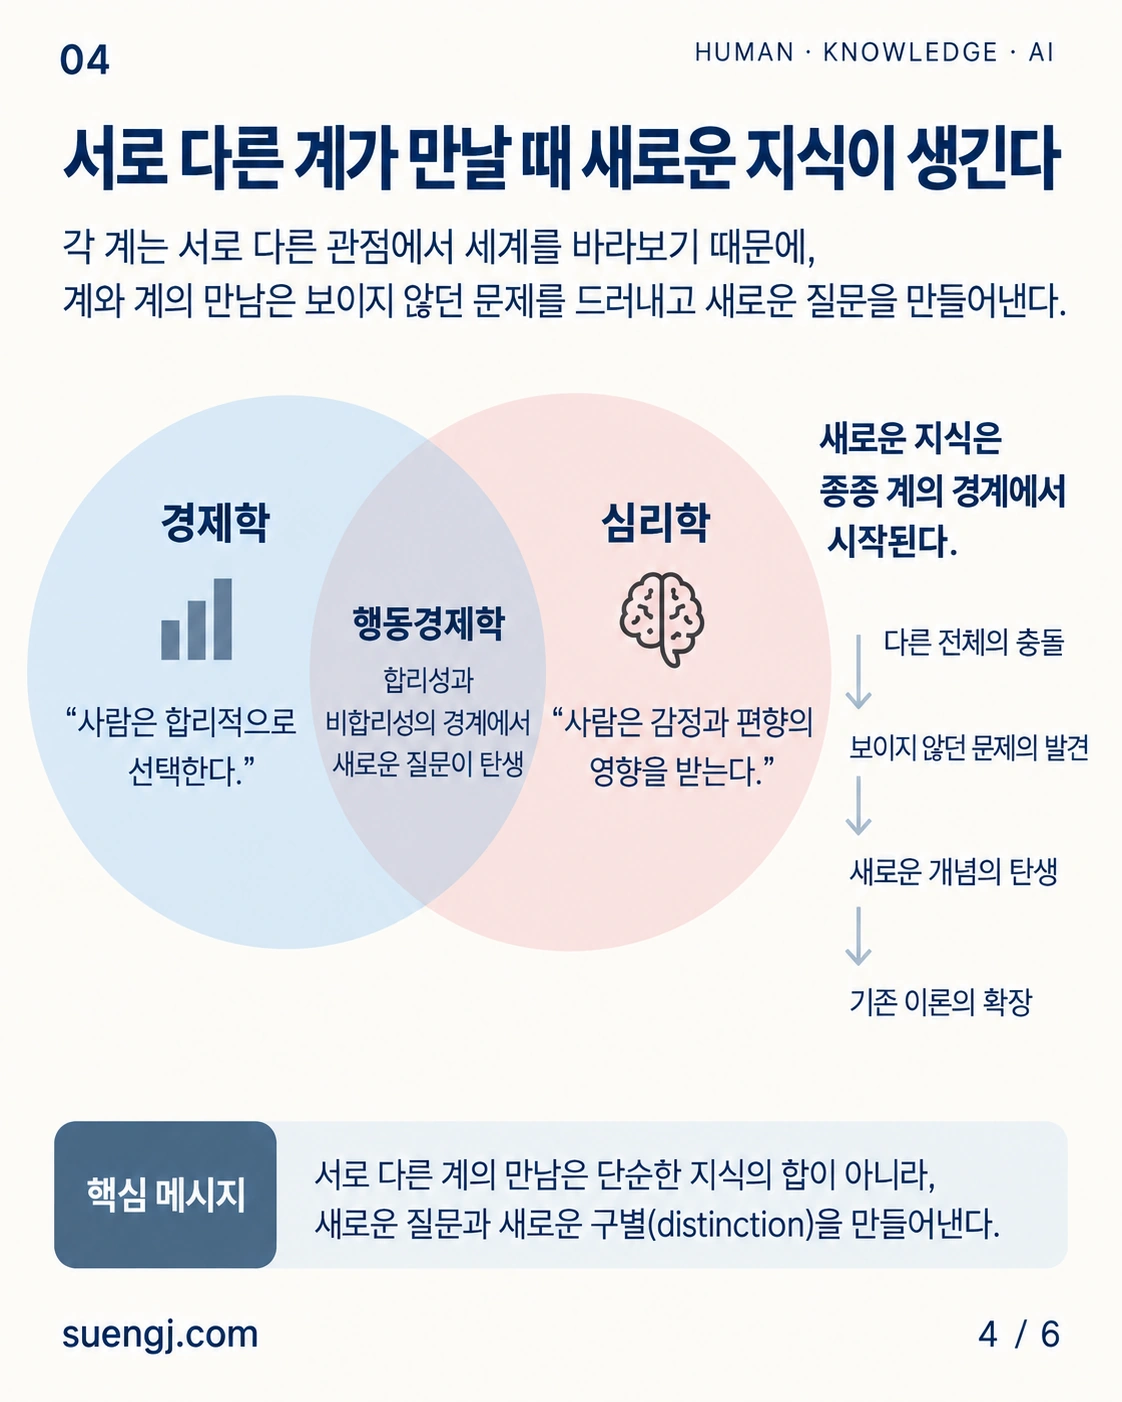
서로 다른 지식계가 같은 현상을 만났을 때 가장 흥미로운 것은 어느 한쪽이 다른 쪽보다 더 정확하다는 사실이 아니다. 한쪽에서는 당연해서 질문조차 하지 않았던 것이 다른 쪽에서는 설명해야 할 문제가 될 수 있다는 점이다.
과학기술학에서 Susan Leigh Star와 James Griesemer가 제시한 boundary object는 이 문제를 잘 보여준다. 서로 다른 사회적 세계에 속한 사람들이 동일한 목표를 위해 협력하려면 모든 개념을 완전히 같은 의미로 사용할 필요는 없다. Berkeley의 Museum of Vertebrate Zoology 사례에서 전문 연구자, 아마추어 수집가, 행정가들은 서로 다른 관심과 관점을 유지하면서도 표본, 지도, 표준화된 양식 같은 객체를 매개로 협력할 수 있었다.[^4]
중요한 것은 서로 다른 계가 만나면 곧바로 하나로 합쳐진다는 점이 아니다. 오히려 차이를 유지한 채 부분적으로 번역할 수 있었기 때문에 새로운 공동 작업이 가능했다.
사회과학의 역사를 보더라도 의미 있는 연구문제는 종종 이런 경계에서 나온다. 경제행위를 오직 개인의 효용 극대화로 설명하던 곳에 사회적 네트워크를 넣거나, 조직의 성과를 내부 관리 문제로만 보던 곳에 제도적 환경을 넣으면 기존의 질문 자체가 달라진다.
관계사회학이 ‘개체가 어떤 속성을 가지고 있는가’보다 ‘그 속성이 어떤 관계 안에서 성립하는가’를 묻도록 방향을 돌린 것도 같은 종류의 변화다. Mustafa Emirbayer는 사회를 고정된 실체들의 집합보다 과정과 관계의 관점에서 보자는 문제를 명시적으로 제기했다.[^5]
새로운 지식은 여기서 기존 데이터에 문장 하나를 더 얹는 형태로만 생기지 않는다.
때로는 이전에는 분리하지 않았던 것을 새로 구분하고, 별개라고 생각했던 것을 하나의 관계로 묶는 데서 생긴다.
기존의 계 A: 질문 Q₁ → 답 A₁
기존의 계 B: 질문 Q₂ → 답 A₂

A와 B의 충돌 또는 번역
            ↓
      이전에 없던 질문 Q₃
이때 Q_3가 중요하다. 새로운 지식의 초기 형태는 새로운 답이 아니라 **새로운 질문 또는 새로운 구별(distinction)**일 수 있다.
물론 서로 다른 계를 붙인다고 지식이 자동으로 늘어나는 것은 아니다. 말만 다르고 실제 내용은 같을 수도 있고, 서로의 전제를 이해하지 못한 채 병렬적으로 주장만 반복할 수도 있다. 차이가 지식이 되려면 그 차이가 무엇에서 비롯되었는지 설명할 수 있어야 하고, 기존의 관찰을 다시 보게 만들 정도의 내용이 있어야 한다.
이 조건을 붙이고 나면 AI 문제가 조금 더 선명해진다.
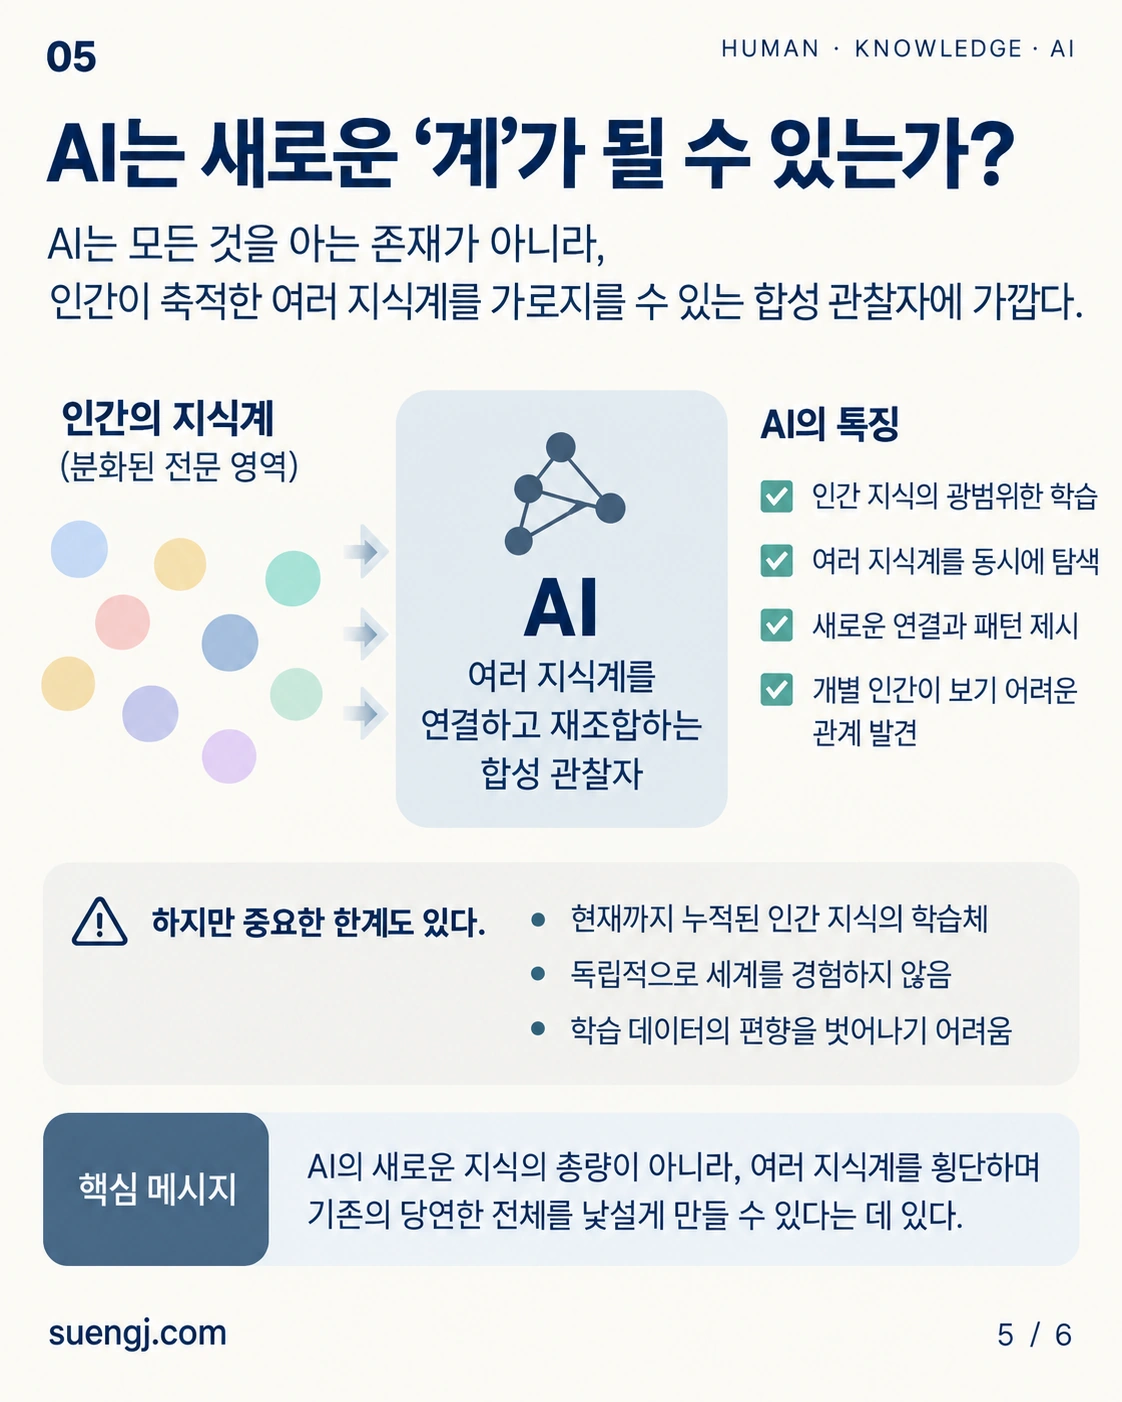
AI는 ‘모든 것을 아는 계’라기보다 인간 지식을 압축한 합성 관찰자에 가깝다
거대언어모델을 두고 “인류의 지식을 모두 학습했다”는 표현을 쓰기 쉽지만 엄밀한 표현은 아니다. 학습 데이터는 인간이 기록한 세계의 일부이고, 그 안에서도 접근 가능한 자료와 학습 과정에 포함된 자료만 모델에 들어간다. 모델은 세계를 직접 완전히 관측하지 않는다.
그렇다고 AI를 거대한 검색엔진으로만 보는 것도 부족하다.
2024년 Nature Human Behaviour에 발표된 BrainBench 연구는 이 중간 지점을 잘 보여준다. 연구진은 LLM에게 최근 신경과학 논문의 방법과 맥락을 주고 실제 실험 결과와 그 결과를 바꾼 가짜 버전 가운데 어느 쪽이 진짜인지 예측하게 했다. 평가에 사용된 200개 사례에서 연구에 포함된 LLM들의 평균 정확도는 81.4%, 인간 전문가 집단은 63.4%였다. 연구진은 학습 데이터 암기만으로 결과를 설명하기 어렵다는 추가 검사를 수행했고, 모델이 논문의 방법과 맥락을 통합해 아직 주어지지 않은 결과를 예측하고 있다고 해석했다.[^6]
이 결과는 “AI가 이미 모르는 사실을 알고 있다”는 뜻은 아니다. 더 정확히는 이미 축적된 지식에서 인간 개인이 놓치기 쉬운 패턴을 통합해 아직 관찰되지 않은 결과에 대한 더 좋은 기대를 만들 수 있다는 뜻에 가깝다.
그래서 나는 현재의 AI를 완전히 독립적인 지식계보다 synthetic observer, 합성 관찰자라고 부르는 편이 더 적절하다고 본다.
AI의 내부에는 경제학자 한 사람, 사회학자 한 사람, 생물학자 한 사람이 각각 들어 있는 것이 아니다. 서로 다른 학문과 시대, 문체와 관점을 한 학습과정 안에서 압축한 표현구조가 있다. 개별 인간에게는 멀리 떨어져 있는 지식계 사이를 빠르게 오갈 수 있다는 점에서 기존의 전문가와 다르다.
그러나 그 재료의 상당 부분은 인간이 만든 것이다. AI는 외계에서 온 관찰자가 아니다.
이 애매한 위치가 오히려 중요하다.
전문화된 AI 여러 개를 만들면 서로 다른 지식계가 생길까
여기에서 한 가지 사고실험을 해볼 수 있다.
하나의 AI를 경제학에 특화하고, 다른 AI를 사회학에 특화하고, 또 다른 AI를 심리학에 특화한다고 하자. 각 모델이 동일한 현상을 독립적으로 분석한 뒤 서로 토론하게 하면 인간 학문의 경계에서 일어났던 것과 비슷한 새로운 지식이 생길까.
가능성은 있다. 다만 역할을 나눴다는 사실만으로 서로 다른 지식계가 만들어졌다고 보기는 어렵다.
Kuhn의 disciplinary matrix나 Fleck의 thought collective가 강한 개념인 이유는 한 학문이 이름만 다른 역할이 아니기 때문이다. 오랜 교육과 훈련, 공유된 문제, 방법론, 증거 기준, 실패를 판정하는 방식, 전문기관과 peer review까지 함께 존재한다.[^1][^2]
같은 foundation model에 “너는 경제학자”, “너는 사회학자”라는 prompt를 각각 붙인 두 agent는 표면적으로 다른 말을 할 수 있다. 그러나 동일한 training distribution과 표현구조, 비슷한 추론 관행을 공유한다면 그 차이가 인간의 학문계 사이만큼 깊다고 가정할 수 없다.
반대로 각 AI가 서로 다른 데이터, 방법론, 도구, 기억, 평가기준을 지속적으로 사용하고 그 결과에 따라 자신의 후속 판단을 다르게 갱신한다면 이야기가 달라진다. 그때는 단순한 role play보다 지식계에 가까운 분화가 일어날 수 있다.
즉 AI–AI communication이 새로운 지식의 원천이 될 수 있는지는 agent의 수보다 그들이 실제로 서로 다른 인식 조건을 가지고 있는가에 달려 있다.
여기에는 더 근본적인 한계도 있다.
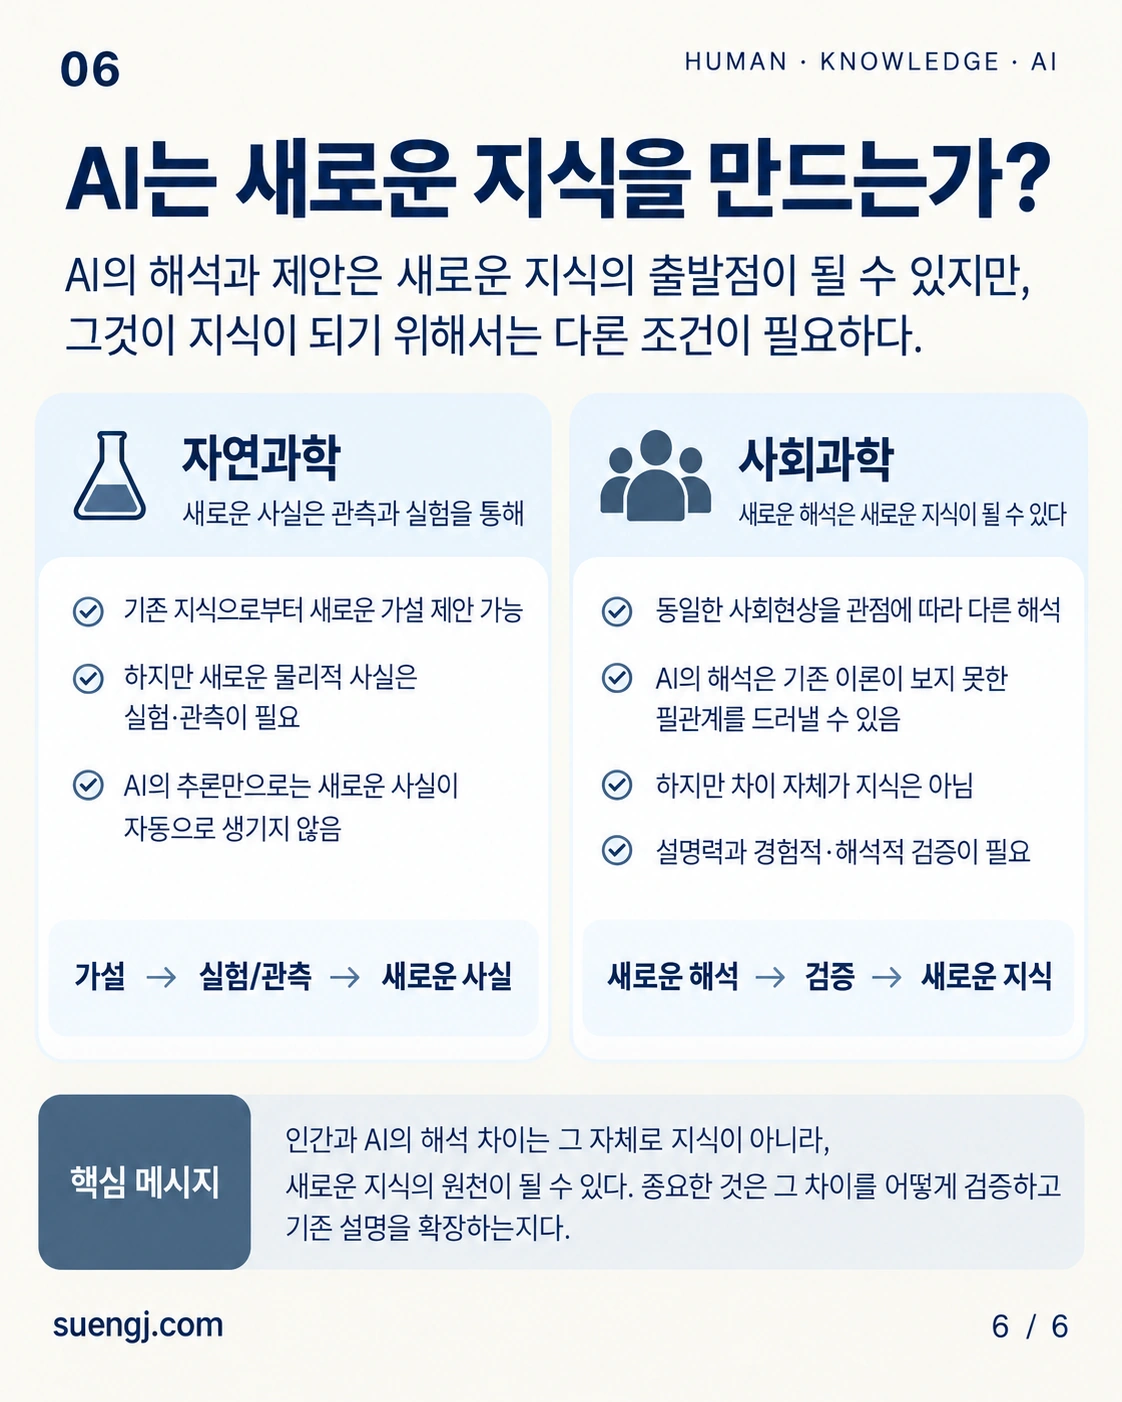
자연과학에서 대화는 가설을 늘릴 수 있지만, 세계가 새로운 사실을 만들어준다
두 AI가 밤새 토론한다고 해서 새로운 입자가 존재하게 되는 것은 아니다.
이미 알려진 이론과 논문을 바탕으로 “이 조건에서는 이런 현상이 나타날 것”이라는 새로운 가설을 만들 수는 있다. 실제로 LLM이 과거 문헌의 패턴을 이용해 아직 공개되지 않은 신경과학 실험결과를 예측할 수 있다는 BrainBench 결과는 이런 능력이 단순한 공상이 아님을 보여준다.[^6]
2025년 Journal of the Royal Society Interface에 실린 연구는 한 단계 더 갔다. 연구진은 GPT-4가 제안한 비암성 의약품 조합을 유방암 세포주에서 실제로 실험했다. 첫 번째 실험에서 12개 조합 가운데 3개가 positive control보다 높은 synergy score를 보였고, 그 결과를 다시 모델에 알려 생성한 추가 4개 조합 가운데 3개에서도 양의 시너지가 나타났다.[^7]
이 사례에서 새로운 지식이 생긴 지점을 구분할 필요가 있다.
AI가 제안한 약물 조합은 가설이었다. 실제 세포에서 그 조합이 어떤 효과를 냈다는 것은 실험 결과다. AI가 문헌을 새로운 방식으로 연결할 수 있었지만, 그 연결이 자연에 대한 사실이 되기 위해서는 결국 자연에 다시 물어야 했다.
누적된 지식
→ AI의 새로운 연결
→ 가설
→ 실험
→ 관측
→ 지식의 수정
따라서 자연과학에서 AI의 대화와 추론은 지식의 탐색공간을 크게 넓힐 수 있지만, 외부 관측이 끊긴 채 모델들끼리 합의한 문장을 새로운 empirical fact라고 부를 수는 없다.
AI가 더 강해져도 이 구분은 중요할 가능성이 높다. 실험을 AI가 설계하고 로봇이 수행하더라도 세계와 다시 접촉하는 단계 자체가 사라지는 것은 아니다.
사회과학에서는 ‘새로운 사실’과 ‘새로운 해석’의 경계가 더 복잡하다
사회과학에 오면 문제가 어려워진다.
실업률이나 인구수처럼 비교적 명확하게 측정되는 사실도 있지만, 사회과학의 핵심 개념 상당수는 관찰 이전부터 자연에 완성된 변수의 형태로 놓여 있지 않다. 권력, 신뢰, 정당성, 조직문화, 계층, 사회자본 같은 개념은 현실에서 무언가를 포착하지만, 무엇을 하나의 현상으로 묶고 어떤 관계를 중요하게 볼지에 대한 이론적 선택도 포함한다.
Longino가 강조한 것처럼 데이터와 이론의 관계에는 배경 가정이 개입한다. 같은 관찰 결과도 어떤 설명 틀을 택하느냐에 따라 다른 의미를 가질 수 있다.[^3]
그렇다면 사회과학에서는 새로운 해석 자체가 지식의 확장이 될 수 있을까.
나는 조건부로 그렇다고 본다.
예를 들어 어떤 조직의 높은 이직률을 임금 격차로만 설명해오다가, 팀 내부 네트워크의 구조가 이직의 확산을 매개한다는 관점을 새로 도입했다고 하자. 여기에서 “네트워크로도 볼 수 있다”는 문장만으로는 지식이 아니다. 하지만 그 해석이 이전 모델이 설명하지 못했던 패턴을 설명하고, 새로운 측정방법을 만들고, 다른 데이터에서도 예상한 관계가 반복해서 관찰된다면 지식계의 경계는 실제로 움직인다.
AI에도 같은 기준을 적용할 수 있다.
인간의 해석 ≠ AI의 해석
이라는 사실만으로 새로운 지식이 생기지는 않는다. AI는 얼마든지 그럴듯하지만 근거 없는 관점을 만들어낼 수 있다.
그 차이가 기존 이론이 놓친 변수를 드러내거나, 서로 분리되어 있던 연구 전통을 연결하거나, 지금까지 보이지 않았던 boundary condition을 제안하고, 실제 자료를 다시 읽었을 때 설명력이 생긴다면 그때부터 새로운 지식의 후보가 된다.
최근 history, philosophy, sociology of science에서 LLM의 활용을 검토한 Simons, Zichert, Wüthrich는 LLM이 방대한 비정형 텍스트에서 의미 있는 관계를 탐색하면서 close reading과 corpus-scale analysis 사이의 간극을 줄일 가능성을 논의한다. 동시에 모델 선택 자체가 해석적 trade-off를 포함하고, LLM의 출력은 탐색적 prompt가 될 수도 있고 더 엄격한 검증을 거쳐야 하는 evidence가 될 수도 있다고 구분한다.[^8]
이 구분이 중요하다. 사회과학에서 해석이 지식생산의 일부라고 해서 모든 해석이 같은 지위를 갖는 것은 아니다.
AI가 낯선 해석을 제시했다는 것과, 그 해석이 실제 사회에 대해 더 나은 설명을 제공한다는 것은 별개의 단계다.
AI가 새로운 관찰자가 아니라 기존 관점을 평균내는 기계가 될 가능성도 있다
여기까지의 논리를 낙관적으로만 밀어붙이면 “관점이 다른 AI를 많이 만들수록 지식이 늘어난다”는 결론에 도달하기 쉽다. 현재의 근거는 오히려 그 반대 가능성도 보여준다.
Messeri와 Crockett은 2024년 Nature에서 AI가 과학자의 생산성과 객관성을 높일 것이라는 기대가 오히려 illusion of understanding을 만들 수 있다고 지적했다. AI가 제공하는 매끄러운 결과 때문에 연구자가 자신이 실제보다 더 많이 이해한다고 느끼거나, 많은 연구자가 유사한 AI 도구와 방식에 의존하면서 연구 질문과 방법이 좁아지는 ‘scientific monoculture’가 생길 수 있다는 문제다.[^9]
사회과학에서는 더 직접적인 경고도 있다. 국내에서 LLM 기반 설문을 검토한 김란우는 모델이 사회구조의 영향을 과대평가할 수 있고, 특정 사회에서만 성립하는 사회적 사실의 제한된 보편성을 제대로 반영하기 어렵고, LLM 자체가 사회적으로 만들어지고 규범적으로 조정된 산물이라는 점을 한계로 지적했다.[^10]
2026년 PNAS에 발표된 SSDataBench도 15개 LLM이 실제 사회조사의 통계적 패턴을 얼마나 재현하는지 비교하면서, 평가된 조건에서 모델들이 현실의 이질성을 충분히 복원하지 못하고 ‘전형적’인 패턴 쪽으로 과도하게 수렴하는 경향을 보고했다.[^11]
이 결과들은 AI를 인간 바깥의 독립적 관찰자라고 너무 빨리 부르면 안 되는 이유다.
AI는 인간 지식계의 경계를 가로지를 수 있지만, 동시에 그 경계들을 하나의 평균적인 표현공간으로 압축할 수도 있다. 여러 학문과 문화의 차이를 연결하는 능력과 그 차이를 평탄화하는 능력은 같은 모델 안에 공존한다.
그래서 AI의 epistemic value를 “얼마나 많은 지식을 가지고 있는가”로만 평가하면 중요한 부분을 놓친다.
더 중요한 질문은 서로 다른 지식계의 차이를 얼마나 보존한 채 연결할 수 있는가다.
인간과 AI 사이의 해석 차이는 ‘지식’보다 먼저 새로운 관찰점을 만든다
처음의 질문으로 돌아가보자.
인간과 AI가 같은 자료를 보고 서로 다른 해석을 내놓는다면 새로운 지식이 생긴 것일까.
현재로서는 이렇게 답하는 편이 가장 정확해 보인다.
아직 아니다. 그러나 새로운 지식이 시작되는 위치일 수 있다.
인간은 자신의 전문분야와 삶의 경험, 사회적 위치를 통해 세계를 본다. AI는 방대한 인간 기록을 압축한 표현공간과 계산구조를 통해 같은 자료를 본다. 양쪽 모두 완전히 중립적이지 않고, 양쪽 모두 자신이 보지 못하는 영역이 있다.
두 관찰이 다를 때 중요한 것은 어느 쪽을 즉시 정답으로 정하는 일이 아니다.
왜 달라졌는지를 보는 것이다.
AI가 인간이 당연하게 받아들인 변수 사이에서 낯선 관계를 찾았는가. 인간은 AI가 맥락 없이 합친 두 현상을 실제 경험과 제도적 지식 때문에 분리하고 있는가. AI가 여러 분야의 문헌을 가로지르면서 기존 학문의 경계를 넘어선 질문을 만들었는가. 아니면 단지 학습 데이터의 평균적 서사를 더 매끄럽게 반복하고 있는가.
그 차이를 설명할 수 있게 되는 순간 우리는 기존 계의 경계를 처음으로 바깥에서 볼 수 있다.
이 점에서 AI의 가장 흥미로운 역할은 ‘모든 것을 아는 지성’이 아닐 수 있다.
오히려 인간이 만든 여러 지식계를 한꺼번에 통과하면서, 각 계 안에서는 너무 당연해서 보이지 않던 전제를 낯설게 만드는 합성 관찰자에 가깝다.
새로운 자연과학적 사실은 결국 새로운 관측과 실험을 요구한다. 새로운 사회과학적 해석도 기존 자료와 현실을 더 잘 설명한다는 검증을 거쳐야 한다. AI는 이 과정을 면제하지 않는다.
다만 질문을 만드는 위치는 바꿀 수 있다.
인간의 지식은 개인의 머리를 넘어 공동체로 확장되었고, 공동체는 전문화되면서 서로 다른 지식계를 만들었다. 그 지식계의 경계가 만나는 곳에서 새로운 질문이 생겨왔다면, AI는 처음으로 여러 경계를 동시에 가로지르는 관찰자를 만들 가능성을 보여준다.
남는 문제는 AI가 인간 지식의 총합을 얼마나 많이 기억하느냐가 아니다.
인간과 AI가 같은 세계를 다르게 읽는 순간, 그 차이 중 무엇을 새로운 지식의 출발점으로 인정할 것인가.
아마 AI 시대의 지식론은 이 질문에서 시작해야 할 것 같다.
Sources
[^1]: Stanford Encyclopedia of Philosophy, Ludwik Fleck. Fleck의 thought collective과 thought style, 집단적 인지에 대한 정리. [^2]: Stanford Encyclopedia of Philosophy, Scientific Revolutions. Kuhn의 후기 disciplinary matrix 개념에 대한 정리. [^3]: Helen E. Longino, Science as Social Knowledge: Values and Objectivity in Scientific Inquiry, Princeton University Press, 1990. [^4]: Susan Leigh Star & James R. Griesemer, “Institutional Ecology, ‘Translations’ and Boundary Objects”, Social Studies of Science 19(3), 1989. [^5]: Mustafa Emirbayer, “Manifesto for a Relational Sociology”, American Journal of Sociology 103(2), 1997. [^6]: Xiaoliang Luo et al., “Large language models surpass human experts in predicting neuroscience results”, Nature Human Behaviour 9, 305–315, 2025. [^7]: Abbi Abdel-Rehim et al., “Scientific hypothesis generation by large language models: laboratory validation in breast cancer treatment”, Journal of the Royal Society Interface 22(227), 2025. [^8]: Arno Simons, Michael Zichert & Adrian Wüthrich, “Large language models for history, philosophy, and sociology of science: Interpretive uses, methodological challenges, and critical perspectives”, Studies in History and Philosophy of Science 117, 2026. [^9]: Lisa Messeri & M. J. Crockett, “Artificial intelligence and illusions of understanding in scientific research”, Nature 627, 49–58, 2024. [^10]: 김란우, 「거대언어모델을 활용한 설문조사의 현재와 한계」, 한국사회학 58(3), 221–239, 2024. [^11]: “Evaluating the statistical realism of LLM-generated social science data”, Proceedings of the National Academy of Sciences, 2026.
- Ludwik Fleck — Stanford Encyclopedia of Philosophy
- Scientific Revolutions — Stanford Encyclopedia of Philosophy
- Helen Longino, Science as Social Knowledge
- Mustafa Emirbayer, Manifesto for a Relational Sociology
- Star & Griesemer, Institutional Ecology, Translations and Boundary Objects
- Luo et al., Large language models surpass human experts in predicting neuroscience results
- Abdel-Rehim et al., Scientific hypothesis generation by large language models
- Messeri & Crockett, Artificial intelligence and illusions of understanding in scientific research
- Simons, Zichert & Wüthrich, Large language models for history, philosophy, and sociology of science
- 김란우, 거대언어모델을 활용한 설문조사의 현재와 한계
- Evaluating the statistical realism of LLM-generated social science data