AI 에이전트가 실제 업무를 많이 처리하기 시작하면 사람의 역할은 줄어드는 것처럼 보인다. 고객지원 에이전트가 문의 대부분을 해결하고, 코딩 에이전트가 PR을 쏟아내며, 업무 에이전트가 예약·환불·계약 같은 프로세스에 들어가면 사람이 직접 손대야 하는 건수는 분명 줄어들 수 있다.
그런데 자동화율이 높아질수록 새로운 병목이 생긴다. 에이전트가 애매한 순간마다 사람을 불러 세우고, 그 답이 올 때까지 전체 작업을 붙잡고 있다면 사람의 응답시간이 시스템 처리량의 상한이 된다. AssemblyAI가 2026년 AI Engineer World's Fair에서 소개한 지원 에이전트 Joey도 이 문제를 잘 보여준다. 공식 세션 설명에 따르면 초기 외부 봇의 end-to-end 해결률은 약 10%였고, 자체 에이전트로 바꾼 뒤 약 75%까지 올라갔다.[^1] 중요한 것은 75%라는 숫자보다 나머지 25%를 어떻게 다루느냐다.
그래서 human-in-the-loop의 다음 문제는 “사람을 넣을까 말까”에서 끝나지 않는다. 사람이 필요한 예외를 다른 정상 작업과 분리하고, 상태를 잃지 않은 채 비동기로 기다리며, 판단에 필요한 증거만 묶어 전달한 뒤, 답이 오면 정확히 그 지점부터 다시 실행하는 구조가 필요하다. 사람은 매 단계의 승인자가 아니라 고위험·고불확실성 예외를 처리하는 비동기 큐에 가까워진다.
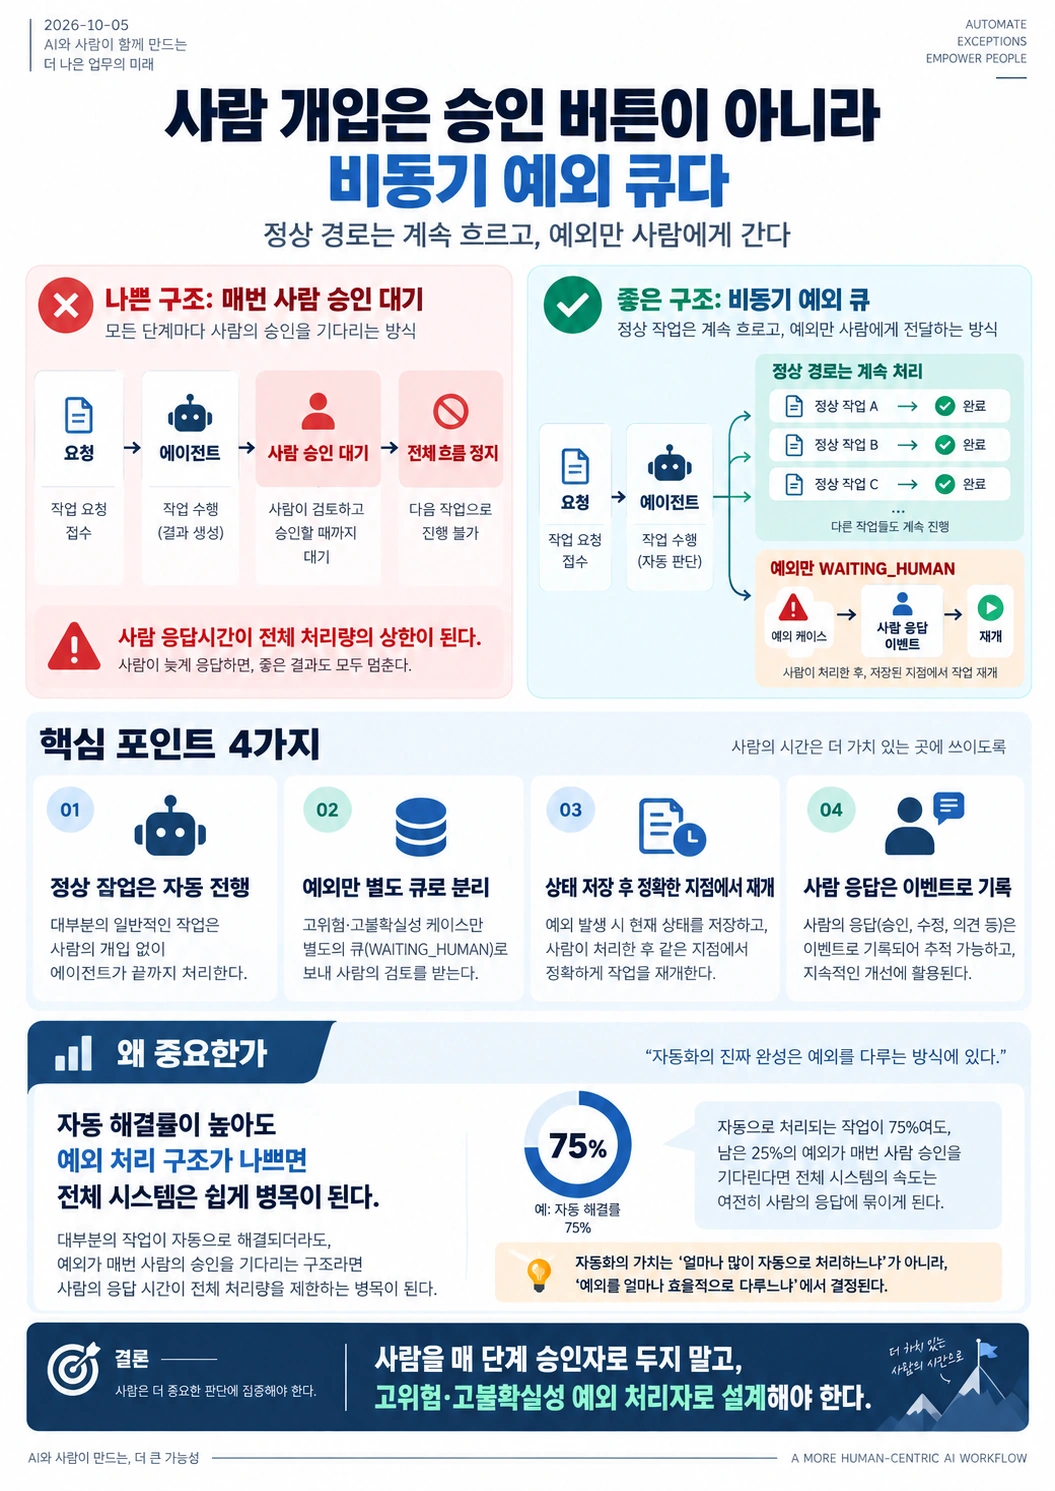
사람이 필요하다고 해서 전체 워크플로가 멈춰야 하는 것은 아니다
전통적인 프로그램에서 사람의 답을 기다리는 가장 단순한 방법은 요청을 보내고 응답이 올 때까지 다음 줄로 넘어가지 않는 것이다.
짧은 웹 요청이라면 괜찮다. 하지만 실제 업무에서 사람의 응답은 200밀리초가 아니라 몇 분, 몇 시간, 때로는 며칠 뒤에 온다. 승인자가 회의 중일 수도 있고, 법무 검토가 필요할 수도 있으며, 고객이 추가 자료를 보내야 할 수도 있다.
이때 에이전트 프로세스 자체를 붙잡고 기다리면 문제가 생긴다. 실행환경이 재시작될 수 있고, 메모리에만 있던 상태가 사라질 수 있으며, 같은 요청을 다시 실행해 중복 작업을 만들 수도 있다. 더 나쁜 경우 한 건의 예외가 같은 worker나 workflow에 묶인 다른 정상 작업까지 늦춘다.
Temporal이 최근 AI agent reference architecture에서 제시하는 패턴은 이 문제를 정면으로 다룬다. workflow.wait_condition으로 응답을 기다리면 workflow 상태는 지속되지만 worker thread를 계속 점유하지 않는다. 새 메시지나 승인 신호가 오면 그 이벤트가 기존 workflow에 들어가고, 중단된 지점에서 다시 실행한다.[^2]
OpenAI Agents SDK의 현재 approval lifecycle도 유사한 구조다. 검토가 필요한 tool call이 생기면 실행을 강행하지 않고 interruption과 재개 가능한 state를 반환한다. 사람의 검토가 오래 걸릴 수 있으면 이 state를 저장해뒀다가 나중에 같은 run을 이어서 재개하도록 안내한다.[^3]
핵심은 단순하다.
사람에게 질문
→ 프로세스 전체를 붙잡고 대기
가 아니라,
예외 발생
→ 상태 저장
→ 해당 건만 WAITING_HUMAN
→ 다른 작업은 계속
→ 사람의 응답을 이벤트로 기록
→ 원래 상태에서 재개
가 되어야 한다.
human-in-the-loop에는 사실 두 개의 다른 문제가 있다
사람 개입을 이야기할 때 흔히 한 질문으로 묶지만, 실제로는 두 단계가 다르다.
첫 번째는 언제 사람에게 넘길 것인가다.
오답의 비용이 얼마나 큰지, 실행 후 되돌릴 수 있는지, 권한이 충분한지, 모델의 확신이 어느 정도인지 보고 Act·Confirm·Stop/Handoff 같은 정책을 정할 수 있다. 송금이나 계정삭제처럼 실패비용이 큰 작업에는 더 높은 문턱을 둘 수 있다.
두 번째는 사람에게 넘긴 뒤 시스템이 어떻게 기다리고 다시 시작할 것인가다.
이 단계는 모델의 confidence 문제와 다르다. 사람이 필요하다는 판정이 이미 끝난 뒤의 distributed-systems 문제다. 어떤 상태를 저장할지, 누가 답해야 하는지, 답이 늦으면 어떻게 할지, 중간에 서비스가 재시작되면 무엇을 복구할지, 같은 승인이 두 번 들어오면 어떻게 막을지 결정해야 한다.
이 구분이 중요한 이유는 첫 번째만 잘 설계해도 두 번째가 나쁘면 자동화의 경제성이 무너질 수 있기 때문이다.
예를 들어 에이전트가 95%의 업무를 스스로 처리하더라도 나머지 5%가 매번 전체 batch를 멈추고 사람 한 명의 Slack 답변을 기다린다면 처리량은 그 사람의 inbox 속도에 묶인다. 반대로 자율처리율이 75%여도 25%의 예외가 독립된 큐에서 병렬로 처리되고 나머지 업무가 계속 진행된다면 시스템 전체의 throughput은 훨씬 높을 수 있다.
따라서 자동화율 하나만으로 에이전트 운영을 평가하면 중요한 부분을 놓친다.
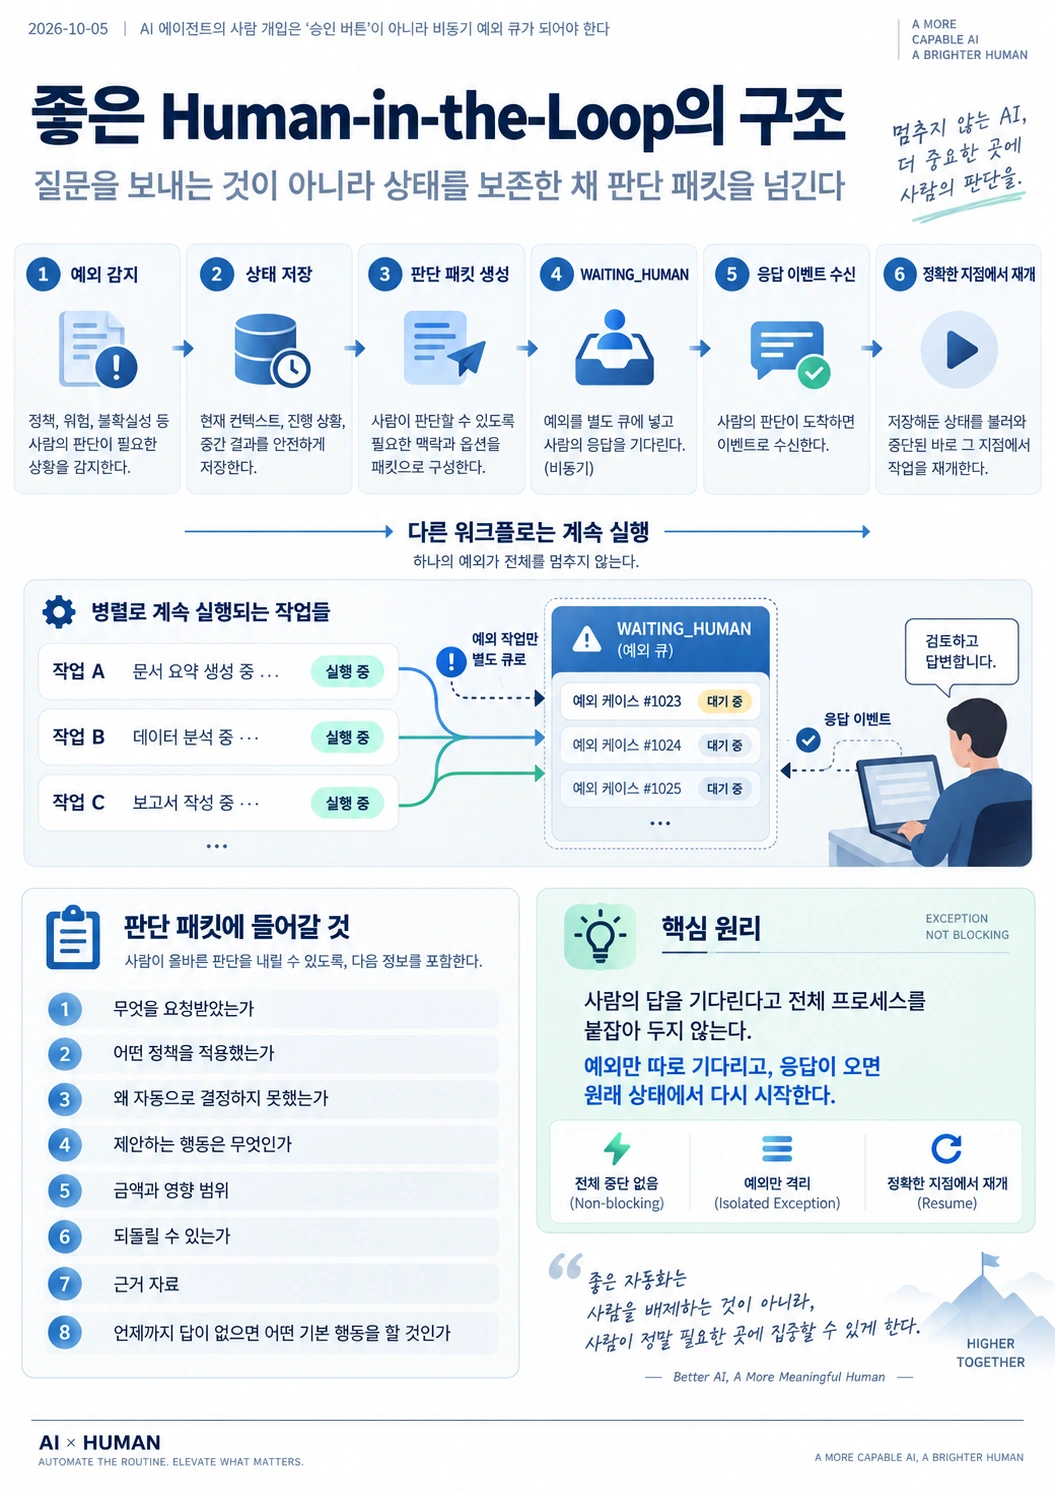
좋은 예외 큐는 질문만 보내지 않고 ‘판단 패킷’을 보낸다
사람에게 예외를 넘기는 순간에도 품질 차이가 크다.
나쁜 handoff는 이런 식이다.
이 요청을 승인할까요?
이 메시지를 받은 사람은 다시 원래 대화를 읽고, 정책을 찾고, 고객 상태를 확인하고, 에이전트가 무엇을 하려는지 재구성해야 한다. 자동화가 줄인 작업을 사람이 다시 조사하는 셈이다.
좋은 handoff는 판단에 필요한 정보를 미리 좁혀 보낸다.
예를 들어 고객 환불이라면 최소한 다음이 필요할 수 있다.
- 무엇을 요청받았는가.
- 에이전트가 어떤 정책을 적용했는가.
- 왜 자동으로 결정하지 못했는가.
- 제안하는 행동은 무엇인가.
- 금액과 영향 범위는 얼마인가.
- 실행 후 되돌릴 수 있는가.
- 어떤 근거 자료를 확인했는가.
- 언제까지 답이 없으면 어떤 기본 행동을 할 것인가.
코드 리뷰에서도 같은 구조가 나타난다.
Matt Pocock은 최근 AI Engineer 발표에서 에이전트가 PR을 만드는 속도가 사람의 리뷰속도보다 빨라지면, 사람을 더 빨리 읽게 만드는 것보다 사람에게 오기 전에 자동 체크와 자동 리뷰를 쌓는 편이 낫다고 주장했다. 마지막 사람 리뷰는 모든 diff를 똑같이 읽는 대신 되돌리기 어려운 one-way door와 큰 blast radius에 집중하도록 설계한다.[^4]
이 관점에서 human-in-the-loop의 핵심 산출물은 질문이 아니다.
사람이 짧은 시간 안에 위험을 판단할 수 있도록 압축된 예외 패킷이다.
모든 예외를 FIFO로 처리하면 인간의 희소한 시간이 낭비된다
예외가 충분히 많아지면 사람의 inbox는 queue가 된다. 그때부터는 어떤 건부터 볼 것인지가 시스템 설계의 일부가 된다.
가장 단순한 방식은 먼저 들어온 순서대로 처리하는 FIFO다. 하지만 업무 위험은 균등하지 않다.
고객에게 잘못된 제품 설명을 한 건과 10만 달러 계약조건을 바꾸는 건은 다르다. 내부 문서의 문구 수정과 production 데이터 마이그레이션도 다르다. 5분 뒤 자동으로 만료되는 승인과 이틀 뒤 처리해도 되는 정책질문도 다르다.
따라서 human queue의 우선순위는 대략 다음 요소를 반영해야 한다.
우선순위
≈ 실패비용
× 비가역성
× 영향범위
× 시간민감도
정확한 수식으로 사용할 필요는 없다. 중요한 것은 “에이전트가 물어봤으니 사람이 순서대로 답한다”가 아니라, 인간 attention 자체를 위험에 맞게 배분해야 한다는 점이다.
Temporal의 AI engineering pattern도 human approval을 단순 무기한 대기가 아니라 timeout과 default action을 가진 decision point로 다룬다. 응답이 없을 때 무조건 실행하는지, 안전하게 중단하는지, 상위 승인자로 escalate하는지는 업무별로 정할 수 있다.[^5]
사람의 판단도 SLA를 갖는 서비스처럼 설계해야 하는 이유다.
자동화의 진짜 단위원가는 ‘자율 처리율’보다 예외율 × 처리시간에 가깝다
고객지원 에이전트가 문의의 75%를 스스로 해결한다는 수치는 직관적으로 강하다. 하지만 인력과 비용을 계산하려면 한 단계 더 들어가야 한다.
예를 들어 하루 10,000건의 요청 중 25%가 사람에게 넘어간다면 2,500건이다. 이때 사람 한 명이 예외 한 건을 평균 30초에 처리하는 시스템과 15분 동안 원문·정책·로그를 다시 조사해야 하는 시스템은 같은 75% 자동화가 아니다.
개념적으로 사람의 작업량은 다음 세 요소에 크게 좌우된다.
Human workload
≈ 전체 요청량
× escalation rate
× exception handling time
여기에 queue wait와 재에스컬레이션, 잘못된 자동분류에서 생긴 복구비용이 더해진다.
그래서 agent KPI는 autonomous resolution rate에서 끝나면 안 된다. 적어도 다음 지표를 함께 보는 편이 낫다.
| 지표 | 무엇을 보는가 |
|---|---|
| Escalation rate | 전체 요청 중 사람이 필요한 비중 |
| Human handling time | 사람이 예외 하나를 판단하는 실제 시간 |
| Queue wait time | 예외가 사람에게 도착한 뒤 결정까지 걸린 시간 |
| Resume success rate | 사람 응답 뒤 원래 workflow가 정상 재개되는 비율 |
| Re-escalation rate | 같은 건이 다시 사람에게 돌아오는 빈도 |
| Exception recurrence | 같은 종류의 예외가 계속 반복되는지 |
| Auto-conversion rate | 반복 예외가 이후 정책·도구·자동검사로 흡수되는 비율 |
이 중 마지막 두 개가 특히 중요하다.
사람이 매일 같은 예외를 처리한다면 human-in-the-loop가 아니라 미완성 자동화의 수동 운영팀이 된 것이다.
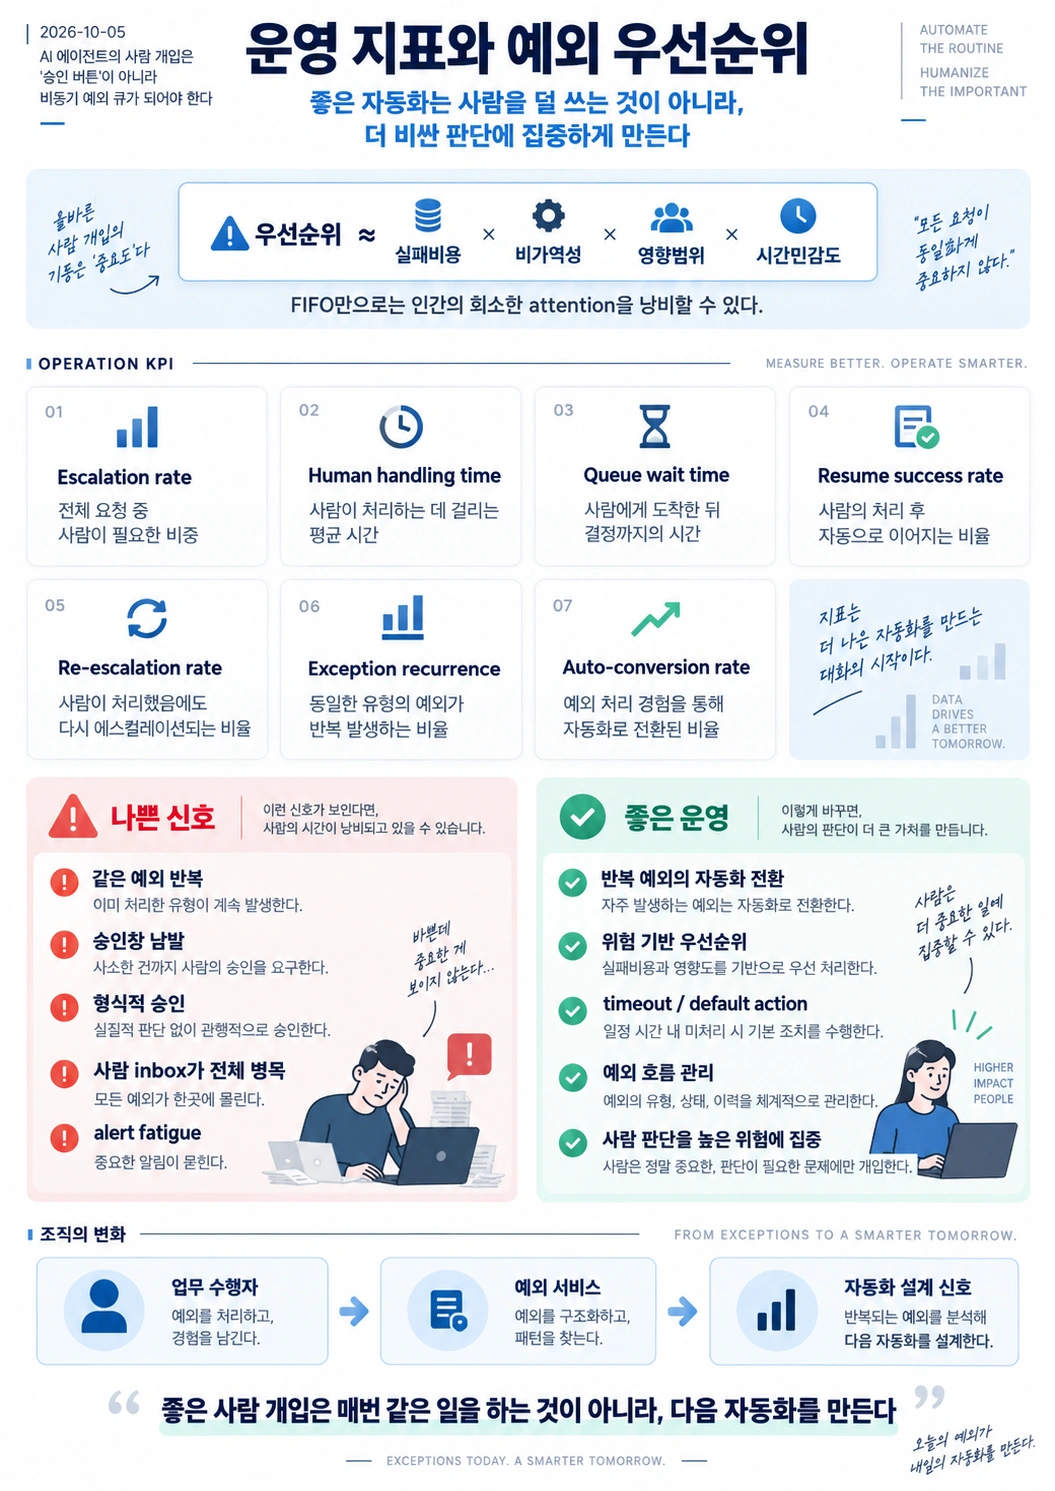
좋은 사람 개입은 매번 같은 일을 하는 것이 아니라 다음 자동화를 만든다
Pocock의 PR review 논리에서 가장 중요한 부분은 사람 리뷰가 그 PR 하나로 끝나지 않는다는 점이다.
사람이 반복해서 같은 문제를 발견한다면 다음 run에서는 그 문제가 사람에게 오기 전에 잡혀야 한다. lint rule로 만들 수 있으면 자동 체크로, 코드구조 문제라면 reviewer rule로, 정보 부족이라면 agent instruction이나 context navigation으로 옮긴다.[^4]
고객지원도 마찬가지다.
AssemblyAI의 Joey 사례에서 계약, 법무, 가격과 같은 일부 요청은 사람에게 넘어갔다. 여기서 모든 에스컬레이션을 실패로 볼 필요는 없다. 회사의 권한이나 정책상 사람이 판단해야 하는 질문도 있다.
다만 같은 이유의 예외가 반복된다면 두 가지 중 하나다.
첫째, 실제로 human authority가 필요한 고유한 판단이다.
둘째, 아직 정책·도구·데이터가 에이전트에게 노출되지 않아 사람이 대신 메우고 있다.
이 둘을 구분해야 한다.
두 번째 유형이라면 exception queue는 product backlog의 센서가 된다. 어떤 정책을 구조화해야 하는지, 어떤 API가 필요한지, 어떤 데이터가 누락됐는지 보여준다.
이때 사람 개입은 비용이면서 동시에 다음 자동화의 training signal이 아니라 engineering signal이 된다. “모델을 더 학습시키자”보다 “어떤 반복 예외를 workflow로 흡수할 수 있는가”를 묻는 편이 실용적일 수 있다.
오래 기다리는 업무일수록 durable state가 중요해진다
사람의 판단이 30초 안에 끝나는 업무만 생각하면 별도 상태관리의 가치를 과대평가하기 쉽다.
하지만 enterprise workflow에는 대기가 길다.
계약서는 법무팀이 하루 뒤 답할 수 있다. 보험 청구는 추가 서류가 필요할 수 있다. 구매승인은 예산권자가 출장에서 돌아온 뒤 처리될 수 있다. 채용이나 의료업무처럼 여러 명의 판단이 순차적으로 필요한 경우도 있다.
Temporal은 2026년 agentic AI 사례를 설명하면서 long-running agent가 며칠이나 몇 주 동안 state를 잃지 않고 실행할 수 있어야 한다고 강조한다.[^6] OpenAI의 approval guide 역시 검토가 오래 걸리는 경우 state를 직렬화해 저장하고 나중에 같은 run을 이어갈 수 있도록 한다.[^3]
이런 구조에서는 workflow의 상태가 단순한 대화 history가 아니다.
현재 단계
+ 이미 실행한 side effect
+ 아직 실행하지 않은 action
+ 승인 요청자
+ 승인 권한자
+ 판단 근거
+ timeout
+ resume token/state
+ 중복 실행 방지 정보
가 함께 필요하다.
사람이 답을 했을 때 “무슨 일이었지?”부터 다시 재구성하면 durable workflow가 아니다.
alert fatigue는 안전장치를 무력화할 수 있다
human-in-the-loop를 많이 넣는 것이 항상 더 안전한 것도 아니다.
에이전트가 조금만 불확실해도 모든 작업을 사람에게 물어보면 처음에는 안전해 보인다. 시간이 지나면 사람은 매번 같은 승인창을 누르게 된다. 질문을 읽지 않고 승인하는 비율이 높아지면 형식적인 human gate만 남는다.
보안에서 경고가 너무 많으면 중요한 alert를 놓치는 것과 같은 문제다.
그래서 좋은 human-in-the-loop는 사람 개입 횟수를 최대화하는 구조가 아니다. 사람이 개입할 때 그 판단이 실제로 정보가치를 갖게 만드는 구조다.
이를 위해서는 세 가지가 필요하다.
첫째, 낮은 위험의 반복작업은 가능한 한 자동 검증으로 내려보낸다.
둘째, 사람이 필요한 경우에는 판단근거와 영향범위를 미리 준비한다.
셋째, 사람이 내린 판단을 기록해 다음부터 같은 질문을 줄일 수 있는지 검토한다.
자동화의 목표를 “사람 0명”으로 잡으면 위험한 행동까지 무리하게 자동화할 수 있다. 반대로 “모든 중요한 행동은 사람이 승인”으로 잡으면 사람을 throughput bottleneck으로 만든다.
더 현실적인 목표는 사람의 판단을 가장 비싼 예외에만 쓰는 것이다.
조직도 사람을 ‘업무 수행자’보다 ‘예외 서비스’로 배치하게 될 수 있다
이 구조가 확산되면 조직의 역할설계도 조금 달라질 수 있다.
과거 운영팀은 요청을 처음부터 끝까지 처리했다. 자동화 이후에는 대부분의 정상경로가 시스템을 통과하고, 사람은 정책 바깥의 예외나 큰 위험, 새로운 유형의 문제에 집중한다.
이때 팀의 생산성을 단순히 “사람 한 명이 하루 몇 건 처리하는가”로 측정하기 어렵다. 오히려 어떤 예외를 맡는지, 결정을 얼마나 빨리 내리는지, 그 예외를 다시 시스템의 규칙으로 환원하는지가 중요해진다.
manager의 역할도 비슷하다.
에이전트가 많은 업무를 수행하면 manager가 모든 output을 다시 읽는 방식은 확장되지 않는다. manager는 어떤 risk class가 사람에게 와야 하는지, 누가 어떤 예외를 결정할 권한이 있는지, unresolved queue가 어디에 쌓이는지, 같은 예외가 반복되는지를 관리하는 쪽으로 이동할 수 있다.
결국 AI가 조직을 자동화할수록 사람은 덜 중요해지는 것이 아니라 더 희소한 판단자원이 된다.
희소한 자원은 queueing과 priority 없이 운영하면 가장 먼저 병목이 된다.
이 구조가 필요하지 않은 경우도 있다
모든 human-in-the-loop를 비동기 예외 큐로 만들 필요는 없다.
업무량이 적고 한 번의 실패비용이 매우 큰 경우에는 사람이 매번 synchronous gate를 거치는 편이 합리적일 수 있다. 원전 제어, 대규모 자금이체, 되돌릴 수 없는 데이터 삭제처럼 throughput보다 안전이 훨씬 중요한 작업이 그렇다.
반대로 사람이 거의 즉시 답할 수 있고 workflow 상태가 단순하다면 durable orchestration을 추가하는 비용이 이득보다 클 수 있다. 모든 승인에 복잡한 workflow engine을 붙이는 것은 과잉설계다.
또 에이전트 자체의 신뢰도가 크게 올라가 escalation rate가 사실상 0에 가까워지면 human queue의 중요성도 줄어든다.
그래서 이 글의 주장은 “모든 사람 개입은 비동기여야 한다”가 아니다.
에이전트가 많은 요청을 병렬로 처리하고, 사람의 응답시간이 모델의 실행시간보다 훨씬 길며, 일부 업무만 사람의 판단을 필요로 하는 환경에서는 human-in-the-loop를 synchronous approval이 아니라 durable async exception architecture로 설계해야 한다는 것이다.
AI 에이전트의 자율성이 높아질수록 이 구분은 더 중요해질 가능성이 높다.
사람을 없애는 것이 목표가 아니다.
사람이 필요한 순간에도 나머지 시스템이 멈추지 않게 만드는 것이 목표다.
[^1]: AI Engineer World's Fair 2026, “FDE Playbook: Build an AI Support Agent and Give It a Voice,” Matt Lawler, July 1, 2026. https://aie-wf.sentry.dev/talks/aiewf-347-fde-playbook-build-an-ai-support-agent-and-give- [^2]: Temporal Platform Hub, “AI Agent Reference Architecture,” accessed October 5, 2026. https://go.temporal.io/platform-hub/ai-engineering/ai-reference-architecture [^3]: OpenAI API, “Guardrails and human review,” accessed October 5, 2026. https://developers.openai.com/api/docs/guides/agents/guardrails-approvals [^4]: AI Engineer, “Fixing the PR Bottleneck — Matt Pocock, AIHero,” accessed October 5, 2026. https://ai.engineer/talks/LlgiOCmFG_w-fixing-pr-bottleneck [^5]: Temporal Platform Hub, “AI Engineering Patterns — Human-in-the-loop approval gate,” accessed October 5, 2026. https://go.temporal.io/platform-hub/ai-engineering/ai-patterns [^6]: Temporal, “Temporal Raises $300M Series D to Make Agentic AI Real for Companies,” February 17, 2026. https://temporal.io/news/temporal-raises-300M-to-make-agentic-ai-real-for-companies